इस लेख में, आप सीखेंगे कि रेल्स में डेटाबेस प्रदर्शन कैसे टेस्ट करें और कुछ सबसे आम डेटाबेस प्रदर्शन मुद्दों को हल करें।
जब आप एक रेल्स एप्लिकेशन विकसित करते हैं, तो ActiveRecord आपका डेटाबेस प्रबंधित करने वाला डिफ़ॉल्ट टूल है। ActiveRecord .where, .save, .create, और .update जैसे कमांड का उपयोग करके डेटा क्वेरी और इन्सर्ट करने के लिए एक आसान और तेज़ इंटरफ़ेस प्रदान करता है। रेल्स इन कमांड्स को SQL क्वेरी में बदलने का काम करता है, जो एक अच्छी बात है, लेकिन कभी-कभी प्रदर्शन मुद्दों का कारण बन सकता है। यह महत्वपूर्ण है कि आप कुछ सामान्य मुद्दों को समझें और प्रदर्शन को कैसे ऑप्टिमाइज़ करें।
रूबी ऑन रेल्स में ActiveRecord पर एक त्वरित नोट
रेल्स ActiveRecord मॉडल-व्यू-कंट्रोलर (MVC) में एक लेयर है जो इसे एक बिजनेस ऑब्जेक्ट के रूप में प्रस्तुत करके आपके डेटाबेस का प्रबंधन करता है। ActiveRecord पैटर्न ORM तकनीक का उपयोग करके एप्लिकेशन के ऑब्जेक्ट्स को रिलेशनल डेटाबेस टेबल मैनेजमेंट सिस्टम से जोड़ता है।
अब, चलिए शुरू करते हैं!
रेल्स में डेटाबेस प्रदर्शन मुद्दों की पहचान और टेस्ट करने के 3 तरीके
1. ActiveRecord क्वेरीज़ पर Explain चलाएं
एक एक्सप्लेन स्टेटमेंट एक SQL क्वेरी के निष्पादन योजना के बारे में जानकारी प्रदर्शित करता है - क्वेरी कैसे निष्पादित होगी, जिसमें कितनी पंक्तियों को स्कैन किया जाएगा, किस इंडेक्स का उपयोग किया जाएगा, और टेबल्स कैसे जॉइन की जाएंगी।
निष्पादन योजना हमें यह पता लगाने में मदद करती है कि क्वेरी निष्पादन को क्या धीमा करता है:
- कौन सा इंडेक्स जोड़ने से क्वेरी के प्रदर्शन में सुधार होगा।
- यदि टेबल्स इष्टतम क्रम में जॉइन की गई हैं। आप बेहतर प्रदर्शन के लिए जॉइन स्टेटमेंट में टेबल ऑर्डर को मजबूर करने के लिए
STRAIGHT_JOINका उपयोग कर सकते हैं।
Explain SELECT, DELETE, INSERT, REPLACE और UPDATE स्टेटमेंट्स पर भी काम करता है।
ActiveRecord के साथ explain का उपयोग करना बहुत सीधा है। निम्न दर्ज करें:
कमांड के अंत में .explain जोड़ने से ActiveRecord कमांड्स के लिए क्वेरी प्लान प्रदान होता है। उपरोक्त उदाहरण एक बहुत ही सरल क्वेरी है जो टेबल को क्वेरी करने के लिए id (प्राइमरी की) का उपयोग करता है। explain स्टेटमेंट का आउटपुट दिखाता है कि यह pkey का उपयोग कर रहा है। इससे, आप सुनिश्चित हो सकते हैं कि स्टेटमेंट इष्टतम और तेज़ है।
आप अपने धीमे क्वेरीज़ में .explain कमांड जोड़कर निष्पादन क्रम, साथ ही उपयोग किए गए इंडेक्स को उजागर कर सकते हैं। यदि क्वेरी प्लान Seq Scan दिखाता है, तो इंडेक्स का उपयोग नहीं किया जा रहा है और इसके लिए क्वेरी परिवर्तन या एक नया इंडेक्स जोड़ने की आवश्यकता है।
जॉइन के साथ एक और उदाहरण यहां है:
यहां, यूजर टेबल को कोलैबोरेशन टेबल के साथ जोड़ा गया है। जब आप क्वेरी प्लान में देखते हैं, तो कोलैबोरेशन टेबल seq scan का उपयोग कर रही है और पहले निष्पादित हो रही है - जबकि यूजर टेबल pkey इंडेक्स का उपयोग कर रही है और बाद में निष्पादित हो रही है। आप कोलैबोरेशन टेबल में user_id कॉलम पर एक इंडेक्स जोड़कर इस क्वेरी को ऑप्टिमाइज़ कर सकते हैं। Explain क्वेरी को तोड़ने में मदद करता है, ताकि आप पता लगा सकें कि ऑप्टिमाइज़ेशन कहां आवश्यक है।
2. प्रमुख डेटाबेस मेट्रिक्स मापें
क्वेरी समय यह देखने के लिए एकमात्र मीट्रिक नहीं है कि क्वेरी प्रदर्शनकारी है या नहीं - कई अन्य डेटाबेस मेट्रिक्स देखें, जिनमें शामिल हैं:
- CPU उपयोग
- मेमोरी उपयोग
- प्रतीक्षा IO के लिए डिस्क क्यू
- इनबाउंड और आउटबाउंड ट्रैफिक के लिए नेटवर्क बैंडविड्थ
- उपलब्ध डिस्क स्थान
- थ्रूपुट
जब ये मेट्रिक्स एक निश्चित सीमा से अधिक हो जाते हैं तो क्वेरी धीमी हो सकती है। आपको प्रदर्शन मुद्दों को समझने के लिए एक समय सीमा में एक डेटा पॉइंट को देखना होगा।
मापने के लिए आवश्यक डेटा पॉइंट बहुत सारे कारकों पर निर्भर करता है, जैसे:
-
डेटाबेस प्रकार:
- रिलेशनल
- इन-मेमोरी
- नो-SQL
- डेटा-वेयरहाउस
-
सर्वर कैसे होस्ट किया गया है:
- ऑन-प्रिमाइसेस
- क्लाउड पर
डेटाबेस मेट्रिक्स की निगरानी का कोई एक तरीका नहीं है - यह विभिन्न कारकों पर निर्भर करता है।
3. AppSignal का उपयोग करके रेल्स ऐप प्रदर्शन मापें
केंद्रीय स्थान के बिना अपने सभी प्रदर्शन मेट्रिक्स को प्रबंधित करना मुश्किल हो सकता है जो आपको सभी क्वेरीज़ पर दृश्यता देता है। हर कोड ब्लॉक में प्रदर्शन कोड जोड़ना बोझिल और अनमैनेजेबल हो सकता है।
AppSignal जैसे टूल्स के साथ, आप अपने एप्लिकेशन में प्रदर्शन माप को आसानी से एकीकृत कर सकते हैं। AppSignal रेल्स को बॉक्स से बाहर सपोर्ट करता है। सरल AppSignal इंस्टॉलेशन प्रक्रिया के बारे में 'AppSignal for Ruby' डॉक्यूमेंटेशन से जानें।
नजर रखने के लिए कुछ महत्वपूर्ण मेट्रिक्स हैं:
- धीमी क्वेरीज़
- थ्रूपुट के आधार पर डेटाबेस प्रदर्शन
- N+1 क्वेरीज़
- डेटाबेस लेटेंसी
- सक्रिय कनेक्शन की संख्या
यहां बताया गया है कि AppSignal डैशबोर्ड कैसा दिख सकता है:
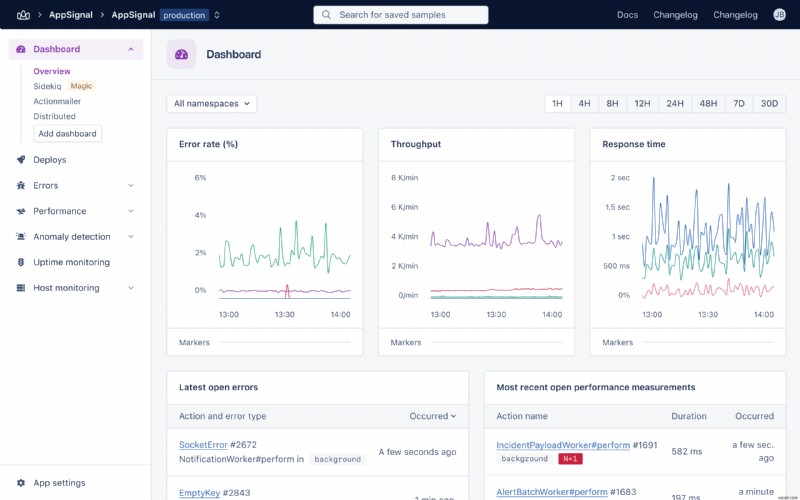
रूबी ऑन रेल्स डेटाबेस प्रदर्शन को ऑप्टिमाइज़ करने के 7 तरीके
1. N+1 क्वेरीज़ के लिए ईगर लोडिंग
N+1 क्वेरीज़ सबसे आम डेटाबेस प्रदर्शन समस्या हैं। आइए एक N+1 क्वेरी का उदाहरण देखें जहां आपके दो मॉडल हैं - यूजर और प्रोजेक्ट:
अब, यदि आप यूजर और प्रोजेक्ट नाम ढूंढना चाहते हैं, तो निम्न कोड चलाएं:
उपरोक्त कोड प्रत्येक लूप के साथ डेटाबेस को क्वेरी करेगा और प्रदर्शन मुद्दों का कारण बनेगा। निष्पादित क्वेरीज़ की कुल संख्या यूजर्स की संख्या + 1 होगी।
इस मुद्दे को खत्म करना बहुत सरल है: एसोसिएशन को ईगर लोड करें। बस क्वेरी के अंत में .includes(:projects) जोड़ें:
अब, लूप को निष्पादित करने से डेटाबेस क्वेरी नहीं होगी, क्योंकि उपरोक्त क्वेरी प्रोजेक्ट्स को ईगर लोड करती है:
रेल्स 6.1 सख्त लोडिंग प्रदान करता है ताकि यह सुनिश्चित हो सके कि एसोसिएशन एक्सेस करने से पहले ईगर लोडेड है। सख्त लोडिंग सक्षम करने के लिए, मॉडल में निम्न लाइन जोड़ें:
अब, जब आप ईगर लोडिंग के बिना प्रोजेक्ट्स तक पहुंचने का प्रयास करते हैं, तो रेल्स ActiveRecord::StrictLoadingViolationError एक्सेप्शन फेंकेगा।
यदि आपके पास रेल्स 6.1 नहीं है, तो आप Bullet जैसे जेम्स का उपयोग कर सकते हैं।
2. डेटाबेस इंडेक्स का उपयोग करें
डेटाबेस डेटा को तेज़ी से पुनर्प्राप्त करने में मदद करने के लिए इंडेक्स प्रदान करते हैं। हमारे द्वारा पहले कवर किए गए एक्सप्लेन कमांड का उपयोग करके, आप यह पता लगा पाएंगे कि क्या क्वेरी उचित इंडेक्स का उपयोग कर रही है।
आप एक धीमी क्वेरी को पहले से मौजूद इंडेक्स या एक अतिरिक्त इंडेक्स का उपयोग करने के लिए बदल सकते हैं जो प्रदर्शन को सुधारने में मदद करता है।
MySQL में चार अलग-अलग प्रकार के इंडेक्स हैं:
- प्राइमरी की - इंडेक्स प्राइमरी की पर ऑटोमैटिकली जोड़ा जाता है, जो यह भी सुनिश्चित करता है कि यह अद्वितीय है
- यूनिक - यूनिक की इंडेक्स सुनिश्चित करता है कि एक एट्रिब्यूट में जोड़े गए आइटम हमेशा अद्वितीय हों
- इंडेक्स - प्राइमरी की के अलावा अन्य एट्रिब्यूट्स पर जोड़ा जाता है
- फुल टेक्स्ट - कैरेक्टर-आधारित डेटा के खिलाफ क्वेरी करने में मदद करता है
एक इंडेक्स B-Tree या Hash फॉर्मेट में स्टोर किया जाता है।
इंडेक्स को सिंगल फील्ड पर जोड़ा जा सकता है या कई फील्ड्स की संरचना के रूप में बनाया जा सकता है। एक कम्पोजिट इंडेक्स कई फील्ड्स शामिल करने वाली क्वेरीज़ को ऑप्टिमाइज़ करने के लिए उपयोगी है। जब केवल एक इंडेक्स उपयोग किया जाता है, तो इसके लिए एक बड़े डेटासेट स्कैन की आवश्यकता होती है।
उदाहरण के लिए, निम्न क्वेरी में, दो फील्ड्स हैं:
"abc" प्रोजेक्ट में बहुत सारे यूजर्स हो सकते हैं और कंट्री फील्ड को स्कैन किया जाएगा। बड़े परिणाम डेटासेट के कारण यह एक धीमी प्रक्रिया हो सकती है। इस मामले में, आप प्रोजेक्ट और कंट्री दोनों फील्ड्स पर एक कम्पोजिट इंडेक्स जोड़कर प्रदर्शन सुधार सकते हैं।
आप निम्न ActiveRecord माइग्रेशन कमांड्स के साथ रेल्स में इंडेक्स जोड़ सकते हैं:
सिंगल इंडेक्स:
कम्पोजिट इंडेक्स:
3. लिमिट्स का उपयोग करें
जितने अधिक रिकॉर्ड लौटाए जाते हैं, प्रदर्शन उतना ही धीमा हो सकता है। एक सिंगल क्वेरी जो बड़ा डेटा सेट लौटाती है, उससे कई क्वेरी करना बेहतर है।
अगले 100 बैच प्राप्त करने के लिए, आप ऑफसेट का उपयोग कर सकते हैं:
यह प्रदर्शन को काफी सुधारेगा। एक बात ध्यान रखें कि उच्च ऑफसेट के साथ, क्वेरी धीमी हो जाती है। ऑफसेट पर एक लिमिट जोड़ें।
4. बड़ी संख्या में आइटम लोड करने के लिए find_each का उपयोग करें
रिकॉर्ड्स पर पुनरावृति करते समय, बेहतर प्रदर्शन के लिए रेल्स में उन्हें बैच करें:
यह एक बार में डेटाबेस में सभी रिकॉर्ड्स को क्वेरी करेगा और मेमोरी और डेटाबेस प्रदर्शन मुद्दों का कारण बनेगा।
find_each या find_in_batches का उपयोग करके उसी ऑपरेशन को बैच में करके प्रदर्शन सुधारने में मदद मिलेगी:
डिफ़ॉल्ट रूप से, find_each 1,000 के बैच में परिणाम क्वेरी करता है। आप इसे आर्गुमेंट के रूप में परिभाषित करके बैच आकार बदल सकते हैं:
आप जिस ऑपरेशन को करने की आवश्यकता है उसके आधार पर find_in_batches का भी उपयोग कर सकते हैं। find_in_batches और find_each के बीच अंतर यह है कि find_in_batches परिणाम को इंडिविजुअल रिकॉर्ड्स के बजाय मॉडल्स की एक सरणी के रूप में देता है।
5. Pluck का उपयोग करके अपने आवश्यक फील्ड का चयन करें
Pluck कमांड सीधे एक क्वेरी के परिणाम को ActiveRecord ऑब्जेक्ट के बजाय एक सरणी में परिवर्तित करता है।
यदि एक क्वेरी बड़े परिणाम लौटाती है, तो Pluck का उपयोग करने से कोड प्रदर्शन में सुधार होगा। Pluck केवल डेटाबेस से एक आवश्यक फील्ड का चयन करेगा:
परिणाम एक इंडेक्स से प्राप्त होता है, मुख्य टेबल से नहीं, और सॉर्ट शामिल करने वाली क्वेरीज़ के साथ अधिक प्रभावी है।
6. बल्क ऑपरेशन का उपयोग करें
बल्क डिलीट ActiveRecord ऑब्जेक्ट पर लूपिंग एक डिलीट ऑपरेशन एक समय में एक रिकॉर्ड डिलीट करेगा:
प्रत्येक रिकॉर्ड को डिलीट करने के लिए डेटाबेस पर कई क्वेरी करने की आवश्यकता होती है। इसके बजाय, एक सिंगल बल्क delete_all क्वेरी का उपयोग करना इष्टतम है:
बल्क क्रिएट कुछ लोगों को यह एहसास नहीं होता कि बल्क डिलीट के समान, आप ActiveRecord के साथ बल्क इन्सर्ट भी कर सकते हैं। यह n क्वेरी की संख्या को केवल एक तक कम कर सकता है। ActiveRecord::Base create मेथड इनपुट के रूप में हैश की एक सरणी स्वीकार करता है:
7. यदि आवश्यक हो तो इन-मेमोरी गणना का उपयोग करें
कुछ उदाहरणों में, क्वेरी करने के बजाय इन-मेमोरी गणना बेहतर होती है। मान लीजिए हम अपने डेटाबेस में उन देशों को ढूंढना चाहते हैं जिनमें यूजर्स का रिकॉर्ड नहीं है:
उपरोक्त क्वेरी को परिणाम प्राप्त करने के लिए N क्वेरी की आवश्यकता होती थी। इसके बजाय, हम दिए गए देशों में यूजर्स को ढूंढने के लिए एक सिंगल क्वेरी लिख सकते हैं और अन्य गणना मेमोरी में कर सकते हैं:
आप कुछ मामलों में रिक्वेस्ट-रिस्पांस साइकिल का पुन: उपयोग करने और डेटाबेस लोड को कम करने के लिए कैश कर सकते हैं। रेल्स तीन प्रकार की कैशिंग तकनीक प्रदान करता है: पेज, एक्शन, और फ्रैगमेंट कैशिंग (फ्रैगमेंट कैशिंग डिफ़ॉल्ट रूप से पेश किया जाता है)।
समापन: ActiveRecord और AppSignal के साथ अपने रूबी ऑन रेल्स प्रदर्शन को ऑप्टिमाइज़ करें
ठीक है, समय सारांश का! इस पोस्ट में, हमने रेल्स में डेटाबेस प्रदर्शन मुद्दों की पहचान और टेस्ट करने के तीन तरीकों को कवर किया:
- ActiveRecord क्वेरीज़ पर Explain चलाना
- प्रमुख डेटाबेस मेट्रिक्स मापना
- AppSignal का उपयोग करके रेल्स ऐप प्रदर्शन मापना
और आपके डेटाबेस प्रदर्शन को ऑप्टिमाइज़ करने के सात तरीके, जिनमें उपयोग शामिल है:
- N+1 क्वेरीज़ के लिए ईगर लोडिंग
- एक डेटाबेस इंडेक्स
- लिमिट्स
- बड़ी संख्या में आइटम लोड करने के लिए
find_each - आवश्यक फील्ड का चयन करने के लिए Pluck
- बल्क ऑपरेशन
- इन-मेमोरी गणना
रेल्स एक एप्लिकेशन विकसित करना सुपर आसान और तेज़ बनाता है। ActiveRecord डेटाबेस कोड की उत्पादकता, पुन: प्रयोज्यता, और रखरखाव में मदद करता है। यह समझना महत्वपूर्ण है कि ActiveRecord क्वेरीज़ SQL क्वेरी में कैसे अनुवादित होती हैं और निष्पादित होती हैं।
हालांकि, आपके रेल्स डेटाबेस प्रदर्शन को ऑप्टिमाइज़ करने के लिए सबसे महत्वपूर्ण चीज प्रदर्शन डेटा पर दृश्यता है। प्रदर्शन मुद्दे आम हैं, लेकिन आप उन्हें हल कर सकते हैं एक बार जब आपके पास यह दृश्यता हो। आपको एक उचित मॉनिटरिंग टूल की आवश्यकता है जो डेटाबेस मेट्रिक्स प्रदान करता है। हमें AppSignal पसंद है ;)
P.S. यदि आप रूबी मैजिक पोस्ट्स को प्रेस से निकलते ही पढ़ना चाहते हैं, तो हमारे रूबी मैजिक न्यूजलेटर को सब्सक्राइब करें और कभी भी एक भी पोस्ट मिस न करें!