अधिकांश वेब एप्लिकेशन किसी न किसी प्रकार के डेटा स्टोर का उपयोग करते हैं, अक्सर एक रिलेशनल डेटाबेस। जब एक वेब ऐप सफल हो जाता है, तो डेटाबेस में डेटा "होर्ड" करना बहुत आसान हो सकता है। लेकिन डेटा होर्डिंग डेटाबेस टेबल्स की अनबाउंडेड वृद्धि की ओर ले जाती है (दोनों पंक्ति गणना और संग्रहीत डेटा आकार)।
हालांकि यह एक निश्चित बिंदु तक ठीक काम करता है, कुछ डेटा ब्लोट को रोकना बहुत उपयोगी है - या, यदि आप इसे रोक नहीं सकते, तो विकास को पर्याप्त रूप से प्रबंधित करने के लिए अपने इंफ्रास्ट्रक्चर के लिए समय से पहले योजना बनाएं।
गोता लगाने से पहले, आइए देखें कि हम फूले हुए एप्लिकेशन के साथ कैसे समाप्त हो सकते हैं।
अधिक डेटा हमेशा महान नहीं होता
हम जिन अधिकांश एप्लिकेशन पर काम करते हैं, वे समय के साथ बड़े होते जाते हैं।
यदि आप अपने डेटाबेस के लिए क्लाउड प्रोवाइडर का उपयोग करते हैं, तो आप अपने आवंटित स्टोरेज लिमिट को हिट कर सकते हैं। एक बार ऐसा होने पर, आपको एक अलग इंस्टेंस टाइप में अपग्रेड करना होगा। उदाहरण के लिए, Heroku PostgreSQL डेटाबेस की एक सीमा होती है, एक "हॉबी" टियर इंस्टेंस 1GB डेटा तक सीमित होता है।
अधिक डेटा होने का क्वेरी गति पर भी प्रभाव पड़ता है। जो बड़े टेबल्स के साथ असंभव हो जाता है वह इंडेक्स के बिना संभव होता था। कुछ रो रेंज स्कैन धीमे हो जाएंगे। डेटाबेस UPDATE और DELETE ऑपरेशन करने के लिए अधिक लॉक प्राप्त किए जाएंगे।
डेटाबेस टेबल्स कैसे बढ़ते हैं
डेटा होर्डिंग धीरे-धीरे होता है। जो आज समस्या नहीं है वह एक महीने या छह महीने में आसानी से समस्या बन सकती है। डेटा होर्डिंग के बारे में सबसे विश्वासघाती बात यह है कि इसे याद करना इतना आसान है। कुछ बहुत क्लासिक परिदृश्यों पर विचार करें:
- कंप्लायंस कारणों से, आप
paper_trailजैसे जेम को अपनाते हैं और एकaudit_log_entriesटेबल प्राप्त करते हैं। आपके एप्लिकेशन में महत्व के मोड के साथ हर ऑपरेशनaudit_log_entriesटेबल में एक पंक्ति बनाता है। वे ऑडिट लॉग एंट्रीज़ कभी आर्काइव नहीं होतीं। - आप अपलोड स्वीकार करते हैं और ActiveStorage का उपयोग कर रहे हैं। आप अपलोड कभी नहीं हटाते, इसलिए आपकी
activestorage_blobsटेबल बड़ी होती जाती है। - आप वेब पर प्रकाशन के लिए एक शेयर्ड CMS चलाते हैं, और आप आर्टिकल सेगमेंट्स को अपने डेटाबेस में स्टोर करने की अनुमति देते हैं। आपका प्लेटफॉर्म सफल हो जाता है, लेकिन आपके अधिकांश लेखक किताब के आकार के लेख लिखते हैं।
pagesटेबल बहुत बड़ी हो जाती है भले ही इसमें केवल कुछ हजार पेज हों। - आप यूजर-अपलोडेड कंटेंट की अनुमति देते हैं, लेकिन आप कंप्लायंस कारणों से डेटा नहीं हटाते, और इसके बजाय फ्लैग के माध्यम से हटाने के लिए
paranoiaजैसी किसी चीज़ का उपयोग करते हैं। आपकीuser_itemsटेबल अनिश्चित काल तक बढ़ती है, और आपके जाने बिना, 10M पंक्तियों को पार कर जाती है।
यदि समय पर नहीं पकड़ा गया तो इन पैटर्न के निहितार्थ हैं। यदि आपकी टेबल्स के आकार का अच्छा दृश्य है, तो आप अनुमान लगा सकते हैं कि आपको कब अपग्रेड करना होगा और कम उपयोगकर्ता प्रभाव के साथ ऑफ-पीक समय पर रखरखाव शेड्यूल कर सकते हैं।
प्रोजेक्शन बनाना भी बहुत आसान हो जाता है। उदाहरण के लिए:
- आज हमारी
eventsटेबल मेमोरी में फिट बैठती है। वर्तमान वृद्धि दर पर, यह सात महीनों में मेमोरी में फिट नहीं होगी। - हम अपने RDS इंस्टेंस टाइप के लिए 30% स्टोरेज उपयोग पर हैं। हम अगले साल जनवरी में 90% हिट करेंगे।
- हमारे पास
paymentsपर एक फुल टेबल स्कैन क्वेरी है जो हर रो पर एक फ़ंक्शन की गणना करती है जहां इनपुट क्वेरी पर निर्भर करता है। हम जानते हैं किpaymentsटेबल तीन सप्ताह में दो मिलियन पंक्तियों को पार करेगी और अगले साल जनवरी तक 20 मिलियन।
इन सभी में एक घटना या आउटेज के रूप में प्रस्तुत होने की क्षमता है। लेकिन यदि आप जल्दी हमला करते हैं, तो आप इसे काफी आसानी से कम कर सकते हैं। उदाहरण के लिए:
- 30 दिनों से पुराने
eventsटेबल में सभी डेटा के लिए आर्काइविंग सेट अप करें। - चार महीनों में अपने RDS इंस्टेंस को अपग्रेड करें।
- फुल टेबल स्कैन को सीमित करने के लिए, हमारे क्वेरी में एक अतिरिक्त
WHEREकंडीशन जोड़ें ताकि फ़ंक्शन को बहुत छोटे सबसेट पंक्तियों पर गणना किया जा सके।
अपने डेटाबेस वृद्धि पर दृश्यता प्राप्त करें
अपने डेटाबेस वृद्धि पर नजर रखने के लिए, आपके पास दो संभावनाएं हैं:
- विशेष टूलिंग इंस्टॉल करें (MySQL के लिए स्टैट्स की तरह) और इसे Prometheus, Telegraph, या अन्य टूल्स के माध्यम से अपने मेट्रिक्स कलेक्शन इंजन से कनेक्ट करें।
- AppSignal का उपयोग करें, विशेष रूप से यदि आप पहले से ही अपने एप्लिकेशन के लिए इसका उपयोग कर रहे हैं।
AppSignal कई मेट्रिक प्रकार स्टोर कर सकता है, और समर्थित मेट्रिक प्रकारों में से एक को gauge कहा जाता है। एक gauge प्रति वातावरण (जैसे production, staging, या development) एक सिंगल टाइम सीरीज़ है जिसे आप समय-समय पर अपडेट कर सकते हैं। AppSignal मेट्रिक्स टैग्स की भी अनुमति देते हैं, इसलिए हम अपने डेटाबेस टेबल्स के लिए कुछ टैग्ड gauge मेट्रिक्स ऑटोमैटिकली बना सकते हैं। आइए ऐसा करें:
db.row_countहमारे टेबल्स में पंक्तियों की अनुमानित संख्या के लिए, प्रति टेबल (हम बाद में अनुमानों पर पहुंचेंगे)db.data_size_bytesएक टेबल द्वारा उपयोग किए जा रहे बाइट्स की संख्या के लिएdb.index_size_bytesएक टेबल के इंडेक्स द्वारा उपयोग किए जा रहे बाइट्स की संख्या के लिए
ध्यान दें कि मैं मीट्रिक नाम को मान प्रकार के साथ सफ़िक्स कर रहा हूं - यह बाद में मदद करता है जब हम परिभाषित करते हैं कि मीट्रिक कैसे प्रदर्शित होगी। अलग "डेटा" और "इंडेक्स" मेट्रिक्स भी महत्वपूर्ण हैं। यदि एक टेबल में कई पंक्तियाँ और कुछ से अधिक इंडेक्स हैं, तो उन इंडेक्स का आकार संग्रहीत डेटा के आकार से दो या तीन गुना हो सकता है (चूंकि हर इंडेक्स अपने लिए व्युत्पन्न डेटा स्टोर करता है, कुछ स्टोरेज ओवरहेड बनाता है)।
डेटाबेस टेबल पंक्तियों को तेजी से गिनना
"अनुमानित" भाग पंक्तियों की संख्या का आवश्यक है। आम तौर पर, यदि आप एक टेबल में पंक्तियों की सटीक संख्या चाहते हैं, तो आप SELECT COUNT(1) FROM my_table जैसी क्वेरी कर सकते हैं। हालांकि, यह हमारी इच्छा से धीमा हो सकता है।
जब आप COUNT करते हैं, तो डेटाबेस यह सुनिश्चित करता है कि क्वेरी के दौरान टेबल में पंक्तियों की संख्या नहीं बदलती - और इसलिए क्वेरी चलने के दौरान टेबल को लॉक कर देगा या एक डायवर्जेंट ट्रांज़ैक्शन बनाएगा। टेबल जितनी बड़ी होगी, क्वेरी उतनी ही धीमी होगी - अधिक पंक्तियों को स्कैन किया जाएगा, और अधिक लॉक जमा होंगे।
इसलिए, जब हम केवल पंक्तियों की संख्या का "काफी करीब" अनुमान चाहते हैं (प्रदर्शन अनुमान के लिए, 10-30 हजार पंक्तियों कम या ज्यादा की सटीकता काफी अच्छी है), हम आंतरिक डेटाबेस इंजन आंकड़ों का उपयोग करके इस प्रकार के डेटा के लिए क्वेरी कर सकते हैं।
अधिकांश डेटाबेस में टेबल डेटा के लिए अनुकूलित पहुंच होती है क्योंकि पंक्तियों को "पेज" में लिखा जाता है। डेटाबेस इंजन ट्रैक रखता है कि कौन सी पंक्तियाँ किस पेज को सौंपी गई हैं, लगभग सम्मिलन क्रम में:
- पंक्तियाँ 1-100 पेज 1 पर हैं
- पंक्तियाँ 101-200 पेज 2 पर हैं
- पंक्तियाँ 201-300 पेज 3 पर हैं
और इसी तरह।
चूंकि इंजन जानता है कि प्रति टेबल उसके कितने पेज हैं और प्रति पेज उसका अनुमानित पंक्ति गणना क्या है, यह आवंटित पेजों को गिन सकता है और फिर इसे पेज आकार (पंक्तियाँ प्रति पेज) से गुणा करके आपको वह अनुमान दे सकता है। इसके कुछ फायदे हैं: गिनती बहुत तेज़ है, और क्वेरी चलने के दौरान टेबल को लॉक करने की आवश्यकता नहीं है।
MySQL के लिए टेबल आकार रिकॉर्ड करें
हमें जो करने की आवश्यकता है वह डेटाबेस के अनुसार भिन्न होता है क्योंकि हमें टेबल आंकड़ों के लिए डेटाबेस इंजन को क्वेरी करने की आवश्यकता होती है। आइए MySQL से शुरू करें। यहां वह क्वेरी है जिसे हमें चलाने की आवश्यकता है:
इसके आउटपुट से कुछ कॉलम लें। जिनमें हम रुचि रखते हैं वे हैं Data_length, Index_length, और Rows। एक टेबल का आकार Data_length + Index_length के योग के रूप में परिभाषित किया गया है, और पेज के आधार पर अनुमानित पंक्ति गणना Rows में है।
इसे एक कोड ब्लॉक में पैकेज करें जो आपके पूरे डेटाबेस के लिए इस डेटा को एकत्र करता है। चूंकि हम किसी ActiveModel क्लास के साथ काम नहीं कर रहे हैं, हम ActiveRecord द्वारा सीधे प्रदान की गई क्वेरी मेथड्स का उपयोग करने जा रहे हैं:
PostgreSQL के लिए टेबल आकार रिकॉर्ड करें
हमें PostgreSQL के लिए एक अधिक विस्तृत क्वेरी की आवश्यकता है क्योंकि हमारे पास SHOW TABLE STATUS जैसी शॉर्टकट क्वेरी नहीं है। हमें आंतरिक PostgreSQL टेबल्स को क्वेरी करना होगा:
ध्यान दें कि यह केवल public स्कीमा (डिफ़ॉल्ट वाला जिसे आप शायद उपयोग कर रहे हैं) के लिए जिम्मेदार है। यदि आप अन्य स्कीमा शामिल करना चाहते हैं, तो आपको WHERE t.table_schema = 'public' कंडीशन को हटाना होगा और table_info.fetch('name') को table_info.fetch('full_table_name') से बदलना होगा।
सुनिश्चित करें कि मेट्रिक्स नियमित रूप से अपडेट हों
इस ब्लॉक को नियमित अंतराल पर चलना होगा, इसलिए इसे Sidekiq शेड्यूलर या cron से चलने वाले Rake टास्क में डालना एक अच्छा विचार है। उदाहरण के लिए, यदि आप good_job का उपयोग करते हैं, तो आप इसे अपने "cron" सेक्शन में इस तरह जोड़ सकते हैं:
एक डैशबोर्ड बनाएं
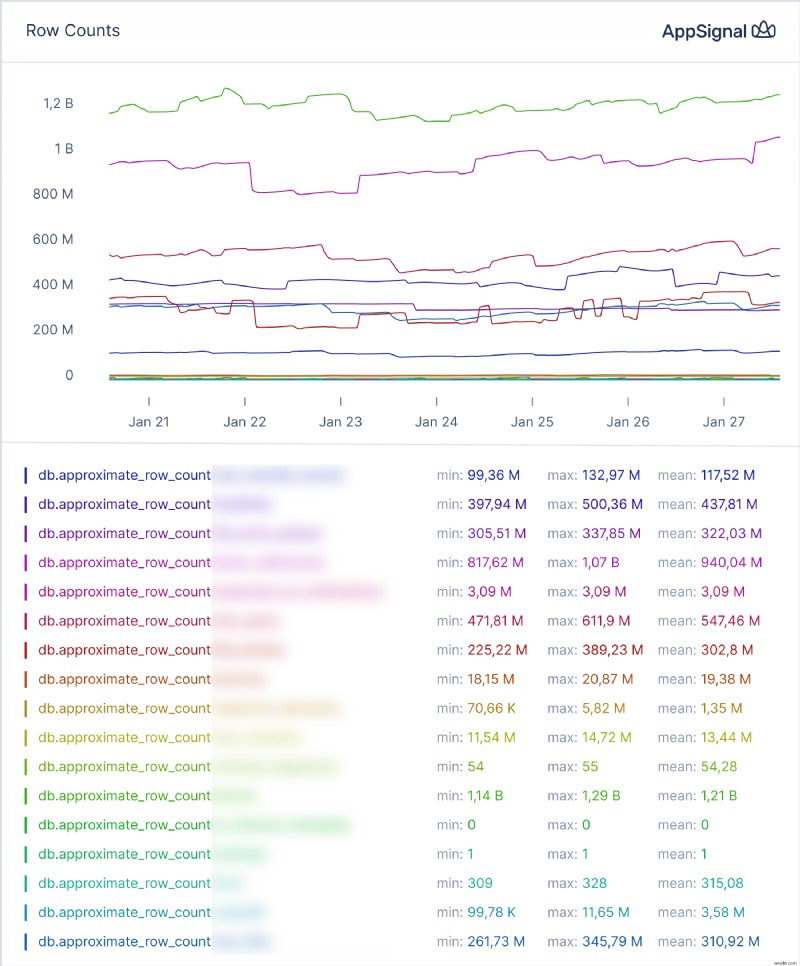
एक बार जब आपके पास डेटा आ रहा हो, तो एक डैशबोर्ड बनाएं। आप अपनी आवश्यकताओं के लिए निम्नलिखित डैशबोर्ड की नकल कर सकते हैं:
डैशबोर्ड जोड़ें पर क्लिक करें और फिर दिखाई देने वाले मॉडल डायलॉग में डैशबोर्ड आयात करें पर क्लिक करें। डैशबोर्ड आपको इस तरह के ग्राफ देगा:
और यह टेबल आकार ग्राफ:
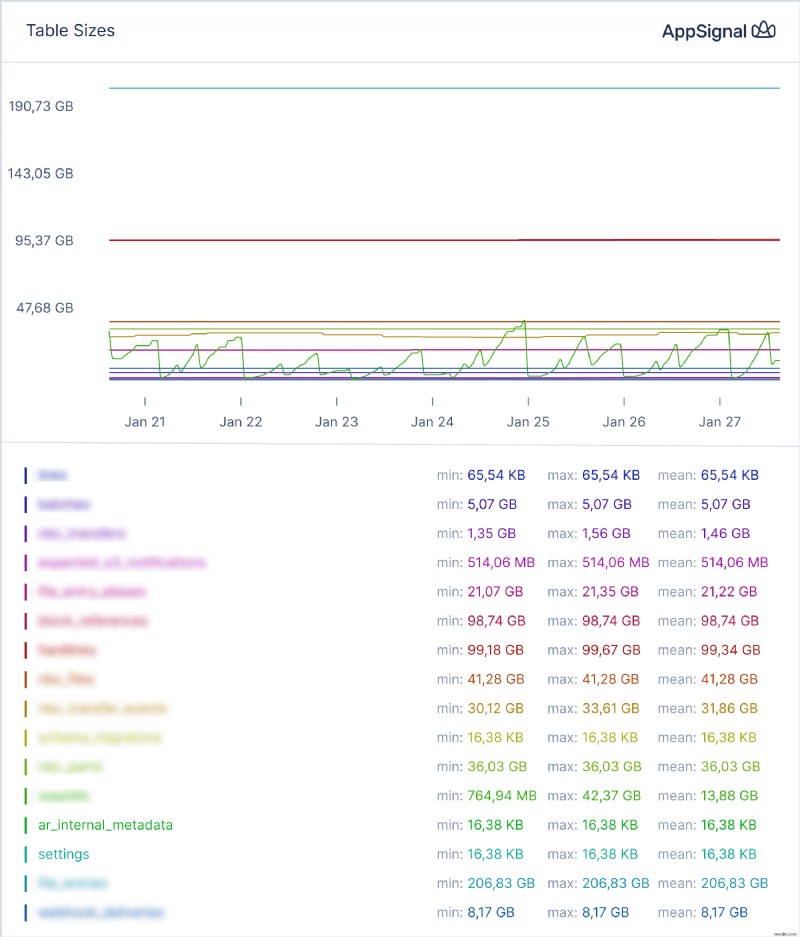
ध्यान दें कि हम डेटाबेस में हर टेबल के लिए ग्राफ ऑटोमैटिकली बनाने के लिए वाइल्डकार्ड टैग्स का उपयोग कैसे करते हैं।
डेटा की व्याख्या
अपने डेटा को देखते समय, पंक्ति गणना या आकार में घातीय या रैखिक वृद्धि को देखें - दूसरे शब्दों में, एक टेबल जो बड़ा होता जा रहा है।
यदि आप इसे देखते हैं, तो आपके पास कुछ विकल्प हैं। एक इस अनबाउंडेड वृद्धि के लिए आर्किटेक्ट करना है - जानें कब अपग्रेड करना है, और क्या आप अगले सर्वोत्तम आकार में अपग्रेड कर सकते हैं। दूसरा नियमित डिलीशन टास्क सेट अप करना है - मेरे पूर्व सहयोगी वांडर हिलेन ने इस विषय पर एक बेहतरीन लेख लिखा है।
उदाहरण के लिए, ऊपर के स्क्रीनशॉट में, कुछ टेबल्स नियमित रूप से सिकुड़ते हैं - यह तब होता है जब नियमित क्लीनअप टास्क चलते हैं। आप देख सकते हैं कि डेटा एक निश्चित बिंदु तक जमा होता है, लेकिन जबकि पंक्तियों का प्रवेश काफी स्थिर है, आकार और पंक्ति गणना गिरती है।
जब तक ये गिरावट हैं और आपकी टेबल्स में डेटा की मात्रा एक स्थिर दर से बढ़ती है, आपका डेटाबेस आपको अचानक लिमिट बस्ट से आश्चर्यचकित नहीं करेगा।
सारांश: डेटाबेस टेबल्स से डेटा ब्लोट से बचें
इस पोस्ट में, हमने देखा कि आप अपने डेटाबेस की वृद्धि पर दृश्यता कैसे प्राप्त कर सकते हैं और अपने डेटा ब्लोट को कम रख सकते हैं।
डेटा ब्लोट बाजार में सफल होने वाले एप्लिकेशन के लिए एक वास्तविक जोखिम है। अपने डेटाबेस टेबल्स के लिए मेट्रिक्स सेट अप करके, आप बेहतर अनुमान लगा सकते हैं कि अपने डेटाबेस को कब वर्टिकली स्केल करना है और क्या आपको नियमित स्टेल डेटा क्लीनअप इंस्टॉल करने की आवश्यकता है। टैग्स के साथ AppSignal गेज, थोड़े SQL के साथ संयुक्त, आपको इस डेटा को सुविधाजनक और सुखद प्रारूप में प्राप्त कर सकते हैं।
अपने डेटाबेस को आपको आश्चर्यचकित न करने दें!
जुलिक तारखानोव
गेस्ट ऑथर जुलिक तारखानोव चेडर पेमेंट्स में एक स्टाफ सॉफ्टवेयर इंजीनियर और कई रूबी ओपन-सोर्स लाइब्रेरी के लेखक हैं।
जुलिक तारखानोव के सभी लेख