Rails फ्रेमवर्क की सुंदरियों में से एक आपके मॉडल में Ruby on Rails एसोसिएशन का उपयोग करने की क्षमता है। ये एसोसिएशन आपको अपने कोड में रिकॉर्ड के संग्रह तक सुखद सिंटैक्स के साथ पहुंचने की अनुमति देते हैं, जिससे अंतर्निहित SQL क्वेरी लिखने की आवश्यकता समाप्त हो जाती है। यह अमूर्तता तब तक बनी रहती है जब तक आपका सारा डेटा एक ही स्थान पर रहता है। जिस क्षण आपके टेबल अलग-अलग डेटाबेस क्लस्टर में फैले होते हैं, कुछ एसोसिएशन प्रकार काम करना बंद कर देते हैं।
यह लेख ठीक उसी सीमा के बारे में बताता है और Rails उसके भीतर काम करने के लिए क्या प्रदान करता है। हम इस बात से शुरू करते हैं कि समस्या क्यों होती है और Rails में कौन से एसोसिएशन प्रभावित होते हैं, और उस डेटाबेस कॉन्फिगरेशन और मॉडल पदानुक्रम में जाते हैं जो कई क्लस्टर और कई-से-कई संबंधों का समर्थन करता है। वहां से हम कवर करेंगे कि विभिन्न डेटा एक्सेस पैटर्न उस विघटन के साथ कैसे इंटरैक्ट करते हैं।
यदि आप विशेष रूप से मल्टी-डेटाबेस सेटअप को कवर करने वाले Rails एसोसिएशन ट्यूटोरियल की तलाश कर रहे हैं, तो यह वही है। हम कई अन्य चीजों पर भी चर्चा करेंगे, तो बने रहें।
डेटाबेस अलग-अलग क्लस्टर में क्यों आ जाते हैं
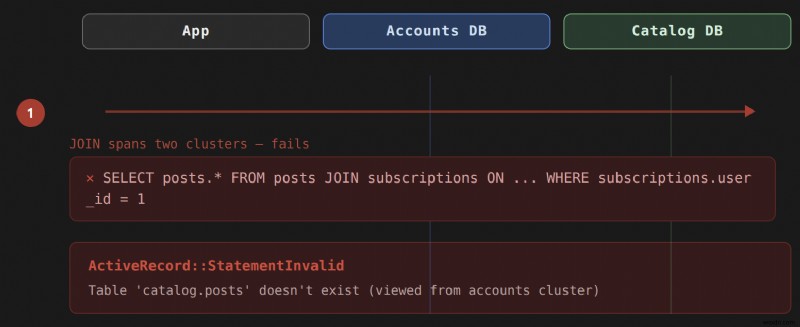
जब एक Rails एप्लिकेशन अपना सारा डेटा एक ही डेटाबेस में संग्रहीत करता है, तो Active Record एसोसिएशन पारदर्शी रूप से संभाले जाते हैं, और आप कभी भी अंतर्निहित SQL के बारे में नहीं सोचते। जिस क्षण आपका डेटा कई डेटाबेस क्लस्टर में रहता है, वह पारदर्शिता टूट जाती है। एक JOIN के लिए दोनों टेबल का एक ही डेटाबेस सर्वर में मौजूद होना आवश्यक है। क्लस्टर में एक JOIN का प्रयास ActiveRecord::StatementInvalid त्रुटि उत्पन्न करता है जैसे:
ActiveRecord::StatementInvalid (Table 'people_cluster.humans' doesn't exist) यह कॉन्फिगरेशन गलती नहीं है। यह एक कठिन भौतिक बाधा है: डेटाबेस सर्वर उन टेबल के खिलाफ JOIN नहीं कर सकते जिन्हें वे होस्ट नहीं करते। हमें यह समस्या has_many :through और has_one :through एसोसिएशन में होती है, क्योंकि ये वे एसोसिएशन प्रकार हैं जो इंटरमीडिएट JOIN क्वेरी उत्पन्न करते हैं। प्रत्यक्ष has_many या belongs_to संबंधों के लिए जॉइन की आवश्यकता नहीं होती इसलिए वे बिना किसी संशोधन के क्लस्टर में काम करते हैं।
यह समझना कि कब आप इस सीमा से टकराएंगे, पहला कदम है। यदि एक User accounts डेटाबेस में रहता है और एक Post content डेटाबेस में रहता है, तो User has_many :posts ठीक काम करता है। लेकिन यदि आप billing डेटाबेस में एक इंटरमीडिएट Subscription मॉडल जोड़ते हैं और User has_many :posts, through: :subscriptions परिभाषित करते हैं, तो Rails subscriptions और posts को एक ही क्वेरी में जोड़ने का प्रयास करेगा। यहीं क्लस्टर सीमा एक समस्या बन जाती है।
तीन-स्तरीय डेटाबेस कॉन्फिगरेशन
कोई भी मॉडल कोड लिखने से पहले, डेटाबेस कॉन्फिगरेशन को मल्टी-क्लस्टर लेआउट को प्रतिबिंबित करने की आवश्यकता है। Rails इस उद्देश्य के लिए config/database.yml में तीन-स्तरीय संरचना का उपयोग करता है। प्रत्येक शीर्ष-स्तरीय एनवायरनमेंट कुंजी में नेस्टेड डेटाबेस नाम होते हैं, और उनमें से प्रत्येक में उस क्लस्टर के लिए कनेक्शन विवरण होते हैं।
# config/database.yml default: &default adapter: postgresql pool: <%= ENV.fetch("RAILS_MAX_THREADS") { 5 } %> development: primary: <<: *default database: myapp_primary_dev accounts: <<: *default database: myapp_accounts_dev migrations_paths: db/accounts_migrate content: <<: *default database: myapp_content_dev migrations_paths: db/content_migrate production: primary: <<: *default database: myapp_primary_prod username: <%= ENV['DB_USER'] %> password: <%= ENV['DB_PASSWORD'] %> accounts: <<: *default database: myapp_accounts_prod username: <%= ENV['DB_USER'] %> password: <%= ENV['DB_PASSWORD'] %> content: <<: *default database: myapp_content_prod username: <%= ENV['DB_USER'] %> password: <%= ENV['DB_PASSWORD'] %> migrations_paths कुंजी गैर-वैकल्पिक है यदि आप चाहते हैं कि Rails जनरेटर और db:migrate माइग्रेशन को सही डायरेक्टरी में रूट करें। इसके बिना, सभी माइग्रेशन डिफ़ॉल्ट रूप से db/migrate पर जाते हैं और प्राथमिक डेटाबेस पर लागू होते हैं। प्रत्येक सेकेंडरी डेटाबेस में एक संबंधित एब्सट्रैक्ट रिकॉर्ड क्लास भी होना चाहिए जिससे Rails मॉडल विरासत में लें। जनरेटर इसे स्वचालित रूप से संभालते हैं जब आप --database फ्लैग पास करते हैं:
rails generate model Subscription plan:string --database accounts यह एक AccountsRecord क्लास उत्पन्न करता है यदि वह पहले से मौजूद नहीं है, और जनरेटेड Subscription मॉडल इससे विरासत में लेता है।
एब्सट्रैक्ट रिकॉर्ड क्लास और कनेक्शन रूटिंग
एब्सट्रैक्ट रिकॉर्ड क्लास वह तंत्र है जिसका उपयोग Rails क्वेरी को सही क्लस्टर पर रूट करने के लिए करता है। प्रत्येक connects_to को कॉल करके घोषित करता है कि यह लिखने और पढ़ने के संचालन के लिए किस डेटाबेस से मैप होता है। आपके एप्लिकेशन में आमतौर पर इस पदानुक्रम में तीन परतें होंगी।
# app/models/application_record.rb class ApplicationRecord < ActiveRecord::Base self.abstract_class = true connects_to database: { writing: :primary, reading: :primary } end # app/models/accounts_record.rb class AccountsRecord < ApplicationRecord self.abstract_class = true connects_to database: { writing: :accounts, reading: :accounts } end # app/models/content_record.rb class ContentRecord < ApplicationRecord self.abstract_class = true connects_to database: { writing: :content, reading: :content } end User मॉडल इस पदानुक्रम को समझने के लिए एक अच्छा एंकर है। यह accounts क्लस्टर में रहता है और AccountsRecord से विरासत में लेता है। content क्लस्टर में मॉडल ContentRecord से विरासत में लेते हैं। बाकी सब ApplicationRecord से विरासत में लेते हैं और प्राथमिक डेटाबेस को हिट करते हैं। यह विरासत श्रृंखला है जिससे Active Record यह निर्धारित करता है कि क्वेरी निष्पादित करते समय किस कनेक्शन पूल का उपयोग करना है। यह क्लास पदानुक्रम में तब तक ऊपर जाता है जब तक कि उसे वह क्लास नहीं मिल जाती जिसने connects_to को कॉल किया है। 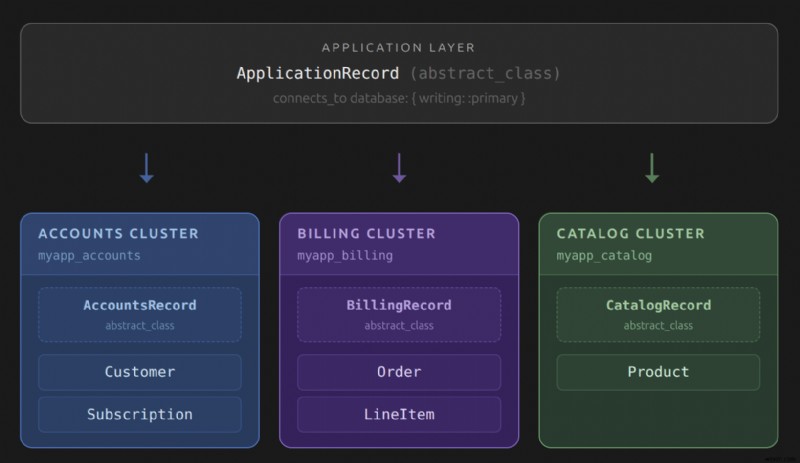
एक आम गलती है व्यक्तिगत मॉडल पर establish_connection कॉल करना बजाय एब्सट्रैक्ट क्लास का उपयोग करने के। प्रत्येक establish_connection कॉल एक अलग कनेक्शन पूल खोलता है। यदि आपके पास accounts डेटाबेस में 50 मॉडल हैं, प्रत्येक establish_connection कॉल कर रहा है, तो आप उसी सर्वर पर इशारा करने वाले 50 कनेक्शन पूल के साथ समाप्त होते हैं। एब्सट्रैक्ट क्लास इसे हल करते हैं उन सभी मॉडल में एक ही पूल साझा करके जो उनसे विरासत में लेते हैं।
Rails में क्रॉस-क्लस्टर एसोसिएशन वास्तव में कैसे काम करते हैं
disable_joins: true विकल्प through एसोसिएशन को तब काम करने के लिए सीधा तंत्र है जब शामिल टेबल अलग-अलग क्लस्टर में रहते हैं। Rails has_many सबसे अधिक उपयोग किया जाने वाला एसोसिएशन प्रकार है, और यह क्लस्टर सीमाओं से सबसे सीधे प्रभावित होता है। जब Rails किसी एसोसिएशन पर इस विकल्प का सामना करता है, तो यह सिंगल JOIN क्वेरी रणनीति को छोड़ देता है और इसके बजाय दो (या अधिक) अनुक्रमिक SELECT स्टेटमेंट जारी करता है, पहले क्वेरी से IDs को दूसरे में WHERE ... IN (...) क्लॉज में पाइप करता है।
यहां तीन क्लस्टर में फैला एक ठोस मॉडल सेटअप है। नीचे दिया गया मॉडल सेटअप एक कई-से-कई संबंध है, एक User, Subscriptions के माध्यम से Posts से जुड़ता है, और यह वह पैटर्न है जो क्रॉस-क्लस्टर समस्या को सबसे सीधे उजागर करता है।
# app/models/user.rb - accounts डेटाबेस में रहता है class User < AccountsRecord has_many :subscriptions has_many :posts, through: :subscriptions, disable_joins: true end # app/models/subscription.rb - accounts डेटाबेस में रहता है class Subscription < AccountsRecord belongs_to :user has_many :posts end # app/models/post.rb - content डेटाबेस में रहता है class Post < ContentRecord belongs_to :subscription end जब आप user.posts कॉल करते हैं, तो Rails एक सिंगल JOIN के बजाय क्वेरी की इस जोड़ी को जनरेट करता है:
-- क्वेरी 1: accounts क्लस्टर से सब्सक्रिप्शन IDs लाएं SELECT "subscriptions"."id" FROM "subscriptions" WHERE "subscriptions"."user_id" = 1 -- क्वेरी 2: उन IDs का उपयोग करके content क्लस्टर से पोस्ट लाएं SELECT "posts".* FROM "posts" WHERE "posts"."subscription_id" IN (4, 7, 12) पहली क्वेरी accounts डेटाबेस के विरुद्ध चलती है प्राथमिक कुंजी एकत्र करने के लिए। दूसरी content के विरुद्ध चलती है। Rails विदेशी कुंजियों, subscriptions पर user_id और posts पर subscription_id, का पालन करके दो क्लस्टर में संबंध को हल करता है। पहली क्वेरी सब्सक्रिप्शन से प्राथमिक कुंजी मान एकत्र करती है, फिर उन्हें दूसरी क्वेरी के IN क्लॉज में पास करती है। कोई भी क्वेरी क्रॉस-क्लस्टर जॉइन का प्रयास नहीं करती। Rails अंतिम परिणाम सेट को एप्लिकेशन मेमोरी में असेंबल करता है। 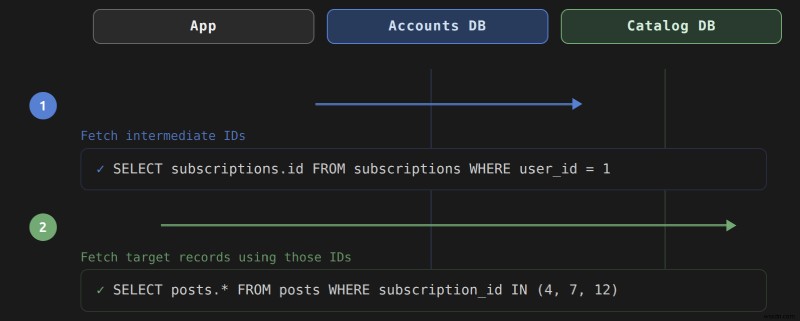
 वही विकल्प
has_one :through पर समान रूप से काम करता है:
# app/models/user.rb class User < AccountsRecord has_one :profile has_one :avatar, through: :profile, disable_joins: true end # app/models/profile.rb - accounts डेटाबेस class Profile < AccountsRecord belongs_to :user has_one :avatar end # app/models/avatar.rb - content डेटाबेस class Avatar < ContentRecord belongs_to :profile end user.avatar दो क्वेरी निष्पादित करेगा: एक profile_id प्राप्त करने के लिए, दूसरी content क्लस्टर से अवतार रिकॉर्ड लाने के लिए।
disable_joins को कब स्पष्ट रूप से सेट करना चाहिए
Rails स्वचालित रूप से क्लस्टर सीमाओं का पता नहीं लगाता और आपके लिए disable_joins डालता है। Active Record में एसोसिएशन लोडिंग आलसी है। एक एसोसिएशन के लिए SQL उस बिंदु पर निर्धारित होता है जहां एसोसिएशन मॉडल पर परिभाषित होता है, न कि जब यह वास्तव में ट्रिगर होता है। जब तक user.posts निष्पादित होता है, Rails ने पहले ही एसोसिएशन घोषणा के आधार पर तय कर लिया होता है कि JOIN का उपयोग करना है या अलग क्वेरी का।
इसका अर्थ है कि क्लस्टर सीमा को पार करने वाले प्रत्येक through एसोसिएशन को घोषणा पर disable_joins: true की आवश्यकता होती है।
अपने मॉडल को ऑडिट करने का एक व्यावहारिक तरीका है किसी भी through: एसोसिएशन की तलाश करना जहां स्रोत मॉडल और लक्ष्य मॉडल अलग-अलग एब्सट्रैक्ट रिकॉर्ड क्लास से विरासत में लेते हैं। यदि User < AccountsRecord और Post < ContentRecord, तो has_many :posts, through: :subscriptions को disable_joins: true की आवश्यकता होती है चाहे Subscription कहीं भी रहता हो।
क्लस्टर में ईगर लोडिंग
disable_joins विकल्प प्रभावित करता है कि एसोसिएशन कैसे लोड होते हैं, लेकिन यह नहीं बदलता कि ईगर लोडिंग रणनीतियां क्रॉस-क्लस्टर डेटा के साथ कैसे इंटरैक्ट करती हैं। इस अंतर को समझना मल्टी-डेटाबेस सेटअप में N+1 क्वेरी से बचने के लिए मायने रखता है।
eager_load क्रॉस-क्लस्टर एसोसिएशन के लिए सवाल से बाहर है। यह एक LEFT OUTER JOIN उत्पन्न करता है, जिसमें नियमित JOIN की तरह ही भौतिक सीमा होती है - दोनों टेबल एक ही सर्वर पर होने चाहिए। यदि आप User.eager_load(:posts) का प्रयास करते हैं जहां पोस्ट एक अलग क्लस्टर में रहते हैं, तो आपको वही StatementInvalid त्रुटि मिलेगी।
preload सही रणनीति है। यह प्रत्येक एसोसिएशन के लिए अलग क्वेरी जारी करता है और रिश्ते को Ruby में असेंबल करता है। यह संरचनात्मक रूप से वही है जो disable_joins एक सिंगल रिकॉर्ड के लिए करता है। अंतर पैमाने का है: preload दूसरे क्वेरी को सभी लोडेड पैरेंट रिकॉर्ड में बैच करता है।
# यह क्लस्टर में काम करता है। # क्वेरी 1: SELECT "users".* FROM "users" # क्वेरी 2: SELECT "posts".* FROM "posts" WHERE "posts"."subscription_id" IN (...) users = User.preload(:posts).all users.each do |user| user.posts.each { |post| puts post.title } # कोई अतिरिक्त क्वेरी नहीं चलाई गई end includes उन मामलों में काम करेगा जहां यह आंतरिक रूप से preload को डेलीगेट करता है, जो यह डिफ़ॉल्ट रूप से करता है जब संबद्ध टेबल के कॉलम को संदर्भित करने वाली कोई शर्त नहीं होती। यदि आप एक .where क्लॉज जोड़ते हैं जो संबद्ध टेबल के कॉलम को छूता है, तो includes eager_load व्यवहार पर स्विच करता है, और क्लस्टर में विफल हो जाएगा। संदेह होने पर includes कौन सी रणनीति चुनेगा, स्पष्ट रहें और सीधे preload का उपयोग करें।
# includes यहां preload को डेलीगेट करता है, क्लस्टर में काम करता है User.includes(:posts).all # includes जहां क्लॉज के कारण eager_load पर स्विच करता है, क्लस्टर में विफल होता है User.includes(:posts).where("posts.published = ?", true) # क्रॉस-क्लस्टर फ़िल्टरिंग के लिए preload + अलग where का उपयोग करें User.preload(:posts).all.select { |u| u.posts.any?(&:published?) } # या लोड करने के बाद एप्लिकेशन कोड में फ़िल्टर करें स्कोप्ड एसोसिएशन और क्रॉस-क्लस्टर फ़िल्टरिंग
मल्टी-डेटाबेस सेटअप में अधिक सूक्ष्म इंटरैक्शन में से एक स्कोप्ड एसोसिएशन है। जब आप एक has_many पर स्कोप परिभाषित करते हैं जो क्लस्टर को पार करता है, तो स्कोप का SQL लक्ष्य डेटाबेस के विरुद्ध चलता है, स्रोत नहीं।
class User < AccountsRecord has_many :subscriptions has_many :published_posts, -> { where(published: true) }, through: :subscriptions, source: :posts, class_name: "Post", disable_joins: true end where(published: true) क्लॉज दूसरी क्वेरी में जुड़ जाता है, जो content डेटाबेस के विरुद्ध चलती है। यह सही व्यवहार है, और इसका अर्थ है कि आपके स्कोप लक्ष्य टेबल पर कॉलम को बिना किसी समस्या के संदर्भित कर सकते हैं। आप जो नहीं कर सकते वह है उस स्कोप में इंटरमीडिएट टेबल के कॉलम को संदर्भित करना, क्योंकि इंटरमीडिएट क्वेरी तब तक पूरी हो चुकी होती है जब तक स्कोप्ड क्वेरी निष्पादित होती है।
# यह विफल होगा क्योंकि subscriptions.active content डेटाबेस में कॉलम नहीं है has_many :active_posts, -> { where("subscriptions.active = ?", true) }, through: :subscriptions, source: :posts, disable_joins: true इंटरमीडिएट रिकॉर्ड को फ़िल्टर करने के लिए इंटरमीडिएट एसोसिएशन पर स्कोप जोड़ें:
class User < AccountsRecord has_many :active_subscriptions, -> { where(active: true) }, class_name: "Subscription" has_many :active_posts, through: :active_subscriptions, source: :posts, disable_joins: true end अब subscriptions.active पर फ़िल्टरिंग पहली क्वेरी में होती है, accounts डेटाबेस के विरुद्ध, और केवल सक्रिय सब्सक्रिप्शन से IDs दूसरी क्वेरी में पास होते हैं।
क्षैतिज शार्डिंग और क्रॉस-शार्ड एसोसिएशन
tenant_id जैसे पार्टीशन कुंजी के आधार पर एक तार्किक डेटाबेस को कई सर्वर में विभाजित करना क्रॉस-क्लस्टर समस्या में दूसरा आयाम जोड़ता है। disable_joins तंत्र अभी भी लागू होता है, लेकिन कनेक्शन रूटिंग अधिक शामिल हो जाती है।
Rails एक रिक्वेस्ट के भीतर शार्ड के बीच स्विच करने के लिए connected_to प्रदान करता है:
ActiveRecord::Base.connected_to(role: :writing, shard: :shard_one) do User.find(1) # shard_one को हिट करता है end जब एसोसिएशन दोनों क्लस्टर और शार्ड में फैले होते हैं, तो आपको यह सुनिश्चित करने की आवश्यकता होती है कि शार्ड संदर्भ और disable_joins विकल्प दोनों मौजूद हैं। shard_one पर एक User जो अलग content डेटाबेस में रहने वाले पोस्ट तक पहुंच रहा है, उसे अभी भी वही दो-क्वेरी विघटन चाहिए।
Rails 8 ने रनटाइम पर शार्ड टोपोलॉजी के बारे में तर्क करना आसान बनाने वाले इंट्रोस्पेक्शन मेथड जोड़े:
class ShardedBase < ActiveRecord::Base self.abstract_class = true connects_to shards: { shard_one: { writing: :shard_one }, shard_two: { writing: :shard_two } } end class User < ShardedBase; end User.shard_keys # => [:shard_one, :shard_two] User.sharded? # => true ShardedBase.connected_to_all_shards do User.current_shard # क्रमिक रूप से :shard_one, फिर :shard_two देता है end connected_to_all_shards बैकग्राउंड जॉब के लिए विशेष रूप से उपयोगी है जिन्हें हर शार्ड में रिकॉर्ड प्रोसेस करने की आवश्यकता होती है। यह प्रत्येक शार्ड पर क्रमिक रूप से पुनरावृति करता है, प्रत्येक ब्लॉक निष्पादन के लिए कनेक्शन संदर्भ को स्विच करता है।
टेनेंट-आधारित शार्डिंग के लिए, शार्ड स्विचिंग पर lock: true डिफ़ॉल्ट आकस्मिक टेनेंट हॉपिंग को मध्य-रिक्वेस्ट में रोकता है। यह एक सुरक्षा तंत्र है: एक बार रिक्वेस्ट टेनेंट के शार्ड पर रूट हो जाने के बाद, एप्लिकेशन कोड स्पष्ट रूप से lock: false पास किए बिना किसी अन्य टेनेंट के शार्ड पर स्विच नहीं कर सकता। एक ही टेनेंट के शार्ड के भीतर क्रॉस-क्लस्टर एसोसिएशन अभी भी उन एसोसिएशन के लिए disable_joins का उपयोग करते हैं जो एक अलग डेटाबेस क्लस्टर को छूते हैं।
क्रॉस-क्लस्टर एसोसिएशन का परीक्षण
मल्टी-डेटाबेस सेटअप का परीक्षण करने के लिए आवश्यक है कि आपका टेस्ट एनवायरनमेंट प्रोडक्शन डेटाबेस टोपोलॉजी को प्रतिबिंबित करे। Rails का टेस्ट फ्रेमवर्क इसका समर्थन करता है, लेकिन कॉन्फिगरेशन स्पष्ट होना चाहिए।
database.yml में प्रत्येक डेटाबेस को एक test एनवायरनमेंट ब्लॉक की आवश्यकता होती है। फिक्स्चर और फैक्टरी-आधारित टेस्ट डेटा को सही डेटाबेस को लक्षित करना होगा। यदि एक User फैक्टरी accounts डेटाबेस में एक रिकॉर्ड बनाती है और एक Post फैक्टरी content में एक बनाती है, तो उनके बीच एसोसिएशन केवल तभी काम करता है जब दोनों रिकॉर्ड एक ही टेस्ट ट्रांजेक्शन के भीतर अपने संबंधित डेटाबेस में मौजूद हों।
Rails डिफ़ॉल्ट रूप से प्रत्येक टेस्ट को एक ट्रांजेक्शन में लपेटता है, लेकिन वह ट्रांजेक्शन प्रति-कनेक्शन है। कई डेटाबेस के साथ, प्रत्येक कनेक्शन को अपना ट्रांजेक्शन मिलता है। इसका अर्थ है कि टेस्ट क्लीनअप (प्रत्येक टेस्ट के अंत में स्वचालित रोलबैक) प्रत्येक डेटाबेस पर स्वतंत्र रूप से होता है। यदि आपका टेस्ट accounts में एक User और content में एक Post लिखता है, तो दोनों रोल बैक हो जाएंगे, लेकिन केवल तभी जब टेस्ट फ्रेमवर्क दोनों कनेक्शन के बारे में जानता हो।
fixtures घोषणा इसे स्वचालित रूप से संभालती है जब मॉडल सही एब्सट्रैक्ट क्लास से विरासत में लेते हैं। फैक्टरी-आधारित सेटअप (FactoryBot, Fabricator) के लिए, सुनिश्चित करें कि प्रत्येक फैक्टरी की create रणनीति मॉडल के अपने connects_to रूटिंग को काम करने देकर सही डेटाबेस को हिट करती है।
# spec/factories/users.rb FactoryBot.define do factory :user do # User AccountsRecord से विरासत में लेता है और स्वचालित रूप से accounts DB में लिखता है name { Faker::Name.name } end end # spec/factories/posts.rb FactoryBot.define do factory :post do # Post ContentRecord से विरासत में लेता है और स्वचालित रूप से content DB में लिखता है association :subscription title { Faker::Lorem.sentence } end end यह सत्यापित करने के लिए कि क्रॉस-क्लस्टर एसोसिएशन अपेक्षित संख्या में क्वेरी चला रहे हैं, sql.active_record नोटिफिकेशन की सदस्यता लें:
# spec/support/query_counter.rb module QueryCounter def assert_query_count(expected, &block) count = 0 callback = ->(_name, _start, _finish, _id, payload) do count += 1 unless payload[:name] == "SCHEMA" || payload[:sql].start_with?("EXPLAIN") end ActiveSupport::Notifications.subscribed(callback, "sql.active_record", &block) assert_equal expected, count, "Expected #{expected} queries, got #{count}" end end एक सिंगल रिकॉर्ड पर disable_joins: true के साथ has_many :through को ठीक 2 क्वेरी उत्पन्न करनी चाहिए। यदि आप 1 देखते हैं, तो जॉइन का अभी भी प्रयास किया जा रहा है (और प्रोडक्शन में अलग सर्वर के विरुद्ध विफल होगा)। यदि आप N+1 देखते हैं, तो ईगर लोडिंग उम्मीद के मुताबिक काम नहीं कर रही है।
कुछ चेतावनियाँ
disable_joins एसोसिएशन लोडिंग समस्या को हल करता है, लेकिन यह क्वेरी चेनिंग तक विस्तारित नहीं होता। आप एक ही Active Record रिलेशन पर .where, .order, या .group क्लॉज को चेन नहीं कर सकते जो क्लस्टर में कॉलम को संदर्भित करते हैं:
# यह काम नहीं करता, आप क्लस्टर में ऑर्डर कॉलम द्वारा प्रोडक्ट्स को फ़िल्टर नहीं कर सकते customer.purchased_products.where("orders.total > ?", 100) क्वेरी के लिए जिन्हें कई क्लस्टर में डेटा के आधार पर फ़िल्टर या सॉर्ट करने की आवश्यकता होती है, उन्हें मैन्युअल रूप से विघटित करें। एक क्लस्टर से आपको जिन IDs या मानों की आवश्यकता है उन्हें लाएं, फिर उन्हें दूसरे के विरुद्ध क्वेरी के लिए इनपुट के रूप में उपयोग करें:
high_value_order_ids = Order.where(customer_id: customer.id) .where("total > ?", 100) .pluck(:id) line_item_product_ids = LineItem.where(order_id: high_value_order_ids).pluck(:product_id) products = Product.where(id: line_item_product_ids) यह वही विघटन है जो disable_joins आंतरिक रूप से करता है, लेकिन स्पष्ट रूप से किया जाता है ताकि आप प्रत्येक चरण में फ़िल्टरिंग लागू कर सकें। यह अधिक वर्बोज है, लेकिन यह Rails सिंटैक्स में एसोसिएशन के पीछे छिपाने के बजाय क्लस्टर सीमाओं को कोड में दृश्यमान बनाता है।
संपादक का नोट: यह पोस्ट मूल रूप से जनवरी 2023 में प्रकाशित हुई थी और सटीकता के लिए अपडेट की गई है।