Arrays को समझना
जब आप प्रोग्रामिंग के बारे में पढ़ना शुरू करते हैं तो एरे पहला डेटा स्ट्रक्चर है जिसके बारे में आप सीखते हैं।
एरे मेमोरी के एक सन्निहित हिस्से का उपयोग करते हैं जहां ऑब्जेक्ट्स एक के बाद एक बिना अंतराल के संग्रहीत होते हैं।
C जैसी निचले स्तर की प्रोग्रामिंग भाषाओं के विपरीत, Ruby आपकी मेमोरी को प्रबंधित करने, अधिकतम एरे आकार का विस्तार करने और एलिमेंट्स को हटाते समय इसे कॉम्पैक्ट करने का सारा कठिन काम करता है।
उपयोग:
- अधिक उन्नत डेटा स्ट्रक्चर्स के लिए आधार के रूप में
- एक लूप चलाने से परिणाम इकट्ठा करने के लिए
- आइटम्स एकत्र करने के लिए
आपको एरे हर जगह मिलेंगे, जैसे split और chars मेथड्स, जो एक स्ट्रिंग को कैरेक्टर्स के एरे में तोड़ते हैं।
उदाहरण:
 out = []
10.times { |i| out << i }
out # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
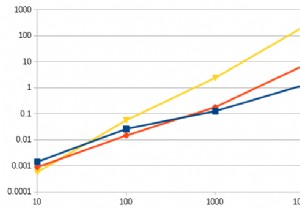
निम्न तालिका आपको दिखाती है कि एरे के आकार बढ़ने पर विभिन्न एरे ऑपरेशन्स कैसे व्यवहार करते हैं।
यदि आप टाइम कॉम्प्लेक्सिटी नोटेशन से परिचित नहीं हैं तो इस आर्टिकल को पढ़ें।
एरे के लिए टाइम कॉम्प्लेक्सिटी:
| Operation | Complexity |
|---|---|
| push | O(1) |
| pop | O(1) |
| access | O(1) |
| find | O(n) |
| delete | O(n) |
यह उपयोगी क्यों है?
क्योंकि यह आपको एरे की प्रदर्शन विशेषताओं को बताता है।
यदि आप एक विशाल एरे पर बहुत सारे find ऑपरेशन्स कर रहे हैं तो यह धीमा होने वाला है...
लेकिन यदि आप जानते हैं कि किन इंडेक्स का उपयोग करना है, तो एरे O(1) टाइम कॉम्प्लेक्सिटी के कारण तेज़ होने वाला है।
इस मानदंड के साथ अपने डेटा स्ट्रक्चर को चुनें:
- प्रदर्शन विशेषताएं => आप डेटा के साथ क्या कर रहे हैं? आपका डेटासेट कितना बड़ा है?
- आपके डेटा का आकार और रूप => आप किस प्रकार के डेटा के साथ काम कर रहे हैं? क्या आप अपने डेटा को पुनर्गठित कर सकते हैं ताकि यह एक बेहतर डेटा स्ट्रक्चर में फिट हो?
हैश डेटा स्ट्रक्चर
क्या आपके पास देश कोड्स और देश नामों के बीच मैपिंग है?
या शायद आप बस चीज़ों को गिनना चाहते हैं।
यही हैश के लिए उपयोगी हैं!
एक हैश एक डेटा स्ट्रक्चर है जहां हर मान की एक की होती है और यह की कुछ भी हो सकती है, जैसे एक स्ट्रिंग, एक इंटीजर, एक सिम्बल, आदि।
यह कैसे काम करता है?
एक हैश आपके की को एक नंबर में परिवर्तित करता है (Ruby में hash मेथड का उपयोग करके) और फिर उस नंबर को इंडेक्स के रूप में उपयोग करता है। लेकिन आपको हैश का उपयोग करने के लिए इसे समझने की आवश्यकता नहीं है।
उपयोग:
- एक स्ट्रिंग में कैरेक्टर्स गिनना
- शब्दों को परिभाषाओं, नामों को फोन नंबर्स, आदि से मैप करना
- एक एरे के अंदर डुप्लिकेट ढूंढना
उदाहरण:
 "aaabcd"
  .each_char
  .with_object(Hash.new(0)) { |ch, hash| hash[ch] += 1 }
# {"a"=>3, "b"=>1, "c"=>1, "d"=>1}
टाइम कॉम्प्लेक्सिटी:
| Operation | Complexity |
|---|---|
| store | O(1) |
| access | O(1) |
| delete | O(1) |
| find (value) | O(n) |
हैशेस प्रदर्शन के मामले में सबसे उपयोगी डेटा स्ट्रक्चर्स में से एक हैं क्योंकि स्टोर, डिलीट और एक्सेस के लिए निरंतर O(1) टाइम कॉम्प्लेक्सिटी है।
हैश के संदर्भ में फाइंड का मतलब है कि आप एक विशिष्ट मान की तलाश कर रहे हैं।
Stacks (स्टैक्स)
एक स्टैक प्लेट्स के ढेर की तरह है, आप एक प्लेट को दूसरी के ऊपर रखते हैं और आप केवल शीर्ष पर की प्लेट को हटा सकते हैं।
यह पहली नज़र में जितना उपयोगी लगता है उससे अधिक उपयोगी है!
उपयोग:
- रिकर्सिव मेथड्स को एक नियमित लूप से बदलें
- काम को ट्रैक करें जो करने के लिए बचा है, सबसे हालिया को शीर्ष पर छोड़कर
- एक एरे को उल्टा करें
उदाहरण:
 stack = [1,2,3,4,5]
(1..stack.size).map { stack.pop }
# [5, 4, 3, 2, 1]
हाँ, आप इसके बजाय reverse उपयोग कर सकते हैं।
यह केवल आपको स्टैक्स की इस विशेष विशेषता को दिखाने का एक उदाहरण है।
टाइम कॉम्प्लेक्सिटी:
| Operation | Complexity |
|---|---|
| push | O(1) |
| pop | O(1) |
| find | --- |
| access | --- |
ध्यान दें कि स्टैक्स (और क्यूज़) में केवल दो ऑपरेशन्स होते हैं, insert और delete, या push और pop।
जबकि स्टैक के अंदर खोजना संभव है, यह बहुत दुर्लभ है।
बाइनरी ट्रीज़ का उपयोग कैसे करें
अधिकांश Ruby डेवलपर्स ने शायद बाइनरी ट्रीज़ के बारे में सुना है लेकिन कभी इसका उपयोग नहीं किया।
ऐसा क्यों है?
पहला, हमारे पास एक बिल्ट-इन बाइनरी ट्री कार्यान्वयन नहीं है।
दूसरा, एक बाइनरी ट्री रोजमर्रा की प्रोग्रामिंग चुनौतियों के लिए इतना उपयोगी नहीं है, एरे और हैश के विपरीत जिनका आप हर समय उपयोग करते हैं।
लेकिन बाइनरी ट्रीज़ एक बहुत दिलचस्प डेटा स्ट्रक्चर हैं।
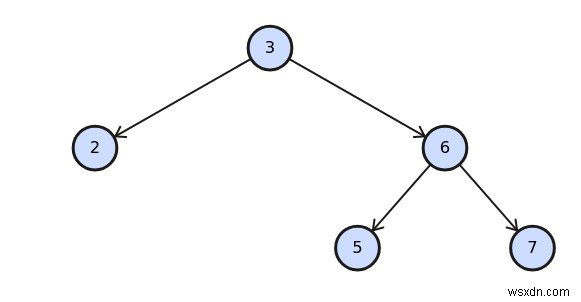
वास्तव में, कई विविधताएं हैं, जैसे Trie (अगले खंड में शामिल), मल्टीवे ट्रीज़ जैसे B-Tree (डेटाबेस में उपयोग किया जाता है) और Heap।
उपयोग:
- डेटा कम्प्रेशन
- रूटिंग टेबल्स
- एब्स्ट्रैक्ट सिंटैक्स ट्रीज़ (AST)
उदाहरण:
 # https://github.com/jamesconant/bstree
require 'bstree'
root = Bstree::Node.new(5)
root.insert(2)
root.insert(7)
root.search(3) # nil
टाइम कॉम्प्लेक्सिटी:
| Operation | Complexity |
|---|---|
| insert | O(log n) |
| delete | O(log n) |
| find | O(log n) |
| access | --- |
एक संतुलित बाइनरी ट्री वह है जब सभी नोड्स के दो बच्चे होते हैं और सभी पत्तियों का स्तर समान होता है।
यदि एक ट्री असंतुलित हो जाता है, तो प्रदर्शन O(n) तक गिर जाता है।
एक सेल्फ-बैलेंस्ड बाइनरी ट्री में (जैसे रेड-ब्लैक ट्री, या AVL ट्री), हर ऑपरेशन ट्री की ऊंचाई (या स्तर) के अनुपात में समय लेता है।
ध्यान दें कि कोई एक्सेस टाइम नहीं है क्योंकि एक नोड तक पहुंचने के लिए आपको पहले इसे ढूंढना होगा...
उस स्थिति में, आपके पास एक्सेस के लिए O(log n) होगा।
लेकिन यदि आप एक विशिष्ट नोड का रेफरेंस रखते हैं (एक वेरिएबल के रूप में), तो वह O(1) एक्सेस टाइम होगा।
Trie डेटा स्ट्रक्चर
एक trie एक विशेष ट्री-जैसी डेटा स्ट्रक्चर है।
यह शब्दों के साथ काम करने के लिए उपयोगी है, और फिर उन शब्दों को तेजी से खोजने के लिए जो एक प्रीफिक्स से शुरू होते हैं, या पूरे शब्द को खोजें।
उपयोग:
- वर्ड गेम्स
- स्पेलिंग चेकर
- ऑटोकंप्लीट सुझाव
उदाहरण:
 # https://github.com/gonzedge/rambling-trie
require 'rambling-trie'
trie = Rambling::Trie.create('words.txt')
trie.include?('chocolate') # true
trie.include?('salmon') # true
टाइम कॉम्प्लेक्सिटी:
| Operation | Complexity |
|---|---|
| add | O(k) |
| include? | O(k) |
| words | O(k) |
इस तालिका में, मैं इनपुट स्ट्रिंग के आकार को दर्शाने के लिए k का उपयोग करता हूं, जबकि n का उपयोग डेटा स्ट्रक्चर के आकार को दर्शाने के लिए किया जाता है।
तो शब्द apple के लिए, k 5 होगा।
सारांश
आपने सामान्य डेटा स्ट्रक्चर्स, उनके मुख्य उपयोग और विशेषताओं, और Ruby में उनका उपयोग कैसे करें के बारे में सीखा।
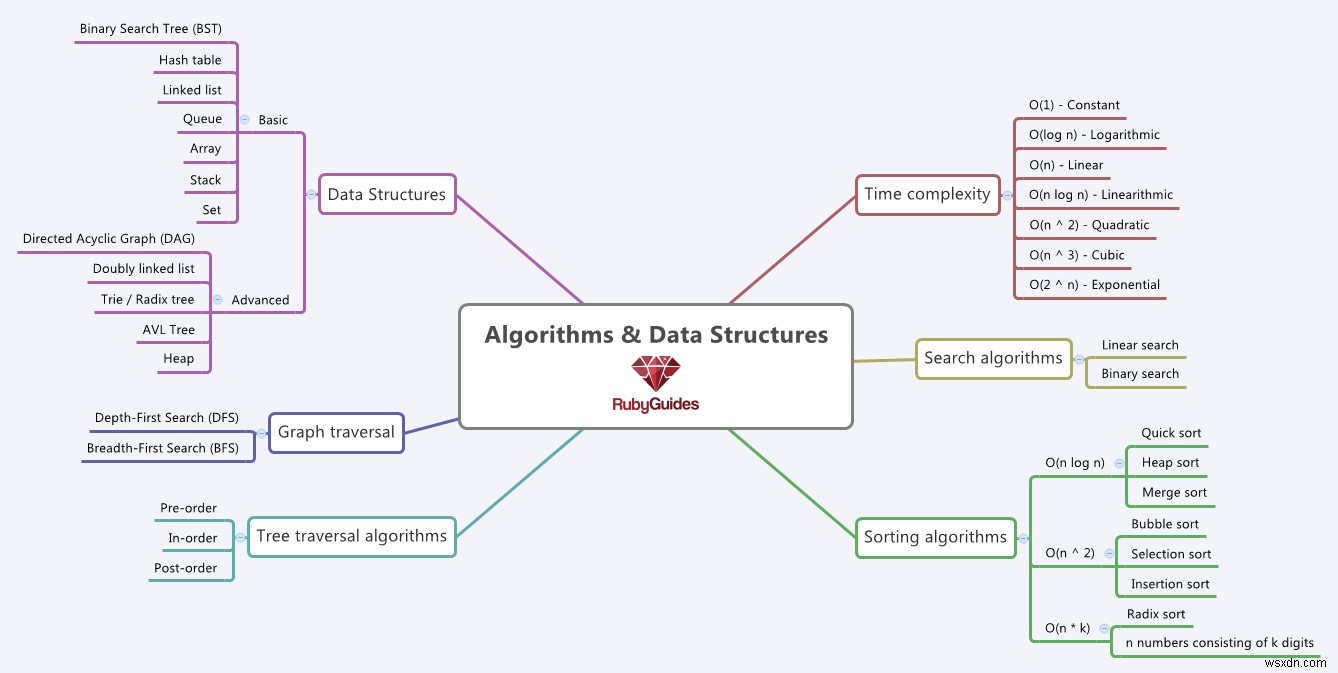
जब आप इस नए ज्ञान को लागू करेंगे तो आप समस्याओं को तेजी से हल करने में सक्षम होंगे!
क्या आप इस पोस्ट को मेरे लिए शेयर कर सकते हैं यदि आपने इसे उपयोगी पाया?
धन्यवाद 🙂