टाइम कॉम्प्लेक्सिटी कंप्यूटर साइंस से सीखने वाली सबसे दिलचस्प अवधारणाओं में से एक है, और इसे समझने के लिए आपको डिग्री की आवश्यकता नहीं है!
यह दिलचस्प है क्योंकि यह आपको यह देखने में मदद करता है कि कोई विशेष एल्गोरिदम या प्रोग्राम धीमा क्यों हो सकता है और आप इसे तेज़ बनाने के लिए क्या कर सकते हैं।
आप इसे अपने कोड पर लागू कर सकते हैं।
यह कंप्यूटर साइंस की किताबों में मिलने वाले सभी फैंसी एल्गोरिदम से आगे जाता है, जैसा कि मैं इस लेख में बाद में आपके लिए प्रदर्शित करूंगा।
लेकिन पहले हमें इस बारे में बात करने की ज़रूरत है कि क्या धीमा है और क्या तेज़।
धीमा बनाम तेज़
क्या 1 मिलियन संख्याओं को 150ms (मिलीसेकंड) में सॉर्ट करना धीमा या तेज़ है?
मुझे लगता है कि यह बहुत तेज़ है, लेकिन यह वह सवाल नहीं है जिसका टाइम कॉम्प्लेक्सिटी जवाब देने की कोशिश कर रही है।
हम जानना चाहते हैं कि "इनपुट आकार" बढ़ने पर एक एल्गोरिदम कैसा प्रदर्शन करेगा।
जब हम "इनपुट आकार" के बारे में बात करते हैं तो हम फंक्शन या मेथड के आर्ग्युमेंट्स के बारे में बात कर रहे हैं। यदि एक मेथड एक आर्ग्युमेंट के रूप में एक स्ट्रिंग लेता है तो वह इनपुट है, और स्ट्रिंग की लंबाई इनपुट आकार है।
बिग O नोटेशन
बिग O नोटेशन के साथ हम एल्गोरिदम को उनके प्रदर्शन के अनुसार वर्गीकृत कर सकते हैं।
यह ऐसा दिखता है:
O(1)
इस मामले में O(1) एक "कॉन्स्टेंट टाइम" एल्गोरिदम को दर्शाता है।
इसका मतलब है कि एल्गोरिदम को अपना काम खत्म करने में हमेशा समान समय लगेगा, चाहे उसे कितना भी काम करना पड़े।
एक और है "लिनियर टाइम":
O(n)
जहां "n" इनपुट के आकार को दर्शाता है (स्ट्रिंग आकार, सरणी आकार, आदि)। इसका मतलब है कि एल्गोरिदम अपना काम इनपुट आकार के 1:1 संबंध में खत्म करेगा, इसलिए इनपुट आकार को दोगुना करने से काम पूरा करने में लगने वाला समय भी दोगुना हो जाएगा।
यहां एक तालिका है:
| नोटेशन | नाम | विवरण |
|---|---|---|
| O(1) | कॉन्स्टेंट | हमेशा समान समय लेता है। |
| O(log n) | लॉगरिदमिक | हर लूप इटरेशन के बाद काम की मात्रा 2 से विभाजित होती है (बाइनरी सर्च)। |
| O(n) | लिनियर | काम पूरा करने का समय इनपुट आकार के 1 से 1 संबंध में बढ़ता है। |
| O(n log n) | लिनियरिथमिक | यह एक नेस्टेड लूप है, जहां इनर लूप log n समय में चलता है। उदाहरणों में क्विकसॉर्ट, मर्जसॉर्ट और हीपसॉर्ट शामिल हैं। |
| O(n^2) | क्वाड्रेटिक | काम पूरा करने का समय input size ^ 2 संबंध में बढ़ता है। आप इसे तब पहचान सकते हैं जब आपके पास एक लूप हो जो सभी तत्वों पर जाता है और लूप का हर इटरेशन भी हर तत्व पर जाता है। आपके पास एक नेस्टेड लूप है। |
| O(n^3) | क्यूबिक | n^2 जैसा ही, लेकिन समय n^3 संबंध में इनपुट आकार के साथ बढ़ता है। इसे पहचानने के लिए ट्रिपल नेस्टेड लूप देखें। |
| O(2^n) | एक्सपोनेंशियल | काम पूरा करने का समय 2 ^ input size संबंध में बढ़ता है। यह n^2 से बहुत धीमा है, इसलिए उन्हें भ्रमित न करें! एक उदाहरण रिकर्सिव फाइबोनैचि एल्गोरिदम है। |
एल्गोरिदम विश्लेषण
यदि आप इनपुट को "n" तत्वों की एक सरणी के रूप में सोचते हैं तो आप इसके लिए अपना अंतर्ज्ञान विकसित करना शुरू कर सकते हैं।
कल्पना करें कि आप सभी तत्वों को ढूंढना चाहते हैं जो सम संख्याएं हैं, ऐसा करने का एकमात्र तरीका हर तत्व को एक बार पढ़ना है यह देखने के लिए कि क्या यह शर्त से मेल खाता है।
[1,2,3,4,5,6,7,8,9,10].select(&:even?)
आप संख्याओं को छोड़ नहीं सकते क्योंकि आप उन कुछ संख्याओं को याद कर सकते हैं जिन्हें आप ढूंढ रहे हैं, इसलिए यह एक लिनियर टाइम एल्गोरिदम O(n) बनाता है।
एक ही समस्या के 3 अलग-अलग समाधान
व्यक्तिगत उदाहरणों का विश्लेषण दिलचस्प है, लेकिन जो वास्तव में इस विचार को समझने में मदद करता है वह यह देखना है कि हम एक ही समस्या को अलग-अलग समाधानों का उपयोग करके कैसे हल कर सकते हैं।
हम एक स्क्रैबल सॉल्यूशन चेकर के लिए 3 कोड उदाहरणों का पता लगाने जा रहे हैं।
स्क्रैबल एक खेल है जो वर्णों की एक सूची (जैसे ollhe) दिए जाने पर आपसे इन वर्णों का उपयोग करके शब्द (जैसे hello) बनाने के लिए कहता है।
यहां पहला समाधान है:
def scramble(characters, word) word.each_char.all? { |c| characters.count(c) >= word.count(c) } end क्या आप जानते हैं कि इस कोड की टाइम कॉम्प्लेक्सिटी क्या है? कुंजी count मेथड में है, इसलिए सुनिश्चित करें कि आप समझते हैं कि वह मेथड क्या करता है।
उत्तर है: O(n^2)।
और इसका कारण यह है कि each_char के साथ हम स्ट्रिंग word के सभी वर्णों पर जा रहे हैं। अकेले यह एक लिनियर टाइम एल्गोरिदम O(n) होगा, लेकिन ब्लॉक के अंदर हमारे पास count मेथड है।
यह मेथड प्रभावी रूप से एक और लूप है जो स्ट्रिंग के सभी वर्णों पर फिर से जाता है उन्हें गिनने के लिए।
दूसरा समाधान
ठीक है।
हम कैसे बेहतर कर सकते हैं? क्या हमें कुछ लूपिंग बचाने का कोई तरीका है?
वर्णों को गिनने के बजाय हम उन्हें हटा सकते हैं, इस तरह हमारे पास जाने के लिए कम वर्ण होंगे।
यहां दूसरा समाधान है:
def scramble(characters, word) characters = characters.dup word.each_char.all? { |c| characters.sub!(c, "") } end यह थोड़ा अधिक दिलचस्प है। यह बेस्ट केस में count संस्करण की तुलना में बहुत तेज़ होगा, जहां हम जिन वर्णों को ढूंढ रहे हैं वे स्ट्रिंग की शुरुआत के पास हैं।
लेकिन जब वर्ण सभी अंत में हैं, word में जिस क्रम में वे पाए जाते हैं उसके विपरीत क्रम में, प्रदर्शन count संस्करण के समान होगा, इसलिए हम कह सकते हैं कि यह अभी भी एक O(n^2) एल्गोरिदम है।
हमें उस मामले के बारे में चिंता करने की ज़रूरत नहीं है जहां word में कोई भी वर्ण उपलब्ध नहीं हैं, क्योंकि all? मेथड तब रुक जाएगा जब sub! false लौटाता है। लेकिन आप केवल यह जान पाएंगे यदि आपने रूबी का बड़े पैमाने पर अध्ययन किया है, नियमित रूबी कोर्सेज से कहीं आगे।
आइए दूसरे दृष्टिकोण के साथ प्रयास करें
क्या होगा यदि हम ब्लॉक के अंदर किसी भी प्रकार की लूपिंग को हटा दें? हम हैश के साथ ऐसा कर सकते हैं।
def scramble(characters, word) available = Hash.new(1) characters.each_char { |c| available[c] += 1 } word.each_char.all? { |c| available[c] -= 1; available[c] > 0 } end हैश मानों को पढ़ना और लिखना एक O(1) ऑपरेशन है, जिसका मतलब है कि यह काफी तेज़ है, विशेष रूप से लूपिंग की तुलना में।
हमारे पास अभी भी दो लूप हैं:
हैश टेबल बनाने के लिए एक, और इसे जांचने के लिए एक। क्योंकि ये लूप नेस्टेड नहीं हैं यह एक O(n) एल्गोरिदम है।
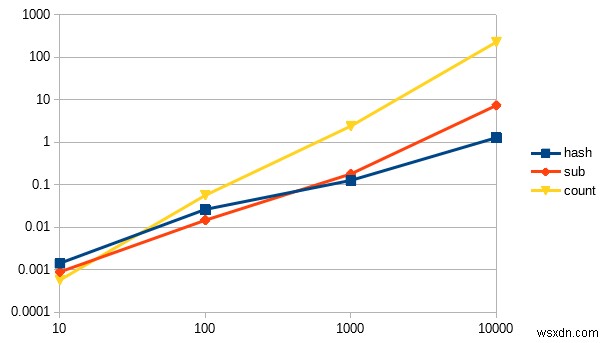
यदि हम इन 3 समाधानों को बेंचमार्क करते हैं तो हम देख सकते हैं कि हमारा विश्लेषण परिणामों से मेल खाता है:
hash 1.216667 0.000000 1.216667 ( 1.216007) sub 6.240000 1.023333 7.263333 ( 7.268173) count 222.866644 0.073333 222.939977 (223.440862)
यहां एक लाइन चार्ट है:
कुछ चीजें नोटिस करें:
- Y अक्ष (लंबवत) दर्शाता है कि काम पूरा करने में कितने सेकंड लगे, जबकि X अक्ष (क्षैतिज) इनपुट आकार को दर्शाता है।
- यह एक लॉगरिदमिक चार्ट है, जो एक निश्चित सीमा में मानों को संपीड़ित करता है, लेकिन वास्तव में
countलाइन बहुत अधिक खड़ी है। - मैंने इसे लॉगरिदमिक चार्ट बनाया है ताकि आप एक दिलचस्प प्रभाव की सराहना कर सकें, बहुत छोटे इनपुट आकार के साथ
countवास्तव में तेज़ है!
सारांश
आपने एल्गोरिदमिक टाइम कॉम्प्लेक्सिटी, बिग O नोटेशन और टाइम कॉम्प्लेक्सिटी विश्लेषण के बारे में सीखा। आपने कुछ उदाहरण भी देखे जहां हम एक ही समस्या के अलग-अलग समाधानों की तुलना करते हैं और उनके प्रदर्शन का विश्लेषण करते हैं।
आशा है कि आपने कुछ नया और दिलचस्प सीखा!
यदि आपने किया तो कृपया इस पोस्ट को सोशल मीडिया पर शेयर करें और न्यूज़लेटर की सदस्यता लें यदि आपने अभी तक नहीं किया है ताकि मैं आपको ऐसी और सामग्री भेज सकूं।
पढ़ने के लिए धन्यवाद।