यह बहुत संभावना है कि आपने UndefinedConversionError या IncompatibleCharacterEncodings जैसे Ruby एक्सेप्शन देखे हैं। यह कम संभावना है कि आपने समझा हो कि एक्सेप्शन का क्या अर्थ है। यह लेख मदद करेगा। आप सीखेंगे कि कैरेक्टर एन्कोडिंग कैसे काम करती है और Ruby में इसे कैसे लागू किया जाता है। अंत तक, आप इन त्रुटियों को अधिक आसानी से समझ और ठीक कर पाएंगे।
तो "कैरेक्टर एन्कोडिंग" वैसे भी क्या है?
हर प्रोग्रामिंग भाषा में, आप स्ट्रिंग्स के साथ काम करते हैं। कभी-कभी आप उन्हें इनपुट के रूप में प्रोसेस करते हैं, कभी-कभी आप उन्हें आउटपुट के रूप में प्रदर्शित करते हैं। लेकिन आपका कंप्यूटर "स्ट्रिंग्स" को नहीं समझता। यह केवल बिट्स समझता है: 1 और 0। स्ट्रिंग्स को बिट्स में बदलने की प्रक्रिया को कैरेक्टर एन्कोडिंग कहा जाता है।
लेकिन कैरेक्टर एन्कोडिंग केवल कंप्यूटर के युग से संबंधित नहीं है। हम कंप्यूटर होने से पहले एक सरल प्रक्रिया से सीख सकते हैं: मोर्स कोड।
मोर्स कोड
मोर्स कोड अपनी परिभाषा में बहुत सरल है। आपके पास सिग्नल उत्पन्न करने के दो प्रतीक या तरीके हैं (छोटा और लंबा)। उन दो प्रतीकों के साथ, आप एक सरल अंग्रेजी वर्णमाला का प्रतिनिधित्व करते हैं। उदाहरण के लिए:
- A है .- (एक छोटा निशान और एक लंबा निशान)
- E है . (एक छोटा निशान)
- O है --- (तीन लंबे निशान)
इस प्रणाली का आविष्कार 1837 के आसपास हुआ था और इसने केवल दो प्रतीकों या संकेतों के साथ पूरी वर्णमाला को एन्कोड करने की अनुमति दी।
आप यहां ऑनलाइन एक ट्रांसलेटर के साथ खेल सकते हैं।
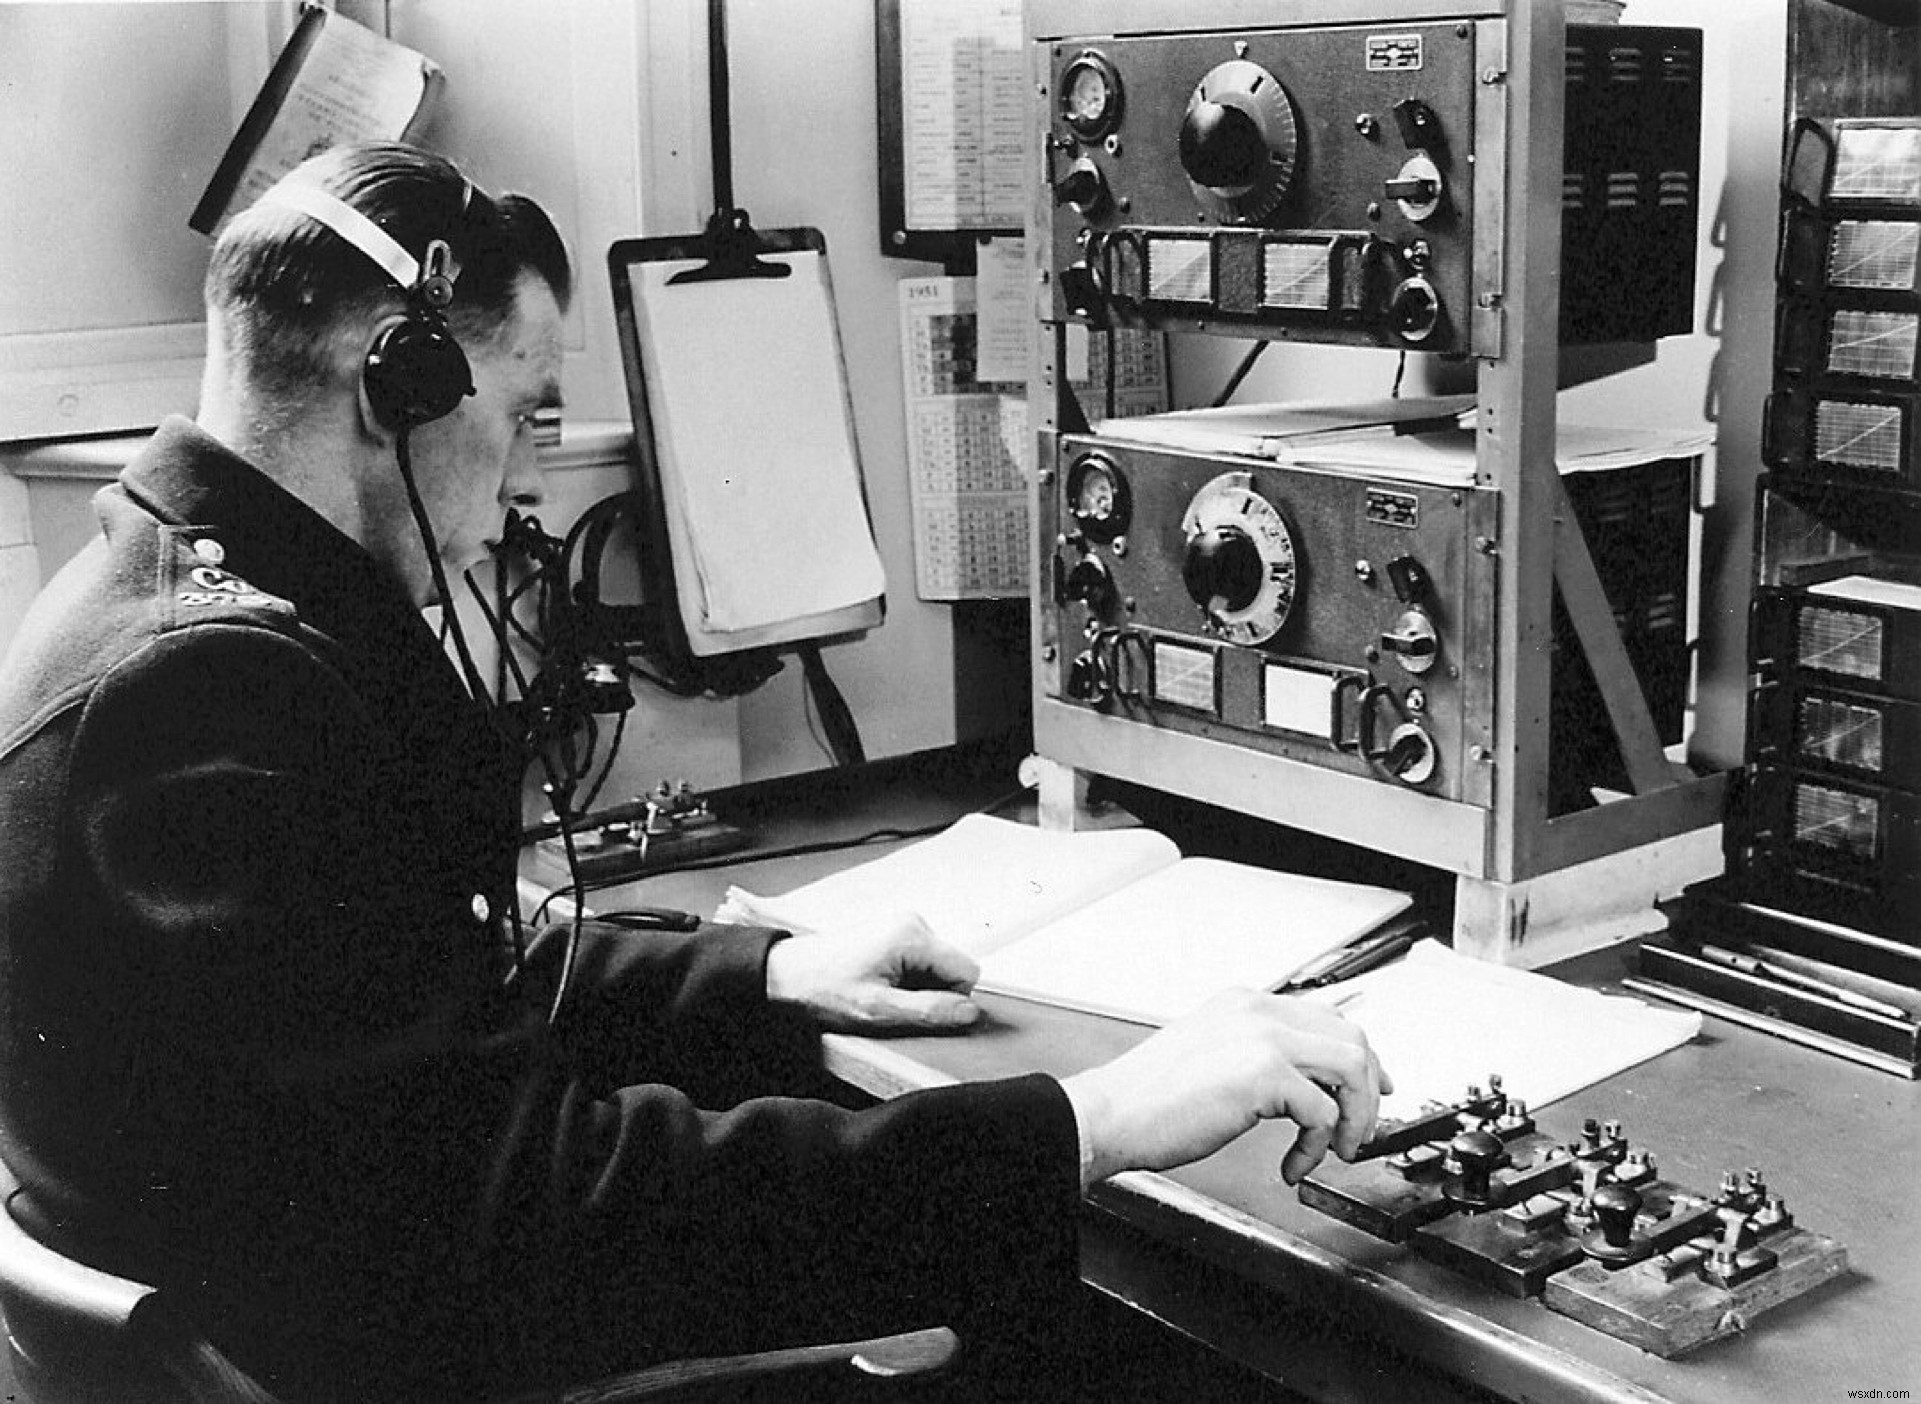
छवि में आप एक "एन्कोडर" देख सकते हैं, जो संदेशों को एन्कोड और डिकोड करने के लिए जिम्मेदार व्यक्ति है। यह जल्द ही कंप्यूटर के आगमन के साथ बदल जाएगा।
मैन्युअल से ऑटोमैटिक एन्कोडिंग
एक संदेश को एन्कोड करने के लिए, आपको मोर्स कोड के एल्गोरिदम का पालन करते हुए कैरेक्टर्स को प्रतीकों में मैन्युअली अनुवाद करने के लिए एक व्यक्ति की आवश्यकता होती है।
मोर्स कोड के समान, कंप्यूटर केवल दो "प्रतीकों" का उपयोग करते हैं: 1 और 0। आप कंप्यूटर में केवल इनका अनुक्रम संग्रहीत कर सकते हैं, और जब वे पढ़े जाते हैं, तो उन्हें उपयोगकर्ता के लिए समझ में आने वाले तरीके से व्याख्या करने की आवश्यकता होती है।
दोनों मामलों में प्रक्रिया इस तरह काम करती है:
संदेश -> एन्कोडिंग -> स्टोर/भेजें -> डिकोडिंग -> संदेशमोर्स कोड में SOS होगा:
SOS -> Encode('SOS') -> ...---... -> Decode('...---...') -> SOS
----------------------- --------------------------
भेजने वाला                       प्राप्तकर्ता
कंप्यूटर और अन्य तकनीक के साथ एक बड़ा बदलाव यह था कि एन्कोडिंग और डिकोडिंग की प्रक्रिया स्वचालित हो गई थी इसलिए हमें जानकारी का अनुवाद करने के लिए लोगों की आवश्यकता नहीं रही।
जब कंप्यूटर का आविष्कार हुआ, तो कैरेक्टर्स को 1 और 0 में स्वचालित रूप से बदलने के लिए बनाए गए प्रारंभिक मानकों में से एक (हालांकि पहला नहीं) ASCII था।
ASCII का मतलब अमेरिकन स्टैंडर्ड कोड फॉर इंफॉर्मेशन इंटरचेंज है। "अमेरिकन" भाग ने कुछ समय के लिए कंप्यूटरों के सूचना के साथ काम करने के तरीके में महत्वपूर्ण भूमिका निभाई; हम अगले खंड में देखेंगे कि क्यों।
ASCII (1963)
टेलीग्राफिक कोड जैसे मोर्स कोड और बहुत प्रारंभिक कंप्यूटर के ज्ञान के आधार पर, कंप्यूटर में कैरेक्टर्स को एन्कोड और डिकोड करने के लिए 1963 के आसपास एक मानक बनाया गया था। यह प्रणाली अपेक्षाकृत सरल थी क्योंकि यह पहले केवल 127 कैरेक्टर्स को कवर करती थी, अंग्रेजी वर्णमाला प्लस अतिरिक्त प्रतीक।
ASCII प्रत्येक कैरेक्टर को एक दशमलव संख्या के साथ जोड़कर काम करता था जिसे बाइनरी कोड में अनुवादित किया जा सकता था। आइए एक उदाहरण देखें:
"A" ASCII में 65 है, इसलिए हमें 65 को बाइनरी कोड में अनुवाद करने की आवश्यकता है।
यदि आप नहीं जानते कि यह कैसे काम करता है, तो यहाँ एक त्वरित तरीका है: हम 65 को 2 से विभाजित करना शुरू करते हैं और तब तक जारी रखते हैं जब तक हमें 0 नहीं मिल जाता। यदि विभाजन सटीक नहीं है, तो हम शेष के रूप में 1 जोड़ते हैं:
65 / 2 = 32 + 1
32 / 2 = 16 + 0
16 / 2 = 8 + 0
8 / 2 = 4 + 0
4 / 2 = 2 + 0
2 / 2 = 1 + 0
1 / 2 = 0 + 1
अब, हम शेष को लेते हैं और उन्हें उल्टे क्रम में रखते हैं:
1000001तो हम मूल ASCII एन्कोडिंग के साथ "A" को "1000001" के रूप में संग्रहीत करेंगे, जिसे अब US-ASCII के रूप में जाना जाता है। आजकल, 8-बिट कंप्यूटर आम होने के साथ, यह 01000001 होगा (8 बिट्स = 1 बाइट)।
हम प्रत्येक कैरेक्टर के लिए उसी प्रक्रिया का पालन करते हैं, इसलिए 7 बिट्स के साथ, हम 2^7 कैरेक्टर्स = 127 तक संग्रहीत कर सकते हैं।
यहाँ पूरी तालिका है:
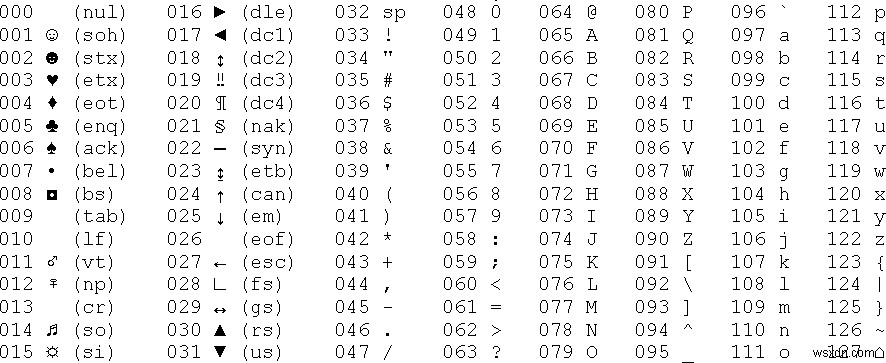 (https://www.plcdev.com/ascii_chart से)
ASCII के साथ समस्या
क्या होगा यदि हम एक और कैरेक्टर जोड़ना चाहते हैं, जैसे फ्रेंच ç या जापानी कैरेक्टर 大?
हाँ, हमें एक समस्या होगी।
ASCII के बाद, लोगों ने अपने स्वयं के एन्कोडिंग सिस्टम बनाकर इस समस्या को हल करने की कोशिश की। उन्होंने अधिक बिट्स का उपयोग किया, लेकिन इससे अंततः एक और समस्या हुई।
मुख्य मुद्दा यह था कि जब एक फ़ाइल पढ़ी जाती है, तो आपको नहीं पता था कि आपके पास एक निश्चित एन्कोडिंग सिस्टम है। इसे गलत एन्कोडिंग के साथ व्याख्या करने का प्रयास करने के परिणामस्वरूप "" या "Ã,ÂÂÂÂ" जैसा बकवास होता था।
उन एन्कोडिंग सिस्टम का विकास बड़ा और व्यापक था। भाषा के आधार पर, आपके पास अलग-अलग सिस्टम थे। अधिक कैरेक्टर्स वाली भाषाओं, जैसे चीनी, को अपने अल्फाबेट को एन्कोड करने के लिए अधिक जटिल सिस्टम विकसित करने पड़े।
इसके साथ कई वर्षों तक संघर्ष करने के बाद, एक नया मानक बनाया गया: यूनिकोड। इस मानक ने परिभाषित किया कि आधुनिक कंप्यूटर जानकारी को कैसे एन्कोड और डिकोड करते हैं।
यूनिकोड (1988)
यूनिकोड का लक्ष्य बहुत सरल है। इसकी आधिकारिक साइट के अनुसार: "हर कैरेक्टर के लिए एक अद्वितीय संख्या प्रदान करना, चाहे प्लेटफॉर्म, प्रोग्राम, या भाषा कोई भी हो।"
तो एक भाषा में प्रत्येक कैरेक्टर को एक अद्वितीय कोड असाइन किया गया है, जिसे कोड पॉइंट के रूप में भी जाना जाता है। वर्तमान में 137,000 से अधिक कैरेक्टर्स हैं।
यूनिकोड मानक के भाग के रूप में, उन वैल्यूज़ या कोड पॉइंट्स को एन्कोड करने के हमारे पास अलग-अलग तरीके हैं, लेकिन UTF-8 सबसे व्यापक है।
Go प्रोग्रामिंग भाषा बनाने वाले वही लोग, रॉब पाइक और केन थॉम्पसन, ने UTF-8 भी बनाया। यह सफल हुआ क्योंकि यह कुशल है और चतुर है कि यह उन संख्याओं को कैसे एन्कोड करता है। आइए देखें वास्तव में क्यों।
UTF-8: यूनिकोड ट्रांसफॉर्मेशन फॉर्मेट (1993)
UTF-8 अब वेबसाइटों के लिए वास्तविक एन्कोडिंग है (94% से अधिक वेबसाइटें उस एन्कोडिंग का उपयोग करती हैं)। यह कई प्रोग्रामिंग भाषाओं और फ़ाइलों के लिए डिफ़ॉल्ट एन्कोडिंग भी है। तो यह इतना सफल क्यों था और यह कैसे काम करता है?
UTF-8, अन्य एन्कोडिंग सिस्टम की तरह, यूनिकोड में परिभाषित संख्याओं को बाइनरी में बदलकर उन्हें कंप्यूटर में संग्रहीत करता है।
UTF-8 के दो बहुत महत्वपूर्ण पहलू हैं: - यह बिट्स संग्रहीत करने में कुशल है, क्योंकि एक कैरेक्टर 1 से 4 बाइट्स ले सकता है। - यूनिकोड और बाइट्स की एक डायनामिक मात्रा का उपयोग करके, यह ASCII एन्कोडिंग के साथ संगत है क्योंकि पहले 127 कैरेक्टर 1 बाइट लेते हैं। इसका मतलब है कि आप ASCII फ़ाइल को UTF-8 के रूप में खोल सकते हैं।
आइए देखें कि UTF-8 कैसे काम करता है।
UTF-8 1 बाइट के साथ
यूनिकोड तालिका में वैल्यू के आधार पर, UTF-8 विभिन्न संख्या में कैरेक्टर्स का उपयोग करता है।
पहले 127 के साथ, यह निम्न टेम्पलेट का उपयोग करता है: 0_______
तो 0 हमेशा वहां रहेगा, उसके बाद यूनिकोड में वैल्यू का प्रतिनिधित्व करने वाली बाइनरी संख्या (जो ASCII भी होगी) आएगी। उदाहरण के लिए: A = 65 = 1000001।
आइए Ruby में String में unpack मेथड का उपयोग करके इसे चेक करें:
'A'.unpack('B*').first # 01000001B का अर्थ है कि हम सबसे महत्वपूर्ण बिट के साथ बाइनरी फॉर्मेट चाहते हैं। इस संदर्भ में, इसका मतलब है उच्चतम मूल्य वाला बिट। एस्टेरिस्क Ruby को तब तक जारी रखने के लिए कहता है जब तक कोई और बिट नहीं बचे। यदि हम एक संख्या का उपयोग करते, तो हमें केवल उस संख्या तक के बिट्स मिलते:
'A'.unpack('B4').first # 01000UTF-8 2 बाइट्स के साथ
यदि हमारे पास एक कैरेक्टर है जिसकी यूनिकोड में वैल्यू या कोड पॉइंट 127 से परे है, 2047 तक, तो हम निम्न टेम्पलेट के साथ दो बाइट्स का उपयोग करते हैं:
110_____ 10______तो हमारे पास यूनिकोड में वैल्यू के लिए 11 खाली बिट्स हैं। आइए एक उदाहरण देखें:
À यूनिकोड में 192 है, इसलिए बाइनरी में यह 11000000 है, 8 बिट्स लेता है। यह पहले टेम्पलेट में फिट नहीं होता, इसलिए हम दूसरे का उपयोग करते हैं:
110_____ 10______हम दाएं से बाएं स्पेस भरना शुरू करते हैं:
110___11 10000000उन खाली बिट्स का क्या होता है? हम बस 0 डालते हैं, इसलिए अंतिम परिणाम है: 11000011 10000000।
हम यहां एक पैटर्न देखना शुरू कर सकते हैं। यदि हम बाएं से दाएं पढ़ना शुरू करते हैं, तो पहले 8 बिट्स के समूह की शुरुआत में दो 1 हैं। इसका तात्पर्य है कि कैरेक्टर 2 बाइट्स लेने वाला है:
11000011 10000000 --फिर से, हम इसे Ruby से चेक कर सकते हैं:
'À'.unpack('B*').first # 1100001110000000यहां एक छोटी सी टिप है कि हम आउटपुट को बेहतर तरीके से फॉर्मेट कर सकते हैं:
'À'.unpack('B8 B8').join(' ') # 11000011 10000000हम 'À'.unpack('B8 B8') से एक ऐरे प्राप्त करते हैं और फिर तत्वों को स्पेस के साथ जोड़कर एक स्ट्रिंग प्राप्त करते हैं। अनपैक पैरामीटर में 8s Ruby को 2 समूहों में 8 बिट्स प्राप्त करने के लिए कहता है।
UTF-8 3 बाइट्स के साथ
यदि किसी कैरेक्टर के लिए यूनिकोड में वैल्यू पिछले टेम्पलेट में उपलब्ध 11 बिट्स में फिट नहीं होती है, तो हमें एक अतिरिक्त बाइट की आवश्यकता है:
1110____ 10______ 10______फिर से, टेम्पलेट की शुरुआत में तीन 1 हमें बताते हैं कि हम 3-बाइट कैरेक्टर पढ़ने वाले हैं।
इसी प्रक्रिया को इस टेम्पलेट पर लागू किया जाएगा; यूनिकोड वैल्यू को बाइनरी में बदलें और दाएं से बाएं स्लॉट भरना शुरू करें। यदि उसके बाद कुछ खाली स्थान हैं, तो उन्हें 0 से भरें।
UTF-8 4 बाइट्स के साथ
कुछ वैल्यूज़ पिछले टेम्पलेट में हमारे 11 खाली बिट्स से भी अधिक लेती हैं। आइए इमोजी 🙂 के साथ एक उदाहरण देखें, जिसे यूनिकोड के लिए "a" या "大" जैसे कैरेक्टर के रूप में भी देखा जा सकता है।
"🙂" की यूनिकोड में वैल्यू या कोड पॉइंट 128578 है। वह संख्या बाइनरी में है: 11111011001000010, 17 बिट्स। इसका मतलब है कि यह 3-बाइट टेम्पलेट में फिट नहीं होता क्योंकि हमारे पास केवल 16 खाली स्लॉट थे, इसलिए हमें एक नए टेम्पलेट का उपयोग करने की आवश्यकता है जो मेमोरी में 4 बाइट्स लेता है:
11110___ 10______ 10______ 10______हम फिर से बाइनरी में संख्या के साथ इसे भरना शुरू करते हैं: 11110___ 10_11111 10011001 10000010
और अब, हम बाकी को 0 से भरते हैं: 1111000 10011111 10011001 10000010
आइए देखें कि यह Ruby में कैसा दिखता है।
चूंकि हम पहले से ही जानते हैं कि यह 4 बाइट्स लेगा, हम आउटपुट में बेहतर पठनीयता के लिए अनुकूलित कर सकते हैं:
'🙂'.unpack('B8 B8 B8 B8').join(' ') # 11110000 10011111 10011001 10000010लेकिन अगर हम नहीं जानते, तो हम बस उपयोग कर सकते हैं:
'🙂'.unpack('B*')हम बाइट्स को ऐरे में निकालने के लिए "bytes" स्ट्रिंग मेथड का भी उपयोग कर सकते हैं:
"🙂".bytes # [240, 159, 153, 130]और फिर, हम तत्वों को बाइनरी में मैप कर सकते हैं:
"🙂".bytes.map {|e| e.to_s 2} # ["11110000", "10011111", "10011001", "10000010"]और अगर हम एक स्ट्रिंग चाहते हैं, तो हम join का उपयोग कर सकते हैं:
"🙂".bytes.map {|e| e.to_s 2}.join(' ') # 11110000 10011111 10011001 10000010UTF-8 में यूनिकोड से अधिक जगह है
UTF-8 का एक और महत्वपूर्ण पहलू यह है कि यह सभी यूनिकोड वैल्यूज़ (या कोड पॉइंट्स) को शामिल कर सकता है -- और न केवल वे जो आज मौजूद हैं बल्कि वे भी जो भविष्य में मौजूद होंगे।
ऐसा इसलिए है क्योंकि UTF-8 में, 4-बाइट टेम्पलेट के साथ, हमारे पास भरने के लिए 21 स्लॉट हैं। इसका मतलब है कि हम 2^21 (= 2,097,152) वैल्यूज़ तक संग्रहीत कर सकते हैं, मानक के साथ हमारे पास अब तक की सबसे बड़ी मात्रा में यूनिकोड वैल्यूज़, लगभग 1.1 मिलियन से कहीं अधिक।
इसका मतलब है कि हम UTF-8 का उपयोग इस विश्वास के साथ कर सकते हैं कि भविष्य में नए कैरेक्टर्स या भाषाओं को आवंटित करने के लिए हमें किसी अन्य एन्कोडिंग सिस्टम पर स्विच करने की आवश्यकता नहीं होगी।
Ruby में विभिन्न एन्कोडिंग्स के साथ काम करना
Ruby में, हम दिए गए स्ट्रिंग की एन्कोडिंग को तुरंत देखकर देख सकते हैं:
'Hello'.encoding.name # "UTF-8"हम एक स्ट्रिंग को एक अलग एन्कोडिंग सिस्टम के साथ भी एन्कोड कर सकते हैं। उदाहरण के लिए:
encoded_string = 'hello, how are you?'.encode("ISO-8859-1", "UTF-8")
encoded_string.encoding.name # ISO-8859-1
यदि परिवर्तन संगत नहीं है, तो हमें डिफ़ॉल्ट रूप से एक त्रुटि मिलती है। मान लें कि हम "hello 🙂" को UTF-8 से ASCII में बदलना चाहते हैं। चूंकि इमोजी "🙂" ASCII में फिट नहीं होता, हम नहीं कर सकते। Ruby उस मामले में एक त्रुटि उठाता है:
"hello 🙂".encode("ASCII", "UTF-8") # Encoding::UndefinedConversionError (U+1F642 from UTF-8 to US-ASCII)लेकिन Ruby हमें अपवाद रखने की अनुमति देता है जहां, यदि एक कैरेक्टर एन्कोड नहीं किया जा सकता है, तो हम इसे "?" से बदल सकते हैं।
"hello 🙂".encode("ASCII", "UTF-8", undef: :replace) # hello ?हमारे पास कुछ कैरेक्टर्स को नई एन्कोडिंग में एक वैध कैरेक्टर से बदलने का विकल्प भी है:
"hello 🙂".encode("ASCII", "UTF-8", fallback: {"🙂" => ":)"}) # hello :)Ruby में स्क्रिप्ट की एन्कोडिंग का निरीक्षण करना
आप जिस स्क्रिप्ट फ़ाइल पर काम कर रहे हैं, यानी ".rb" फ़ाइल की एन्कोडिंग देखने के लिए, आप निम्न कर सकते हैं:
__ENCODING__ # यह मेरे मामले में "#<Encoding:UTF-8>" दिखाएगा।Ruby 2.0 से, Ruby स्क्रिप्ट्स के लिए डिफ़ॉल्ट एन्कोडिंग UTF-8 है, लेकिन आप इसे पहली लाइन में एक टिप्पणी के साथ बदल सकते हैं:
# encoding: ASCII
__ENCODING__ # #<Encoding:US-ASCII>
लेकिन जब तक आपके पास इसे बदलने का बहुत अच्छा कारण न हो, UTF-8 मानक पर टिके रहना बेहतर है।
Ruby में एन्कोडिंग्स के साथ काम करने के कुछ टिप्स
आप Encoding.name_list के साथ Ruby में समर्थित एन्कोडिंग्स की पूरी सूची देख सकते हैं। यह एक बड़ा ऐरे लौटाएगा:
["ASCII-8BIT", "UTF-8", "US-ASCII", "UTF-16BE", "UTF-16LE", "UTF-32BE", "UTF-32LE", "UTF-16", "UTF-32", "UTF8-MAC"...]अंग्रेजी भाषा के बाहर कैरेक्टर्स के साथ काम करते समय दूसरा महत्वपूर्ण पहलू यह है कि Ruby 2.4 से पहले, upcase या reverse जैसे कुछ मेथड्स अपेक्षा के अनुरूप काम नहीं करते थे। उदाहरण के लिए, Ruby 2.3 में, upcase आपकी अपेक्षा के अनुरूप काम नहीं करता:
# Ruby 2.3
'öıüëâñà'.upcase # 'öıüëâñà'
समाधान Rails से ActiveSupport, या किसी अन्य बाहरी जेम का उपयोग करना था, लेकिन Ruby 2.4 से हमारे पास पूर्ण यूनिकोड केस मैपिंग है:
# Ruby 2.4 और ऊपर से
'öıüëâñà'.upcase # 'ÖIÜËÂÑÀ'
इमोजी के साथ कुछ मज़ा
आइए देखें कि इमोजी यूनिकोड और Ruby में कैसे काम करते हैं:
'🖖'.chars # ["🖖"]यह "मध्य और अनामिका उंगलियों के बीच भाग के साथ उठा हुआ हाथ" है, जिसे "वल्कन सैल्यूट" इमोजी के रूप में भी जाना जाता है। यदि हमारे पास वही इमोजी है लेकिन डिफ़ॉल्ट नहीं किसी अन्य स्किन टोन में, तो कुछ दिलचस्प होता है:
'🖖🏾'.chars # ["🖖", "🏾"]तो एक ही कैरेक्टर होने के बजाय, हमारे पास एक इमोजी के लिए दो हैं।
वहां क्या हुआ?
खैर, यूनिकोड में कुछ कैरेक्टर्स को कई कैरेक्टर्स के संयोजन के रूप में परिभाषित किया गया है। इस मामले में, यदि कंप्यूटर इन दो कैरेक्टर्स को एक साथ देखता है, तो यह स्किन टोन लागू करके केवल एक दिखाता है।
एक और मजेदार उदाहरण हम फ्लैग्स के साथ देख सकते हैं।
'🇦🇺'.chars # ["🇦", "🇺"]यूनिकोड में, फ्लैग इमोजी आंतरिक रूप से कुछ अमूर्त यूनिकोड कैरेक्टर्स द्वारा दर्शाए जाते हैं जिन्हें "रीजनल इंडिकेटर सिंबल्स" कहा जाता है जैसे 🇦 या 🇿। वे आमतौर पर फ्लैग्स के बाहर उपयोग नहीं किए जाते, और जब कंप्यूटर दो प्रतीकों को एक साथ देखता है, तो यह फ्लैग दिखाता है यदि उस संयोजन के लिए एक है।
खुद देखने के लिए, इसे कॉपी करने और किसी भी टेक्स्ट एडिटर या फील्ड में कॉमा हटाने का प्रयास करें:
🇦,🇺निष्कर्ष
मुझे आशा है कि यूनिकोड और UTF-8 कैसे काम करते हैं और वे Ruby और संभावित त्रुटियों से कैसे संबंधित हैं, इसकी यह समीक्षा आपके लिए उपयोगी थी।
सबसे महत्वपूर्ण सबक यह याद रखना है कि जब आप किसी भी प्रकार के टेक्स्ट के साथ काम कर रहे होते हैं तो एक संबद्ध एन्कोडिंग सिस्टम होता है, और इसे संग्रहीत करते या बदलते समय मौजूद रखना महत्वपूर्ण है। यदि आप कर सकते हैं, तो UTF-8 जैसे आधुनिक एन्कोडिंग सिस्टम का उपयोग करें ताकि आपको भविष्य में इसे बदलने की आवश्यकता न हो।
Ruby रिलीज़ के बारे में नोट
मैंने इस लेख में सभी उदाहरणों के लिए Ruby 2.6.5 का उपयोग किया है। आप उन्हें ऑनलाइन REPL में या स्थानीय रूप से अपने टर्मिनल पर जाकर और irb निष्पादित करके आज़मा सकते हैं यदि आपके पास Ruby इंस्टॉल है।
चूंकि यूनिकोड सपोर्ट में पिछले रिलीज़ में सुधार हुआ है, मैंने नवीनतम का उपयोग करने का विकल्प चुना ताकि यह लेख प्रासंगिक रहे। किसी भी मामले में, Ruby 2.4 और ऊपर के साथ, सभी उदाहरण यहां दिखाए अनुसार काम करने चाहिए।