हैश टेबल एक डेटा संरचना है जो डेटा को एक एसोसिएटिव तरीके से स्टोर करती है। हैश टेबल में, डेटा ऐरे फॉर्मेट में स्टोर होता है, जहां प्रत्येक डेटा वैल्यू का अपना यूनिक इंडेक्स वैल्यू होता है। यदि हमें वांछित डेटा का इंडेक्स पता है तो डेटा तक पहुंच बहुत तेज हो जाती है।
इस प्रकार, यह एक ऐसी डेटा संरचना बन जाती है जिसमें इंसर्शन और सर्च ऑपरेशन डेटा के आकार की परवाह किए बिना बहुत तेज होते हैं। हैश टेबल स्टोरेज माध्यम के रूप में एक ऐरे का उपयोग करती है और हैश तकनीक का उपयोग करके एक इंडेक्स उत्पन्न करती है जहां एक एलिमेंट को इंसर्ट किया जाना है या उससे स्थित किया जाना है।
हैशिंग
हैशिंग की वैल्यूज़ की एक रेंज को ऐरे के इंडेक्स की रेंज में बदलने की एक तकनीक है। हम की वैल्यूज़ की एक रेंज प्राप्त करने के लिए मॉड्यूलो ऑपरेटर का उपयोग करने जा रहे हैं। आकार 20 की एक हैश टेबल पर विचार करें, और निम्नलिखित आइटम स्टोर किए जाने हैं। आइटम (की, वैल्यू) फॉर्मेट में है।
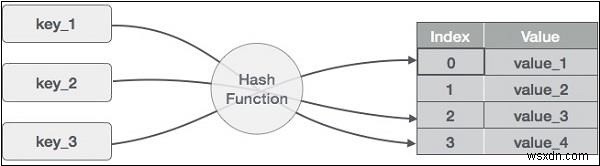
यहां हमारे पास एक हैश फ़ंक्शन है जो कीज़ लेता है और एक टेबल के लिए इंडेक्स उत्पन्न करता है। ये इंडेक्स हमें बताते हैं कि वैल्यू कहां स्टोर है। अब जब भी हम किसी की से जुड़ी वैल्यू को खोजना चाहते हैं, तो हमें बस उस की पर फिर से हैश फ़ंक्शन चलाना होगा और लगभग कॉन्स्टेंट टाइम में वैल्यू प्राप्त करनी होगी।
हैश फ़ंक्शन डिज़ाइन करना काफी कठिन होता है। आइए एक उदाहरण लेते हैं:
मान लीजिए हमारे पास निम्नलिखित हैश फ़ंक्शन है:
उदाहरण
function modBy11(key) {
    return key % 11;
}
और हम इसे उन की-वैल्यू जोड़ियों पर चलाना शुरू करते हैं जिन्हें हम स्टोर करना चाहते हैं, उदाहरण के लिए:
- (15, 20) - हैश कोड: 4
- (25, 39) - हैश कोड: 3
- (8, 55) - हैश कोड: 8
- (26, 84) - हैश कोड: 4
यहां हम देखते हैं कि हमारे पास एक कोलिजन है, यानी, अगर हम पहले 15 को स्टोर करते हैं और फिर इस हैश फ़ंक्शन के साथ की 26 का सामना करते हैं, तो यह इस एंट्री को उसी होल में फिक्स करने की कोशिश करेगा। इसे कोलिजन कहा जाता है। और ऐसी स्थितियों को संभालने के लिए, हमें कोलिजन हैंडलिंग मैकेनिज्म को परिभाषित करने की आवश्यकता होती है। कुछ अच्छी तरह से परिभाषित सरल कोलिजन रिज़ॉल्यूशन एल्गोरिदम हैं। उदाहरण के लिए:
- लीनियर प्रोबिंग: इस एल्गोरिदम में, हम अगले सेल को देखकर ऐरे में अगली खाली लोकेशन खोज सकते हैं जब तक कि हमें एक खाली सेल न मिल जाए। हमारे उदाहरण में, चूंकि 4 पर होल लिया गया है, हम इसे 5 में भर सकते हैं।
- सेपरेट चेनिंग: इस कार्यान्वयन में: हम हैश टेबल में प्रत्येक लोकेशन को एक लिस्ट के साथ जोड़ते हैं। जब भी हमें कोलिजन मिलता है, हम इस लिस्ट के अंत में की-वैल्यू जोड़ी को जोड़ देते हैं। अगर चेन लंबी होती रहती हैं तो इससे सर्च टाइम बहुत लंबा हो सकता है।
अब जब हम समझ गए हैं कि हैश टेबल कैसे काम करती है और हम कोलिजन रिज़ॉल्यूशन का उपयोग कैसे कर सकते हैं, तो आइए HashTable क्लास को लागू करते हैं।
हम लागू करेंगे ये मेथड्स
हम अपने कार्यान्वयन में इन मेथड्स को लागू करेंगे:
- put(key, value): हैश टेबल में एक नई की-वैल्यू जोड़ी जोड़ता है
- get(key): एक की से जुड़ी वैल्यू प्राप्त करता है
- remove(key): टेबल से की-वैल्यू जोड़ी को हटाता है
- forEach(): सभी की-वैल्यू जोड़ियों पर पुनरावृत्ति करने की अनुमति देता है
- static join(): 2 हैश टेबल को एक नई में जोड़ने के लिए एक स्टैटिक मेथड