इस असाइनमेंट में हम फ़ाइलों के साथ काम करते हैं। फ़ाइलें इस ब्रह्मांड में हर जगह हैं। कंप्यूटर सिस्टम में फ़ाइलें आवश्यक भाग हैं। ऑपरेटिंग सिस्टम में बहुत सारी फ़ाइलें होती हैं।
पायथन में दो प्रकार की फ़ाइलें होती हैं - टेक्स्ट फ़ाइलें और बाइनरी फ़ाइलें।
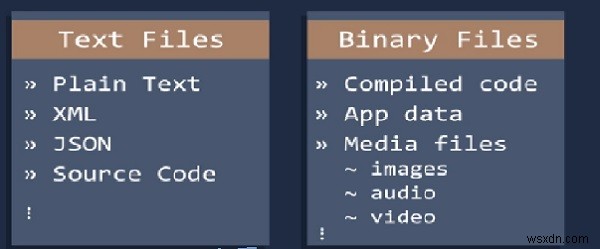
यहाँ हम टेक्स्ट फ़ाइलों के बारे में चर्चा करते हैं
यहाँ हम फ़ाइलों पर कुछ महत्वपूर्ण फ़ंक्शन पर ध्यान केंद्रित करते हैं।
- शब्दों की संख्या
- वर्णों की संख्या
- औसत शब्द लंबाई
- स्टॉप शब्दों की संख्या
- विशेष वर्णों की संख्या
- संख्यात्मक की संख्या
- अपरकेस शब्दों की संख्या
हमारे पास एक टेस्ट फ़ाइल "css3.txt" है, हम उस फ़ाइल पर काम कर रहे हैं
शब्दों की संख्या
जब हम एक वाक्य में शब्दों की संख्या गिनते हैं, तो हम split फ़ंक्शन का उपयोग करते हैं। यह सबसे आसान तरीका है। इस मामले में हम split फ़ंक्शन भी लागू करते हैं।
उदाहरण कोड
filename = "C:/Users/TP/Desktop/css3.txt"
try:
    with open(filename) as file_object:
        contents = file_object.read()
except FileNotFoundError:
    message = "sorry" + filename
    print(message)
else:
    words = contents.split()
    number_words = len(words)
    print("Total words of " + filename, "is", str(number_words))
आउटपुट
Total words of C:/Users/TP/Desktop/css3.txt is 3574
वर्णों की संख्या
यहाँ हम एक शब्द में वर्णों की संख्या गिनते हैं, यहाँ हम शब्द की लंबाई का उपयोग करते हैं। यदि लंबाई 5 है तो उस शब्द में 5 वर्ण हैं।
उदाहरण कोड
filename = "C:/Users/TP/Desktop/css3.txt"
try:
    with open(filename) as file_object:
        contents = file_object.read()
except FileNotFoundError:
    message = "sorry" + filename
    print(message)
else:
    words = 0
    characters = 0
    wordslist = contents.split()
    words += len(wordslist)
    characters += sum(len(word) for word in wordslist)
    print("TOTAL CHARACTERS IN A TEXT FILE =", characters)
आउटपुट
TOTAL CHARACTERS IN A TEXT FILE = 17783
औसत शब्द लंबाई
यहाँ, हम सभी शब्दों की लंबाई का योग निकालते हैं और उसे कुल लंबाई से विभाजित करते हैं।
उदाहरण कोड
filename = "C:/Users/TP/Desktop/css3.txt"
try:
    with open(filename) as file_object:
        contents = file_object.read()
except FileNotFoundError:
    message = "sorry" + filename
    print(message)
else:
    words = 0
    wordslist = contents.split()
    words = len(wordslist)
    average = sum(len(word) for word in wordslist) / words
    print("Average =", average)
आउटपुट
Average = 4.97
स्टॉप शब्दों की संख्या
इसे हल करने के लिए हम पायथन में NLP लाइब्रेरी का उपयोग करते हैं।
उदाहरण कोड
from nltk.corpus import stopwords
from nltk.tokenize import word_tokenize
my_example_sent = "This is a sample sentence"
mystop_words = set(stopwords.words('english'))
my_word_tokens = word_tokenize(my_example_sent)
my_filtered_sentence = [w for w in my_word_tokens if not w in mystop_words]
my_filtered_sentence = []
for w in my_word_tokens:
    if w not in mystop_words:
        my_filtered_sentence.append(w)
print(my_word_tokens)
print(my_filtered_sentence)
विशेष वर्णों की संख्या
यहाँ हम इसमें मौजूद हैशटैग या मेंशन की संख्या की गणना कर सकते हैं। यह हमारे टेक्स्ट डेटा से अतिरिक्त जानकारी निकालने में मदद करता है।
उदाहरण कोड
import collections as ct
filename = "C:/Users/TP/Desktop/css3.txt"
try:
    with open(filename) as file_object:
        contents = file_object.read()
except FileNotFoundError:
    message = "sorry" + filename
    print(message)
else:
    words = contents.split()
    number_words = len(words)
    special_chars = "#"
    new = sum(v for k, v in ct.Counter(words).items() if k in special_chars)
    print("Total Special Characters", new)
आउटपुट
Total Special Characters 0
संख्यात्मक की संख्या
यहाँ हम टेक्स्ट फ़ाइलों में मौजूद संख्यात्मक डेटा की संख्या की गणना कर सकते हैं। यह एक शब्द में वर्णों की संख्या की गणना के समान है।
उदाहरण कोड
filename = "C:/Users/TP/Desktop/css3.txt"
try:
    with open(filename) as file_object:
        contents = file_object.read()
except FileNotFoundError:
    message = "sorry" + filename
    print(message)
else:
    words = sum(map(str.isdigit, contents.split()))
    print("TOTAL NUMERIC IN A TEXT FILE =", words)
आउटपुट
TOTAL NUMERIC IN A TEXT FILE = 2
अपरकेस शब्दों की संख्या
isupper() फ़ंक्शन का उपयोग करके, हम टेक्स्ट में अपरकेस अक्षरों की संख्या की गणना कर सकते हैं।
उदाहरण कोड
filename = "C:/Users/TP/Desktop/css3.txt"
try:
    with open(filename) as file_object:
        contents = file_object.read()
except FileNotFoundError:
    message = "sorry" + filename
    print(message)
else:
    words = sum(map(str.isupper, contents.split()))
    print("TOTAL UPPERCASE WORDS IN A TEXT FILE =", words)
आउटपुट
TOTAL UPPERCASE WORDS IN A TEXT FILE = 121