इमेज क्लासिफिकेशन इमेजेज को उनकी संबंधित कैटेगरी क्लासेस में क्लासिफाई करने की एक विधि है, जैसे:
- स्क्रैच से एक छोटा नेटवर्क ट्रेन करना
- VGG16 का उपयोग करके मॉडल की टॉप लेयर्स को फाइन-ट्यून करना
उदाहरण
# सबसे पहले, निम्नलिखित लाइब्रेरीज़ शामिल करें:
# सभी आवश्यक लाइब्रेरीज़ इम्पोर्ट करना
from keras.preprocessing.image import ImageDataGenerator
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D
from keras.layers import Activation, Dropout, Flatten, Dense
from keras import backend as K

# यहां, train_data_dir ट्रेन डेटासेट डायरेक्टरी है।
# validation_data_dir वैलिडेशन डेटा के लिए डायरेक्टरी है।
# nb_train_samples कुल ट्रेन सैंपल्स की संख्या है।
# nb_validation_samples कुल वैलिडेशन सैंपल्स की संख्या है।
img_width, img_height = 224, 224
train_data_dir = 'v_data/train'
validation_data_dir = 'v_data/test'
nb_train_samples = 400
nb_validation_samples = 100
epochs = 10
batch_size = 16

# इमेज के फॉर्मेट की जांच करना
if K.image_data_format() == 'channels_first':
    input_shape = (3, img_width, img_height)
else:
    input_shape = (img_width, img_height, 3)

model = Sequential()
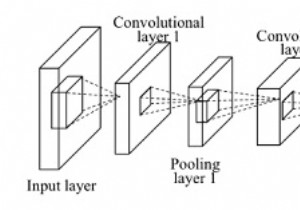
# Conv2D इमेज को कई इमेजेज में कन्वोल्व करने की लेयर है
model.add(Conv2D(32, (2, 2), input_shape=input_shape))
# Activation एक्टिवेशन फंक्शन है।
model.add(Activation('relu'))
# MaxPooling2D दिए गए साइज़ मैट्रिक्स से मैक्स वैल्यू पूल करने के लिए उपयोग किया जाता है
# और अगली 2 लेयर्स के लिए भी यही उपयोग किया जाता है।
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Conv2D(32, (2, 2)))
model.add(Activation('relu'))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Conv2D(64, (2, 2)))
model.add(Activation('relu'))
model.add(MaxPooling2D(pool_size=(2, 2)))

model.add(Flatten())
# Dense का उपयोग इसे फुली कनेक्टेड मॉडल बनाने के लिए किया जाता है और यह हिडन लेयर है।
model.add(Dense(64))
model.add(Activation('relu'))
# Dropout का उपयोग डेटासेट पर ओवरफिटिंग से बचने के लिए किया जाता है।
model.add(Dropout(0.5))
model.add(Dense(1))
model.add(Activation('sigmoid'))

# compile फंक्शन यहां उपयोग किया जाता है जिसमें लॉस, ऑप्टिमाइज़र्स और मेट्रिक्स शामिल हैं।
# यहां उपयोग किया गया लॉस फंक्शन binary_crossentropy है,
# ऑप्टिमाइज़र rmsprop उपयोग किया गया है।
model.compile(loss='binary_crossentropy', optimizer='rmsprop', metrics=['accuracy'])

# ImageDataGenerator जो इमेज को रीस्केल करता है, कुछ रेंज में शियर लागू करता है,
# इमेज को ज़ूम करता है और इमेज के साथ हॉरिजॉन्टल फ्लिपिंग करता है।
# यह ImageDataGenerator इमेज के सभी संभावित ओरिएंटेशन शामिल करता है।
train_datagen = ImageDataGenerator(rescale=1./255, shear_range=0.2, zoom_range=0.2, horizontal_flip=True)
test_datagen = ImageDataGenerator(rescale=1./255)

# train_datagen.flow_from_directory वह फंक्शन है जिसका उपयोग
# ट्रेन डेटासेट डायरेक्टरी से डेटा तैयार करने के लिए किया जाता है।
# Target_size इमेज के टारगेट साइज़ को स्पेसिफाई करता है।
train_generator = train_datagen.flow_from_directory(
    train_data_dir,
    target_size=(img_width, img_height),
    batch_size=batch_size,
    class_mode='binary'
)
validation_generator = test_datagen.flow_from_directory(
    validation_data_dir,
    target_size=(img_width, img_height),
    batch_size=batch_size,
    class_mode='binary'
)

# fit_generator का उपयोग ऊपर बने मॉडल में डेटा फिट करने के लिए किया जाता है,
# अन्य फैक्टर्स हैं steps_per_epoch जो बताता है कि मॉडल
# ट्रेनिंग डेटा के लिए कितनी बार एक्जीक्यूट होगा।
# epochs बताता है कि मॉडल को फॉरवर्ड और बैकवर्ड पास में कितनी बार ट्रेन किया जाएगा।
# validation_data का उपयोग वैलिडेशन/टेस्ट डेटा को मॉडल में फीड करने के लिए किया जाता है।
# validation_steps वैलिडेशन/टेस्ट सैंपल्स की संख्या को दर्शाता है।
model.fit_generator(
    train_generator,
    steps_per_epoch=nb_train_samples // batch_size,
    epochs=epochs,
    validation_data=validation_generator,
    validation_steps=nb_validation_samples // batch_size
)

# मॉडल सेव करना
model.save_weights('ImgmodelKeras_saved.h5')