पायथन में विभिन्न प्रकार के ऑपरेशन हैंडल करने के लिए पैकेज का बड़ा सेट है। PDF से डेटा और मेटा-इनफॉर्मेशन निकालने के लिए, हम PyPdf2 पैकेज का उपयोग करते हैं। यह उपयोग में आसान है और इसमें कई अलग-अलग ऑपरेशन या टूलकिट हैं जैसे PDF से डेटा निकालना, डॉक्यूमेंट में कीवर्ड खोजना, हाइपरलिंक, URL और अन्य जानकारी खोजने जैसी मेटा इनफॉर्मेशन निकालना। PyPDF2 पैकेज का उपयोग करके, हम PDF डॉक्यूमेंट से हाइपरलिंक निकालेंगे।
PDF से हाइपरलिंक निकालने के लिए हम इन चरणों का पालन करेंगे:
कमांड शेल में pip install PyPDF2 टाइप करके PyPDF2 को लोकल मशीन में इंस्टॉल करें।
PyPDF2 इम्पोर्ट करें।
फ़ाइल को बाइनरी मोड में खोलें और यह फ़ाइल में URL के पैटर्न को पहचानता है।
किसी विशेष पेज के लिए लिंक निकालने का फंक्शन परिभाषित करें।
सभी पेज पर पुनरावृति करें और extractText() फंक्शन का उपयोग करके टेक्स्ट निकालें।
PDF से हाइपरलिंक निकालने के लिए हम आमतौर पर पायथन में पैटर्न मैचिंग कॉन्सेप्ट का उपयोग करते हैं। अब पैटर्न खोजने के लिए रेगुलर एक्सप्रेशन का उपयोग करके import re करें।
findall(regex, string) का उपयोग करके https:// या https:// से मेल खाने वाले पैटर्न को खोजें।
अगर कोई URL मिलता है तो URL लौटाएं और स्क्रीन पर प्रिंट करें।
उदाहरण
# आवश्यक पैकेज इम्पोर्ट करें
import PyPDF2
import re

# कमांड में फ़ाइल खोलें
file = open("newfile.pdf", 'rb')
readPDF = PyPDF2.PdfFileReader(file)

def find_url(string):
    # पैटर्न से मेल खाने वाले सभी स्ट्रिंग खोजें
    regex = r"(https?://\S+)"
    url = re.findall(regex, string)
    for url in url:
        return url

# फ़ाइल के सभी पेज पर पुनरावृति
for page_no in range(readPDF.numPages):
    page = readPDF.getPage(page_no)
    # पेज से टेक्स्ट निकालें
    text = page.extractText()
    # सभी URL प्रिंट करें
    print(find_url(text))

# फ़ाइल बंद करें
file.close()
आउटपुट
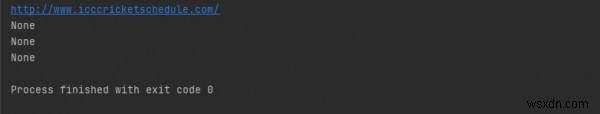
उपरोक्त कोड चलाने से दिए गए PDF डॉक्यूमेंट फ़ाइल में उपलब्ध सभी हाइपरलिंक प्रिंट होंगे।