यह सही कहा जाता है कि आज की दुनिया में डेटा पैसा है। ऐप-आधारित दुनिया में परिवर्तन के साथ डेटा की घातीय वृद्धि आती है। हालांकि, अधिकांश डेटा असंरचित है और इसलिए उपयोगी जानकारी निकालने और इसे समझने योग्य और उपयोग योग्य रूप में बदलने के लिए एक प्रक्रिया और विधि की आवश्यकता होती है।
डेटा माइनिंग या "डेटाबेस में ज्ञान खोज" कृत्रिम बुद्धिमत्ता, मशीन लर्निंग, सांख्यिकी और डेटाबेस सिस्टम के साथ बड़े डेटा सेट में पैटर्न खोजने की प्रक्रिया है।
मुफ्त डेटा माइनिंग टूल Knime और Orange जैसे पूर्ण मॉडल विकास वातावरण से लेकर Java, C++ में लिखे गए विभिन्न पुस्तकालयों तक और अक्सर पायथन में होते हैं। डेटा माइनिंग में आमतौर पर चार प्रकार के कार्य शामिल होते हैं:
- वर्गीकरण: नए डेटा पर लागू करने के लिए परिचित संरचना को सामान्य बनाने का कार्य
- क्लस्टरिंग: डेटा में समूहों और संरचनाओं को खोजने का कार्य जो किसी न किसी तरह से समान हैं, बिना डेटा में नोट की गई संरचनाओं का उपयोग किए।
- एसोसिएशन नियम सीखना: चर के बीच संबंधों की तलाश करता है
- रिग्रेशन: एक ऐसे फ़ंक्शन को खोजने का लक्ष्य रखता है जो मामूली त्रुटि के साथ डेटा को मॉडल करता है।
नीचे डेटा माइनिंग के लिए मुफ्त सॉफ्टवेयर टूल सूचीबद्ध हैं -
2022 में सर्वश्रेष्ठ मुफ्त डेटा माइनिंग टूल सूची:-
1. रैपिड माइनर (Rapid Miner) -
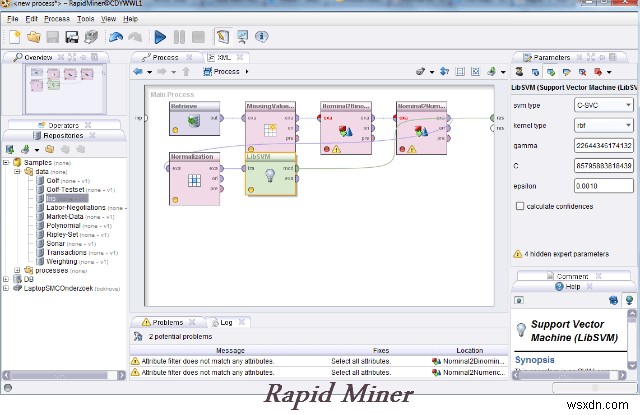
रैपिड माइनर, जिसे पहले YALE (येट अनदर लर्निंग एनवायरनमेंट) कहा जाता था, मशीन लर्निंग और डेटा माइनिंग प्रयोगों के लिए एक वातावरण है जिसका उपयोग अनुसंधान और वास्तविक दुनिया के डेटा-माइनिंग कार्यों दोनों के लिए किया जाता है। यह निर्विवाद रूप से डेटा माइनिंग के लिए विश्व-अग्रणी ओपन-सोर्स सिस्टम है। जावा प्रोग्रामिंग भाषा में लिखा गया, यह उपकरण टेम्पलेट-आधारित फ्रेमवर्क के माध्यम से उन्नत विश्लेषण प्रदान करता है।
यह प्रयोगों को मनमाने ढंग से नेस्टेबल ऑपरेटरों की एक बड़ी संख्या से बना हुआ सक्षम बनाता है, जो XML फाइलों में विस्तृत होते हैं और रैपिड माइनर के ग्राफिकल यूजर इंटरफेस के साथ बनाए जाते हैं। सबसे अच्छी बात यह है कि उपयोगकर्ताओं को कोड लिखने की आवश्यकता नहीं है। इसमें पहले से ही कई टेम्पलेट और अन्य उपकरण हैं जो हमें डेटा का आसानी से विश्लेषण करने देते हैं।
2. IBM SPSS मॉडलर -
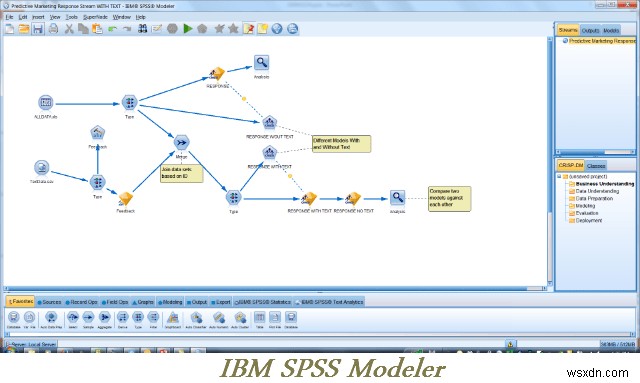
IBM SPSS मॉडलर टूलबेंच बड़े पैमाने की परियोजनाओं जैसे टेक्स्टुअल एनालिटिक्स पर काम करने के लिए सबसे अच्छा है, और इसका विजुअल इंटरफेस अत्यधिक मूल्यवान है। यह आपको बिना प्रोग्रामिंग के विभिन्न डेटा माइनिंग एल्गोरिदम उत्पन्न करने की अनुमति देता है। इसका उपयोग विसंगति पहचान, बेज़ियन नेटवर्क, CARMA, कॉक्स रिग्रेशन और बेसिक न्यूरल नेटवर्क के लिए भी किया जा सकता है जो बैक-प्रोपोगेशन लर्निंग के साथ मल्टीलेयर पर्सेप्ट्रॉन का उपयोग करते हैं। कमजोर दिल वालों के लिए नहीं।
3. ओरेकल डेटा माइनिंग -
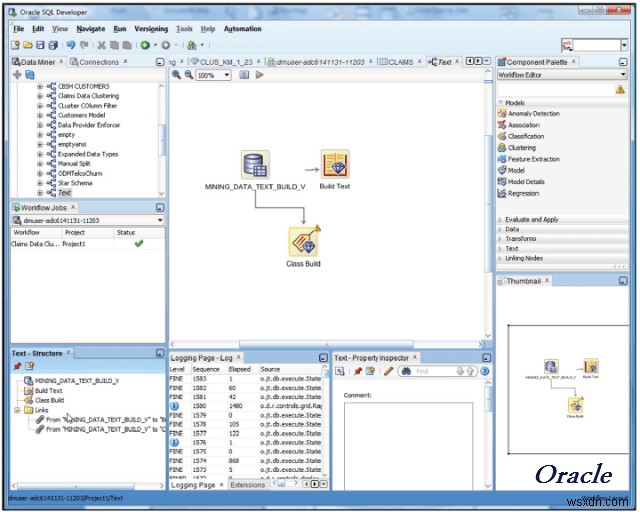
डेटा माइनिंग क्षेत्र में एक और बड़ा नाम ओरेकल है। उनके एडवांस्ड एनालिटिक्स डेटाबेस विकल्प के हिस्से के रूप में, ओरेकल डेटा माइनिंग अपने उपयोगकर्ताओं को अंतर्दृष्टि खोजने, भविष्यवाणियां करने और अपने ओरेकल डेटा का लाभ उठाने की अनुमति देता है। आप ग्राहक व्यवहार की खोज करने, सर्वश्रेष्ठ ग्राहकों को लक्षित करने और प्रोफाइल विकसित करने के लिए मॉडल बना सकते हैं।
ओरेकल डेटा माइनर GUI डेटा विश्लेषकों, बिजनेस विश्लेषकों और डेटा वैज्ञानिकों को एक बल्कि सुंदर ड्रैग-एंड-ड्रॉप समाधान का उपयोग करके डेटाबेस के अंदर डेटा के साथ काम करने में सक्षम बनाता है। यह स्वचालन, शेड्यूलिंग और पूरे उद्यम में तैनाती के लिए SQL और PL/SQL स्क्रिप्ट भी बना सकता है।
4. टेराडेटा (Teradata) -
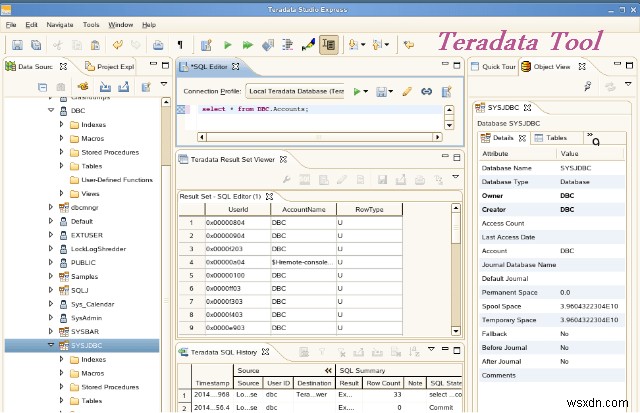
टेराडेटा इस तथ्य को पहचानता है कि, हालांकि बिग डेटा बहुत बढ़िया है, अगर आप वास्तव में नहीं जानते कि इसका विश्लेषण और उपयोग कैसे करना है, तो यह बेकार है। लाखों डेटा पॉइंट होने की कल्पना करें बिना उन्हें क्वेरी करने के कौशल के। यहीं टेराडेटा आता है। वे डेटा वेयरहाउसिंग, बिग डेटा और एनालिटिक्स और मार्केटिंग एप्लिकेशन में एंड-टू-एंड समाधान और सेवाएं प्रदान करते हैं।
टेराडेटा कार्यान्वयन, व्यावसायिक परामर्श, प्रशिक्षण और सहायता सहित सेवाओं की एक पूरी मेजबानी भी प्रदान करता है।
5. फ्रेम्ड डेटा (Framed Data) -
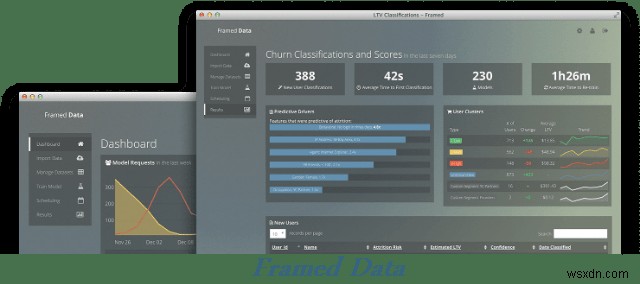
यह एक पूरी तरह से प्रबंधित समाधान है जिसका अर्थ है कि आपको कुछ भी करने की आवश्यकता नहीं है बस बैठें और अंतर्दृष्टि की प्रतीक्षा करें। फ्रेम्ड डेटा व्यवसायों से डेटा लेता है और इसे कार्रवाई योग्य अंतर्दृष्टि और निर्णयों में बदल देता है। वे अपने क्लाउड में प्रशिक्षित, अनुकूलित और उत्पादन मॉडल स्टोर करते हैं और API के माध्यम से भविष्यवाणियां प्रदान करते हैं, बुनियादी ढांचे के ओवरहेड को समाप्त करते हैं। वे डैशबोर्ड और परिदृश्य विश्लेषण टूल प्रदान करते हैं जो आपको बताते हैं कि कौन से कंपनी लीवर उन मेट्रिक्स को चला रहे हैं जिनकी आप परवाह करते हैं।
6. कैगल (Kaggle) -
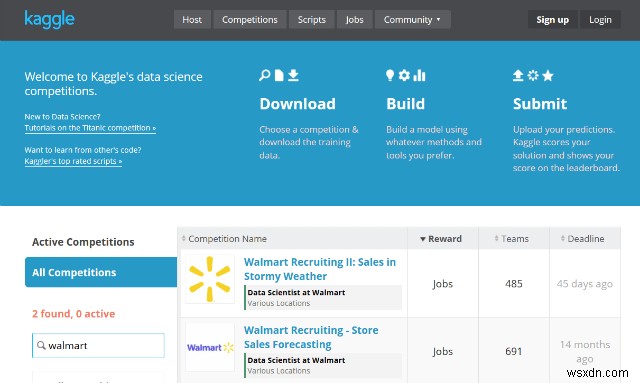
कैगल दुनिया का सबसे बड़ा डेटा साइंस समुदाय है। कंपनियां और शोधकर्ता अपना डेटा पोस्ट करते हैं और दुनिया भर के सांख्यिकीविद् और डेटा माइनर सर्वोत्तम मॉडल बनाने के लिए प्रतिस्पर्धा करते हैं।
कैगल डेटा साइंस प्रतियोगिताओं के लिए एक मंच है। यह आपको कठिन समस्याओं को हल करने, मजबूत टीमों की भर्ती करने, और आपकी डेटा साइंस प्रतिभा की शक्ति को बढ़ाने में मदद करता है।
काम करने के 3 चरण -
- एक भविष्यवाणी समस्या अपलोड करें
- सबमिट करें
- मूल्यांकन और आदान-प्रदान
7. WEKA -
WEKA एक बहुत परिष्कृत सर्वश्रेष्ठ डेटा माइनिंग टूल है। यह आपको डेटा सेट, क्लस्टर, भविष्यवाणी मॉडलिंग, विज़ुअलाइज़ेशन आदि के बीच विभिन्न संबंध दिखाता है। ऐसे कई क्लासिफायरियर हैं जिन्हें आप डेटा में अधिक अंतर्दृष्टि प्राप्त करने के लिए लागू कर सकते हैं।
8. रैटल (Rattle) -

रैटल का मतलब R एनालिटिकल टूल टू लर्न ईजिली है। यह डेटा के सांख्यिकीय और दृश्य सारांश प्रस्तुत करता है, डेटा को ऐसे रूपों में बदलता है जिन्हें आसानी से मॉडल किया जा सकता है, डेटा से अनसुपरवाइज्ड और सुपरवाइज्ड दोनों मॉडल बनाता है, मॉडल के प्रदर्शन को ग्राफिकल रूप से प्रस्तुत करता है, और नए डेटासेट को स्कोर करता है।
यह Gnome ग्राफिकल इंटरफेस का उपयोग करके सांख्यिकीय भाषा R में लिखा गया एक मुफ्त और ओपन सोर्स सर्वश्रेष्ठ डेटा माइनिंग टूलकिट है। यह GNU/Linux, मैकिन्टोश OS X, और MS/विंडोज के तहत चलता है।
9. KNIME -
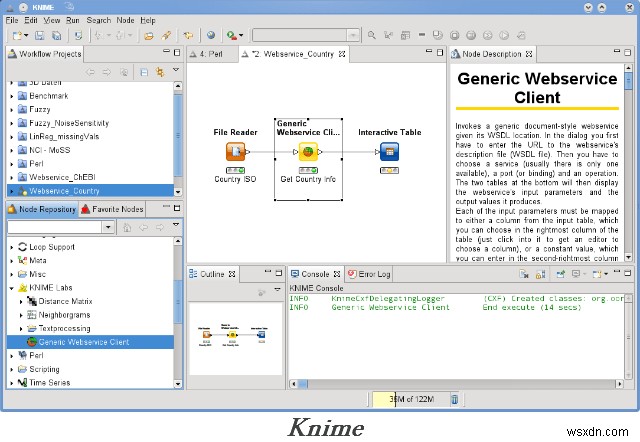
कॉन्स्टेंज इंफॉर्मेशन माइनर एक उपयोगकर्ता के अनुकूल, समझने योग्य और व्यापक ओपन-सोर्स डेटा एकीकरण, प्रसंस्करण, विश्लेषण और अन्वेषण मंच है। इसमें एक ग्राफिकल यूजर इंटरफेस है जो उपयोगकर्ताओं को डेटा प्रोसेसिंग के लिए नोड्स को आसानी से कनेक्ट करने में मदद करता है।
KNIME अपने मॉड्यूलर डेटा पाइपलाइनिंग अवधारणा के माध्यम से मशीन लर्निंग और डेटा माइनिंग के लिए विभिन्न घटकों को एकीकृत करता है और इसने बिजनेस इंटेलिजेंस और वित्तीय डेटा विश्लेषण की नजर पकड़ी है।
10. पायथन (Python) -
एक मुफ्त और ओपन सोर्स भाषा के रूप में, पायथन की तुलना अक्सर उपयोग में आसानी के लिए R से की जाती है। R के विपरीत, पायथन का लर्निंग कर्व इतना छोटा होता है कि यह पौराणिक हो गया है। कई उपयोगकर्ता पाते हैं कि वे मिनटों में डेटा सेट बनाना शुरू कर सकते हैं और अत्यधिक जटिल एफिनिटी विश्लेषण कर सकते हैं। सबसे आम व्यावसायिक उपयोग केस-डेटा विज़ुअलाइज़ेशन सीधे हैं जब तक आप वेरिएबल्स, डेटा प्रकार, फ़ंक्शन, कंडीशनल और लूप जैसी बुनियादी प्रोग्रामिंग अवधारणाओं के साथ सहज हैं।
11. ऑरेंज (Orange) -
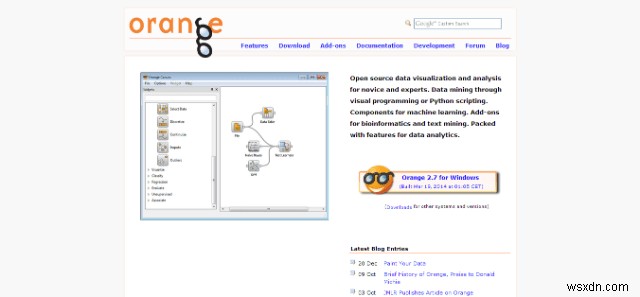
ऑरेंज पायथन भाषा में लिखा गया एक घटक-आधारित डेटा माइनिंग और मशीन लर्निंग सॉफ्टवेयर सूट है। यह नौसिखियों और विशेषज्ञों के लिए एक ओपन सोर्स डेटा विज़ुअलाइज़ेशन और विश्लेषण है। डेटा माइनिंग विज़ुअल प्रोग्रामिंग या पायथन स्क्रिप्टिंग के माध्यम से की जा सकती है। यह डेटा एनालिटिक्स, विभिन्न विज़ुअलाइज़ेशन के लिए सुविधाओं से भरा हुआ है, स्कैटरप्लॉट, बार चार्ट, ट्री, डेंड्रोग्राम, नेटवर्क और हीट मैप्स से।
12. SAS डेटा माइनिंग -
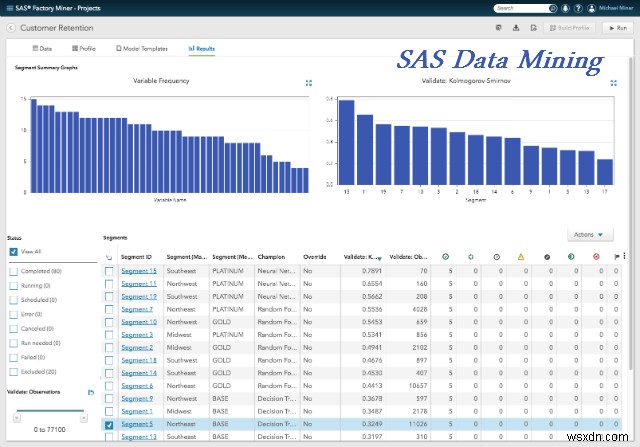
SAS डेटा माइनिंग वाणिज्यिक सॉफ्टवेयर का उपयोग करके डेटा सेट पैटर्न खोजें। इसका वर्णनात्मक और भविष्यवाणी मॉडलिंग डेटा की बेहतर समझ के लिए अंतर्दृष्टि प्रदान करता है। वे एक आसान उपयोग GUI प्रदान करते हैं। उनके पास डेटा प्रोसेसिंग, क्लस्टरिंग से लेकर अंत तक स्वचालित उपकरण हैं जहां आप सही निर्णय लेने के लिए सर्वोत्तम परिणाम पा सकते हैं। एक वाणिज्यिक सॉफ्टवेयर होने के नाते इसमें स्केलेबल प्रोसेसिंग, ऑटोमेशन, गहन एल्गोरिदम, मॉडलिंग, डेटा विज़ुअलाइज़ेशन और अन्वेषण आदि जैसे उन्नत उपकरण भी शामिल हैं।
13. अपाचे महौट (Apache Mahout) -
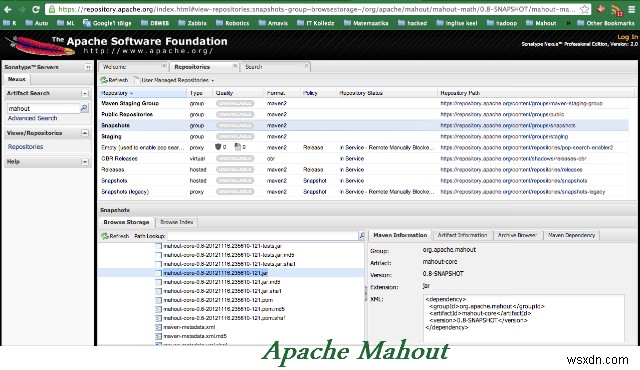
अपाचे महौट अपाचे सॉफ्टवेयर फाउंडेशन की एक परियोजना है जो सहयोगी फ़िल्टरिंग, क्लस्टरिंग और वर्गीकरण के क्षेत्रों में मुख्य रूप से केंद्रित वितरित या अन्यथा स्केलेबल मशीन लर्निंग एल्गोरिदम के मुफ्त कार्यान्वयन का उत्पादन करने के लिए है।
अपाचे महौट मुख्य रूप से तीन उपयोग के मामलों का समर्थन करता है: अनुशंसा खनन उपयोगकर्ताओं के व्यवहार को लेता है और उससे उन वस्तुओं को खोजने की कोशिश करता है जो उपयोगकर्ताओं को पसंद आ सकती हैं। क्लस्टरिंग उदाहरण के लिए टेक्स्ट दस्तावेज़ लेता है और उन्हें शीर्षकीय रूप से संबंधित दस्तावेज़ों के समूहों में समूहित करता है। वर्गीकरण मौजूदा वर्गीकृत दस्तावेज़ों से सीखता है कि एक विशिष्ट श्रेणी के दस्तावेज़ कैसे दिखते हैं और अनलेबल दस्तावेज़ों को (उम्मीद है) सही श्रेणी में असाइन करने में सक्षम है।
14. PSPP -
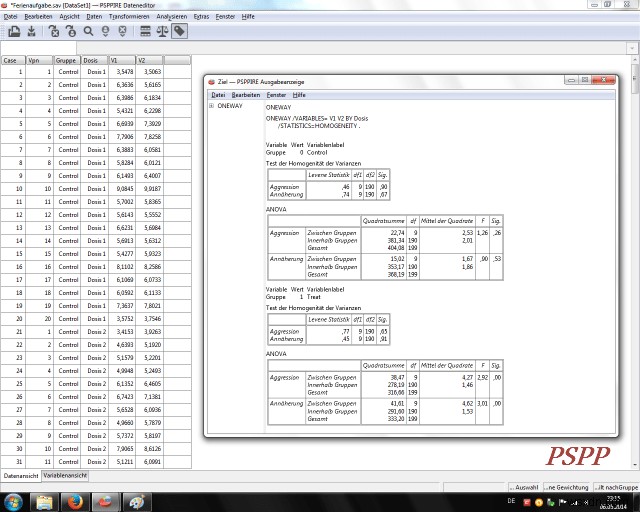
PSPP नमूना डेटा के सांख्यिकीय विश्लेषण के लिए एक कार्यक्रम है। इसमें एक ग्राफिकल यूजर इंटरफेस और पारंपरिक कमांड-लाइन इंटरफेस है। यह C में लिखा गया है, अपने गणितीय रूटीन के लिए GNU साइंटिफिक लाइब्रेरी का उपयोग करता है, और ग्राफ़ उत्पन्न करने के लिए प्लॉट यूटिल्स का उपयोग करता है। यह मालिकाना प्रोग्राम SPSS (IBM से) के लिए एक मुफ्त प्रतिस्थापन है, आत्मविश्वास के साथ भविष्यवाणी करें कि आगे क्या होगा ताकि आप बेहतर निर्णय ले सकें, समस्याओं को हल कर सकें और परिणामों में सुधार कर सकें।
15. jHepWork -
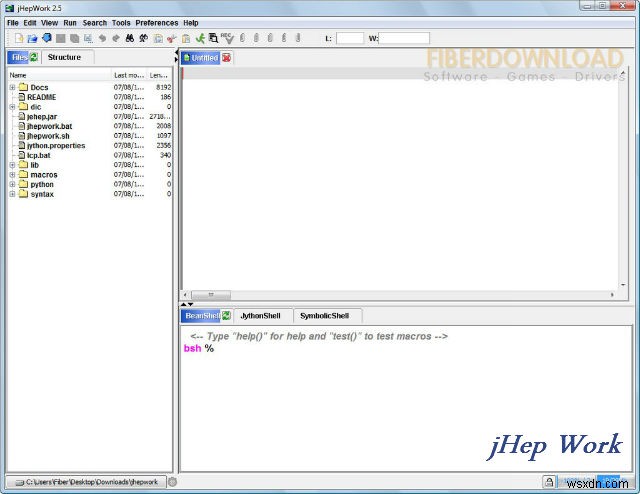
jHepWork एक मुफ्त और ओपन-सोर्स डेटा-विश्लेषण फ्रेमवर्क है जिसे ओपन-सोर्स पैकेज का उपयोग करके एक डेटा-विश्लेषण वातावरण बनाने के प्रयास के रूप में बनाया गया है जिसमें एक समझने योग्य यूजर इंटरफेस है और वाणिज्यिक कार्यक्रमों के लिए प्रतिस्पर्धी एक उपकरण बनाने के लिए।
jHepWork डेटा सेट के लिए इंटरैक्टिव 2D और 3D प्लॉट दिखाता है ताकि बेहतर विश्लेषण हो सके। जावा में लागू संख्यात्मक वैज्ञानिक पुस्तकालय और गणितीय फ़ंक्शन हैं। jHepWork एक उच्च-स्तरीय प्रोग्रामिंग भाषा Jython पर आधारित है, लेकिन jHepWork संख्यात्मक और ग्राफिकल पुस्तकालयों को कॉल करने के लिए जावा कोडिंग का भी उपयोग किया जा सकता है।
16. R प्रोग्रामिंग भाषा -
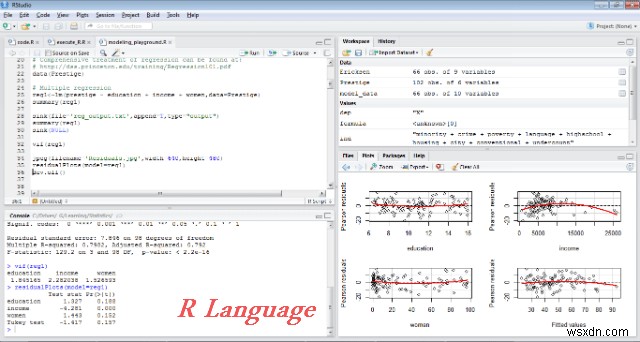
इस सूची में मुफ्त डेटा माइनिंग टूल के सुपरस्टार R के होने का कोई रहस्य नहीं है। यह मुफ्त, ओपन सोर्स है और कम या बिना प्रोग्रामिंग अनुभव वाले लोगों के लिए आसान है। सचमुच हजारों लाइब्रेरी हैं जिन्हें R वातावरण में शामिल किया जा सकता है जो इसे एक शक्तिशाली डेटा माइनिंग वातावरण बनाती है। यह सांख्यिकीय कंप्यूटिंग और ग्राफिक्स के लिए एक मुफ्त सॉफ्टवेयर प्रोग्रामिंग भाषा और सॉफ्टवेयर वातावरण है।
R भाषा डेटा माइनर्स द्वारा सांख्यिकीय सॉफ्टवेयर विकसित करने और डेटा विश्लेषण के लिए व्यापक रूप से उपयोग की जाती है। उपयोग में आसानी और विस्तारशीलता ने हाल के वर्षों में R की लोकप्रियता को काफी बढ़ाया है।
17. पेंटाहो (Pentaho) -
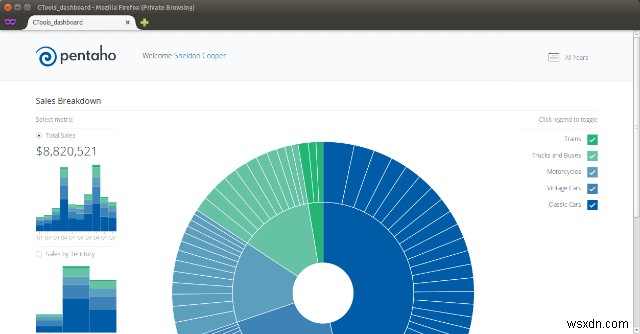
पेंटाहो डेटा एकीकरण, बिजनेस एनालिटिक्स और बिग डेटा के लिए एक व्यापक मंच प्रदान करता है। इस वाणिज्यिक उपकरण के साथ आप किसी भी स्रोत से डेटा को आसानी से मिश्रित कर सकते हैं। अपने व्यावसायिक डेटा में अंतर्दृष्टि प्राप्त करें और भविष्य के लिए अधिक सटीक सूचना-संचालित निर्णय लें।
18. टैनाग्रा (Tanagra) -
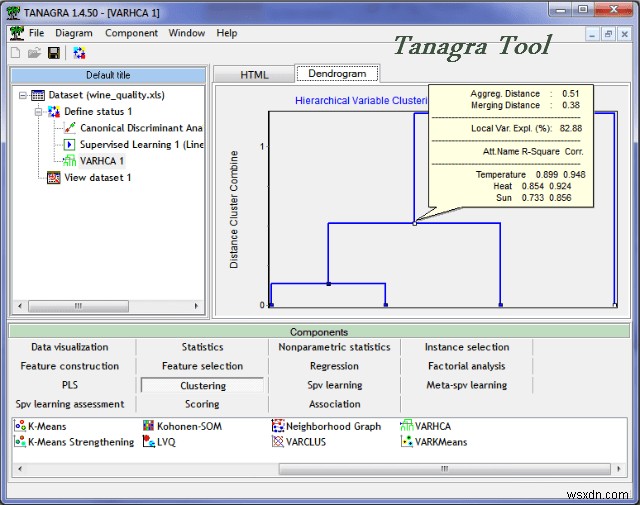
TANAGRA शैक्षणिक और अनुसंधान उद्देश्यों के लिए एक डेटा माइनिंग सॉफ्टवेयर है। खोजपूर्ण डेटा विश्लेषण, सांख्यिकीय शिक्षा, मशीन लर्निंग और डेटाबेस क्षेत्र के लिए उपकरण हैं। टैनाग्रा में कुछ सुपरवाइज्ड लर्निंग हैं लेकिन अन्य प्रतिमान भी जैसे क्लस्टरिंग, फैक्टोरियल विश्लेषण, पैरामीट्रिक और नॉन-पैरामीट्रिक सांख्यिकी, एसोसिएशन नियम, फीचर चयन और निर्माण एल्गोरिदम।
19. NLTK -
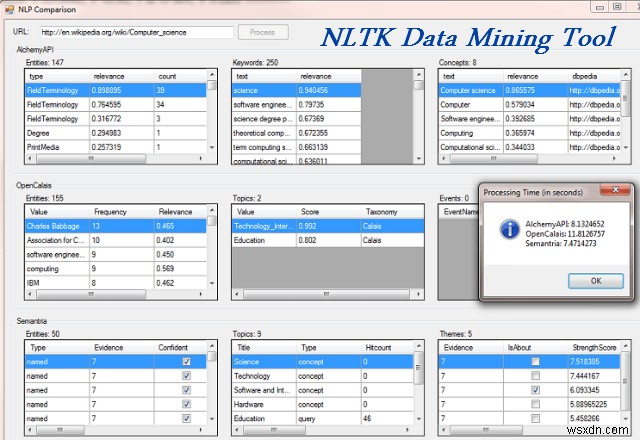
नेचुरल लैंग्वेज टूलकिट, पायथन भाषा के लिए प्रतीकात्मक और सांख्यिकीय प्राकृतिक भाषा प्रसंस्करण (NLP) के लिए पुस्तकालयों और कार्यक्रमों का एक सूट है। यह डेटा माइनिंग, मशीन लर्निंग, डेटा स्क्रैपिंग, भावना विश्लेषण और अन्य विभिन्न भाषा प्रसंस्करण कार्यों सहित भाषा प्रसंस्करण उपकरणों का एक पूल प्रदान करता है। मानव भाषा डेटा से निपटने के लिए पायथन प्रोग्राम बनाएं।
हमें उम्मीद है कि सर्वश्रेष्ठ मुफ्त डेटा माइनिंग टूल की हमारी सूची आपके लिए उपयोगी थी। हम आपकी राय जानना पसंद करेंगे, कृपया नीचे टिप्पणी अनुभाग में अपने विचार साझा करें।