बिग डेटा पर ब्लॉग में हमने बिग डेटा के फंक्शनल लेयर्स पर चर्चा की और मेरे पिछले ब्लॉग में मैंने टॉप 11 क्लाउड डेटा स्टोरेज टूल्स सूचीबद्ध किए। स्टोरेज के बाद अगला कदम डेटा क्लींजिंग प्रक्रिया है।
जब हम बिग डेटा के बारे में बात करते हैं, तो यह स्व-व्याख्यात्मक है कि डेटा खतरनाक दर से बढ़ रहा है, चाहे वह व्यावसायिक डेटा हो या व्यक्तिगत डेटा। अगर हम तथ्यों से जाएं तो दुनिया में हर दिन 2.5 क्विंटिलियन बाइट्स डेटा बनाया जाता है। इस डेटा में दोहराव और त्रुटिपूर्ण रिकॉर्ड भी होते हैं जिन्हें अंतर्दृष्टि के लिए खनन करने से पहले हटाने की आवश्यकता होती है। गलत डेटा गलत धारणाओं और विश्लेषण की ओर ले जाता है, अंततः परियोजना की विफलता का कारण बनता है।
डेटा क्लींजिंग किसी विशेष डेटाबेस से गलत रिकॉर्ड को सुधारने और हटाने (यदि आवश्यक हो) की प्रक्रिया का नाम है। डेटा क्लींजिंग का उद्देश्य तथाकथित डर्टी डेटा का पता लगाना है ताकि इसे संशोधित या हटाया जा सके ताकि यह सुनिश्चित हो सके कि डेटा का एक दिया गया सेट सिस्टम में अन्य सेट के साथ सटीक और सुसंगत है।
विभिन्न प्रकार के डेटा क्लीनिंग टूल्स हैं। एक अच्छा डेटा क्लीनिंग टूल आपके डेटाबेस को डुप्लिकेट डेटा, खराब प्रविष्टियों और गलत जानकारी से साफ करने में मदद करता है। इन टूल्स को उस वातावरण के आधार पर नीचे दी गई श्रेणियों में विभाजित किया जा सकता है जिसमें इनका उपयोग किया जाता है:
- ऑफलाइन डेटा क्लीनिंग टूल्स
- क्लाउड आधारित डेटा क्लीनिंग टूल्स
- सेल्सफोर्स डेटा के लिए डेटा क्लीनिंग टूल्स।
यह ब्लॉग आपको कुछ अच्छे ऑफलाइन डेटा क्लीनिंग टूल्स से परिचित कराएगा।
1. Drake
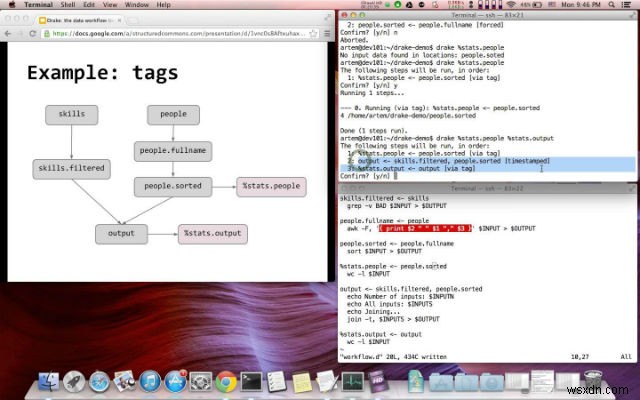
Drake एक सरल-से-उपयोग, विस्तार योग्य, टेक्स्ट-आधारित डेटा वर्कफ़्लो टूल है जो डेटा और इसकी निर्भरताओं के आसपास कमांड निष्पादन को व्यवस्थित करता है। डेटा प्रोसेसिंग चरणों को उनके इनपुट और आउटपुट के साथ परिभाषित किया जाता है। यह स्वचालित रूप से निर्भरताओं को हल करता है और वर्कफ़्लो को नियंत्रित करने के लिए विकल्पों का एक समृद्ध सेट प्रदान करता है। यह कई इनपुट और आउटपुट का समर्थन करता है और इसमें बिल्ट-इन HDFS समर्थन है।
2. OpenRefine
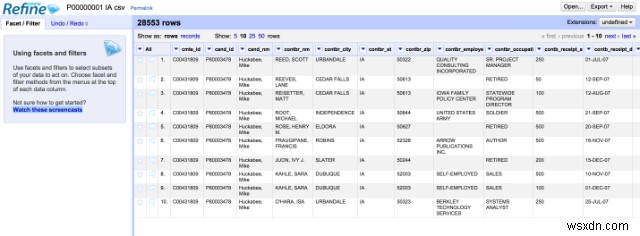
OpenRefine, जिसे पहले Google Refine कहा जाता था, गन्दे डेटा के साथ काम करने के लिए एक स्टैंडअलोन ओपन सोर्स शक्तिशाली डेस्कटॉप एप्लिकेशन है। यह डेटा रैंगलिंग सुविधा प्रदान करता है यानी डेटा सफाई और एक प्रारूप से दूसरे में डेटा परिवर्तन। यह स्प्रेडशीट एप्लिकेशन के समान है, लेकिन डेटाबेस की तरह अधिक व्यवहार करता है।
यह रिलेशनल डेटाबेस टेबल के समान डेटा पर काम करता है, यानी यह डेटा की पंक्तियों पर काम करता है जिनमें कॉलम के तहत सेल होते हैं। एक OpenRefine प्रोजेक्ट एक टेबल है। उपयोगकर्ता विभिन्न फ़िल्टरिंग मानदंडों का उपयोग करके पंक्तियों के प्रदर्शन को बदल सकते हैं। एक डेटासेट पर किए गए सभी कार्य एक प्रोजेक्ट में संग्रहीत होते हैं और दूसरे डेटासेट पर दोहराए जा सकते हैं।
3. Trifacta Wrangler
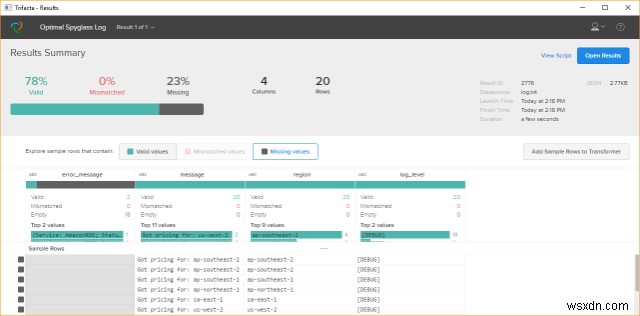
यह टूल हमें डेटा रैंगलिंग प्रक्रिया में मदद करता है। डेटा रैंगलिंग को मोटे तौर पर अर्ध-स्वचालित टूल की मदद से डेटा को एक कच्चे रूप से दूसरे प्रारूप में मैन्युअल रूप से परिवर्तित या मैप करने की प्रक्रिया के रूप में परिभाषित किया जाता है जो डेटा की अधिक सुविधाजनक खपत की अनुमति देता है।
Wrangler नाटकीय रूप से सुधारता है कि संगठन विविध डेटा से मूल्य कैसे प्राप्त करते हैं। Trifacta Wrangler के साथ एक नया दृष्टिकोण लागू किया गया है कि विश्लेषक डेटा विज़ुअलाइज़ेशन, मशीन लर्निंग, मानव-कंप्यूटर इंटरैक्शन और डेटा प्रोसेसिंग में नवीनतम तकनीकों का लाभ उठाकर डेटा को कैसे उपयोगी बनाते हैं। उनका एक सरल उद्देश्य है: फॉर्मेटिंग में कम समय खर्च करना और डेटा का विश्लेषण करने में अधिक समय बिताना। यह गन्दे, वास्तविक दुनिया के डेटा के इंटरैक्टिव परिवर्तन को विश्लेषण टूल्स के लिए डेटा टेबल में अनुमति देता है।
4. DataCleaner
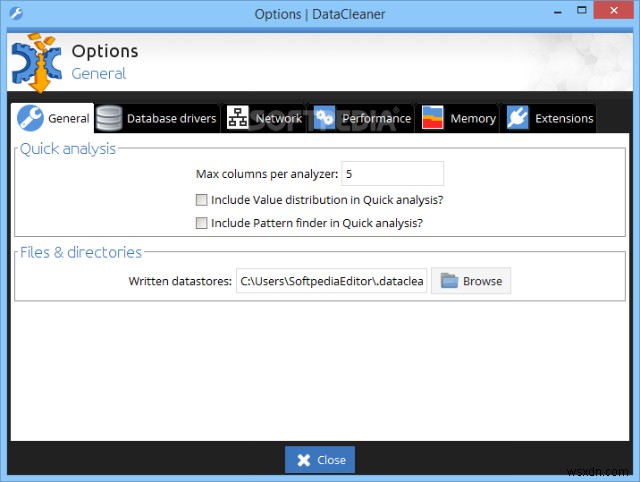
DataCleaner एक डेटा गुणवत्ता विश्लेषण एप्लिकेशन और डेटा गुणवत्ता समाधान के लिए एक समाधान प्लेटफॉर्म है। इसका कोर एक मजबूत प्रोफाइलिंग इंजन है, जो विस्तार योग्य है और जिससे डेटा क्लींजिंग, परिवर्तन, संवर्धन, डुप्लीकेशन, मिलान और विलय जुड़ते हैं। इसकी कुछ विशेषताएं नीचे दी गई हैं:
- अपने डेटा मूल्यों के पैटर्न, लापता मान, कैरेक्टर सेट और अन्य विशेषताओं का पता लगाएं।
- नाम और पते के सत्यापन के साथ अपने संपर्क विवरण को साफ करें।
- फजी लॉजिक और कॉन्फिगरेबल वेट और थ्रेशोल्ड का उपयोग करके डुप्लिकेट का पता लगाएं। और अंत में इसका एकल संस्करण बनाएं।
- अपने स्वयं के सफाई नियम बनाएं और उन्हें कई उपयोग परिदृश्यों और लक्ष्य डेटाबेस में लिखें।
5. Winpure Clean and Match
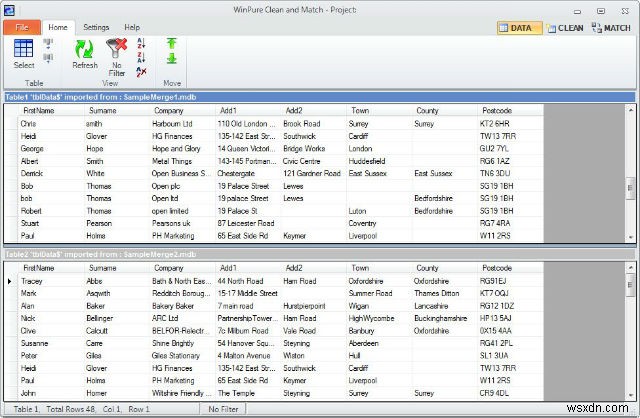
डेटा गुणवत्ता नियंत्रण किसी परियोजना या अभियान की समग्र सफलता के पीछे सबसे महत्वपूर्ण कारक है। यह एक डेटा क्लींजिंग और मिलान सूट है, जिसे विशेष रूप से व्यावसायिक या उपभोक्ता डेटा की सटीकता बढ़ाने के लिए डिज़ाइन किया गया है। यह एक पुरस्कार-विजेता सॉफ्टवेयर सूट है, जो मेलिंग सूचियों, डेटाबेस, स्प्रेडशीट और CRMs को साफ करने, सही करने और डुप्लीकेट हटाने के लिए आदर्श है। इसका उपयोग Access, Dbase, SQL Server जैसे डेटाबेस के लिए किया जा सकता है, और Excel टेबल और Txt फाइलें भी।
6. TIBCO Clarity
TIBCO Clarity एक डेटा तैयारी टूल है जो आपको वेब से सॉफ्टवेयर-एज-ए-सर्विस के रूप में ऑन-डिमांड सॉफ्टवेयर सेवाएं प्रदान करता है। इसका उपयोग विभिन्न स्रोतों से एकत्रित कच्चे डेटा की खोज, प्रोफाइल, सफाई, और मानकीकरण करने के लिए किया जा सकता है और सटीक विश्लेषण और बुद्धिमान निर्णय लेने के लिए अच्छी गुणवत्ता वाला डेटा प्रदान करता है। कच्चे डेटा को प्रबंधित करने के लिए TIBCO Clarity की विशेषताएं:
- निर्बाध एकीकरण
- डेटा खोज और प्रोफाइलिंग
- डुप्लीकेशन
- पता मानकीकरण
- डेटा परिवर्तन
7. Data Ladder
Data Ladder कंपनी एक डेटा गुणवत्ता सॉफ्टवेयर कंपनी है, जिसका उद्देश्य डेटा मिलान, प्रोफाइलिंग, डुप्लीकेशन, और संवर्धन टूल्स के माध्यम से व्यावसायिक उपयोगकर्ताओं को उनके डेटा का अधिकतम लाभ उठाने में मदद करना है। Data Match Enterprise सूट एक अत्यधिक दृश्य डेस्कटॉप डेटा क्लींजिंग एप्लिकेशन है जिसे विशेष रूप से ग्राहक और संपर्क डेटा गुणवत्ता मुद्दों को हल करने के लिए डिज़ाइन किया गया है। Data Match Enterprise में फोनेटिक, फजी, मिसकीड, और संक्षिप्त विविधताओं का पता लगाने के लिए कई मालिकाना और मानक एल्गोरिदम शामिल हैं
डेटा डुप्लीकेशन सॉफ्टवेयर एक आसान उपयोग सॉफ्टवेयर सूट में डेटा गुणवत्ता, सफाई, मिलान और डुप्लीकेशन के लिए एक पूर्ण समाधान प्रदान करता है।
8. Star DQ Pro
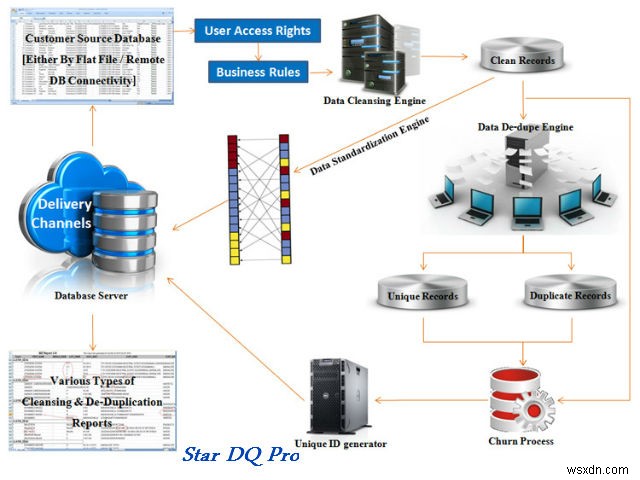
सुनिश्चित करें कि आपका डेटा सटीक, वास्तविक और अद्यतित है। यह सटीकता, पूर्णता, स्थिरता, समयसीमा, विशिष्टता और वैधता जैसे डेटा गुणवत्ता की प्रमुख आवश्यकताओं को संबोधित करता है। इसके द्वारा प्रदान की जाने वाली विशेषताएं हैं
- क्लींजिंग – दोष के प्रकार की योग्यता, टिप्पणियों के साथ अस्वच्छ डेटा के लॉग उत्पन्न करता है।
- डुप्लीकेशन – समूह और क्लस्टरिंग, गलत प्रतिनिधित्व की पहचान, चल रही वृद्धिशील डुप्लीकेशन।
- निगरानी – लेनदेन लॉग, मेल/SMS द्वारा प्रक्रिया स्थिति अलर्ट, उपयोगकर्ता प्रमाणीकरण।
डेटा क्लींजिंग तब विशेष रूप से महत्वपूर्ण है जब बड़ी मात्रा में डेटा संग्रहीत किया जाता है। गंदे डेटा पर सुधारात्मक कार्रवाई का लक्ष्य तब किसी भी त्रुटि को जितना संभव हो उतना महत्वहीन बनाना है। जब तक नियमित रूप से डेटा क्लींजिंग नहीं की जाती, गलतियां जमा हो सकती हैं और कार्य की दक्षता को कम कर सकती हैं। बिग डेटा पर अगले ब्लॉग में, मैं क्लाउड आधारित डेटा क्लींजिंग टूल और सेल्सफोर्स डेटाबेस के लिए टूल्स सूचीबद्ध करूंगा।