क्या आपने कभी अपना खुद का मैसेज कतार बनाने की कोशिश की लेकिन चुनौतियों का सामना किया? यदि हां, तो आप अकेले नहीं हैं। इस ट्यूटोरियल में, हम Redis लिस्ट का उपयोग करके स्क्रैच से एक मैसेज कतार बनाने जा रहे हैं। जबकि Redis के साथ मैसेज कतार बनाने के कई तरीके हैं, जैसे स्ट्रीम, लिस्ट, और पब/सब, हम सबसे सरल और सबसे सीधे दृष्टिकोण पर ध्यान केंद्रित करेंगे: लिस्ट। मेरे साथ जुड़ें क्योंकि हम इस व्यावहारिक गाइड में तल्लीन करते हैं।
हम क्या उपयोग करेंगे
- Upstash
- हाथों की जोड़ी
आपको क्या चाहिए
- Bun
- हाथों की जोड़ी
Upstash Redis सेटअप करना
सबसे पहले, आइए एक Redis इंस्टेंस सेटअप करें। ऐसा करने के लिए, बस Upstash पर जाएं और Create Database पर क्लिक करें। उसके बाद, अपने कनेक्शन स्ट्रिंग को खोजने के लिए नीचे स्क्रॉल करें, जिसका उपयोग हम अपने क्लाइंट को कनेक्ट करने के लिए करेंगे। मैं यहां विवरण में नहीं जाऊंगा, लेकिन अनिवार्य रूप से यही वह है जो आपको शुरू करने के लिए चाहिए।
उदाहरण कनेक्शन स्ट्रिंग:
redis://XXXXe@social-XXX-39281.upstash.io:39281प्रोजेक्ट किकऑफ
आइए Bun का उपयोग करके अपना TypeScript प्रोजेक्ट शुरू करें। चुनाव सिर्फ इसलिए नहीं है क्योंकि यह Node से तेज है—इसे सेटअप करना भी बहुत आसान है। और हां, यह प्रभावशाली रूप से तेज भी है! 🚀
mkdir upstash-mq
cd upstash-mq
bun init
> package name (upstash-mq-tutorial): upstash-mq
> entry point (index.ts):
> Done!
bun add ioredis
प्रोजेक्ट संरचना
 ┣ 📂src
 ┃ ┣ 📂lua-scripts
 ┃ ┃ ┣ 📜add-job.lua
 ┃ ┃ ┗ 📜remove-job.lua
 ┃ ┣ 📜index.ts
 ┃ ┣ 📜job.ts
 ┃ ┣ 📜queue.ts
 ┃ ┗ 📜utils.ts
 ┣ 📜.env
 ┣ 📜.gitignore
 ┣ 📜README.md
 ┣ 📜bun.lockb
 ┣ 📜index.ts
 ┣ 📜package.json
 ┗ 📜tsconfig.json
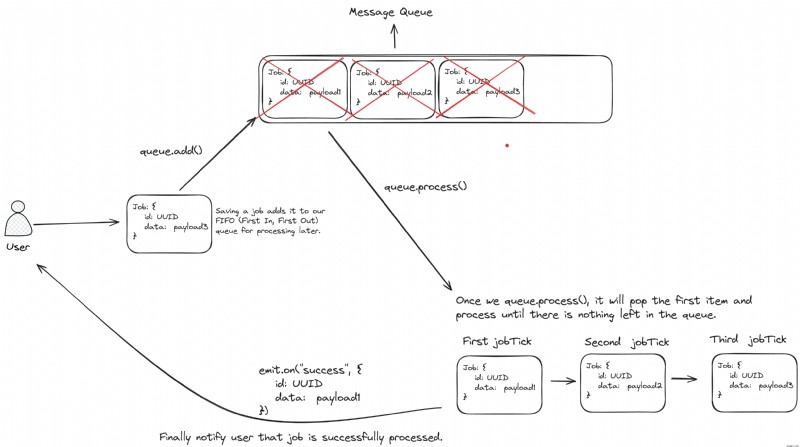
हमारे Queue का दृश्य प्रतिनिधित्व इस तरह होगा:
Job
हमारी Job क्लास को कुछ प्रमुख चीजों की आवश्यकता है। सबसे पहले, हमें प्रत्येक जॉब की स्थिति को ट्रैक करने की आवश्यकता है। यह तय करने में हमारी मदद करता है कि उन्हें प्रोसेस करना है, फिर से प्रयास करना है, या उन्हें कहीं और ले जाना है यदि वे पहले से ही समाप्त हो चुके हैं। प्रत्येक जॉब की एक आईडी और कुछ डेटा भी होता है, जिसे सामान्य होने की आवश्यकता होती है ताकि हम एक शानदार उपयोगकर्ता अनुभव प्रदान कर सकें। अंत में, हमें प्रत्येक जॉब को उसकी कतार से जोड़ना होगा और आसान प्रबंधन के लिए कतार नाम शामिल करना होगा।
हमारी Job क्लास की रीढ़ यहाँ है:
type OwnerQueue = { redis: Redis; queueName: string; };
export type JobStatuses = | "created" | "waiting" | "active" | "succeeded" | "failed";
export class Job<T> {
  id: string;
  status: JobStatuses;
  config: OwnerQueue;
  data: T;
  constructor(ownerConfig: OwnerQueue, data: T, jobId = randomUUID()) {
    this.id = jobId;
    this.status = "created";
    this.data = data;
    this.config = ownerConfig;
  }
}
data को सामान्य बनाने के लिए, हमें पहले Job को ही सामान्य बनाने की आवश्यकता है। बाकी सीधे तरीके से अनुसरण करता है। हम प्रत्येक Job तत्व के लिए एक अलग Redis इंस्टेंस बना सकते हैं, लेकिन इसे प्रबंधित करना जटिल होगा।
सौभाग्य से, हमारा दृष्टिकोण कतार के भीतर Redis इंस्टेंस के आसान कॉन्फिगरेशन की अनुमति देता है, और हम इसे आवश्यकतानुसार पास कर सकते हैं। वही सिद्धांत queueName पर लागू होता है। चूंकि हम नौकरियों को कतार में सहेजने के लिए इसका अक्सर उपयोग करेंगे, हमारी नौकरियों को उनके माता-पिता कतारों के बारे में पता होना चाहिए। कतार में नौकरियों को सहेजने में सक्षम होने के लिए, हमें दो चीजों की आवश्यकता है: Redis के साथ इंटरैक्ट करने के लिए एक Lua स्क्रिप्ट और कुछ यूटिलिटीज।
आइए पहले अपनी यूटिलिटीज बनाएं:
import { JobStatuses } from "./job";
const MQ_PREFIX = "UpstashMQ";
export const formatMessageQueueKey = (queueName: string, key: string) => {
  return `${MQ_PREFIX}:${queueName}:${key}`;
};
export const convertToJSONString = <T>( data: T, status: JobStatuses, ): string => {
  return JSON.stringify({ data, status, });
};
चूंकि हर बार जब हम Redis का उपयोग करते हैं तो मैन्युअल रूप से अपना कतार नाम बनाना आदर्श नहीं है, हमने formatMessageQueueKey नामक एक यूटिलिटी बनाई है। यह यूटिलिटी केवल स्ट्रिंग्स को एक साथ जोड़ती है। इसके अलावा, हमें Redis में स्टोर करने के लिए अपने डेटा को सीरियलाइज़ करने की आवश्यकता है - हम केवल JS ऑब्जेक्ट्स को डेटा स्रोत के रूप में पास नहीं कर सकते; उन्हें पहले स्ट्रिंग्स में बदलने की आवश्यकता है। चूंकि डेटा सामान्य है, हमने इस उद्देश्य के लिए एक सामान्य फ़ंक्शन, convertToJSONString लागू किया है।
अब, आइए अपना पहला Lua स्क्रिप्ट जोड़ें:
add-job.lua
--[[ key 1 -> [prefix]:name:jobs key 2 -> [prefix]:name:waiting arg 1 -> job id arg 2 -> job data ]]
local jobId = ARGV[1]
local payload = ARGV[2]
if redis.call("hexists", KEYS[1], jobId) == 1 then return nil end
redis.call("hset", KEYS[1], jobId, payload)
redis.call("lpush", KEYS[2], jobId)
return jobId
हम इन कॉल्स को अपने Redis इंस्टेंस के साथ व्यक्तिगत रूप से निष्पादित कर सकते हैं, इस प्रकार:
redis.hexists(jobId)redis.hset(jobId,payload)redis.lpush(jobId,payload)
हालांकि, इस दृष्टिकोण के परिणामस्वरूप तीन अलग-अलग कॉल होंगे। Redis सर्वर पर राउंड ट्रिप को कम करने के लिए, हम पूरी प्रक्रिया को एक ही कॉल में समेकित करना चाहते हैं।
आइए अपनी save() मेथड जोड़ें
private createQueueKey(key: string) {
  return formatMessageQueueKey(this.config.queueName, key);
}
async save(): Promise<string | null> {
  const addJobToQueueScript = await Bun.file("./src/lua-scripts/add-job.lua").text();
  const resJobId = (await this.config.redis.eval(
    addJobToQueueScript,
    2,
    this.createQueueKey("jobs"),
    this.createQueueKey("waiting"),
    this.id,
    convertToJSONString(this.data, this.status)
  )) as string | null;
  if (resJobId) {
    this.id = resJobId;
    return resJobId;
  }
  return null;
}
कोड सीधा है, लेकिन मुझे आगे स्पष्ट करने दें। अपना Lua स्क्रिप्ट बनाने के बाद, हम इसे redis.eval का उपयोग करके कॉल करते हैं, जो Lua स्क्रिप्ट निष्पादित करने के लिए आवश्यक है। redis.eval के पैरामीटर निम्नानुसार हैं:
- पहला पैरामीटर स्क्रिप्ट की आवश्यकता है।
- दूसरा पैरामीटर तर्कों की संख्या निर्दिष्ट करता है।
- तीसरा और चौथा पैरामीटर कुंजियों के लिए हैं।
- अंत में, हम वास्तविक तर्क पास करते हैं।
इससे पहले कि हम अपनी Job क्लास समाप्त करें, आइए भविष्य के लिए कुछ और मेथड जोड़ें।
fromId = async <T>(jobId: string): Promise<Job<T> | null> => {
  const jobData = await this.config.redis.hget(this.createQueueKey("jobs"), jobId);
  if (jobData) {
    return this.fromData<T>(jobId, jobData);
  }
  return null;
};
private fromData = <T>(jobId: string, stringifiedJobData: string): Job<T> => {
  const parsedData = JSON.parse(stringifiedJobData) as Job<T>;
  const job = new Job<T>(this.config, parsedData.data, jobId);
  job.status = parsedData.status;
  return job;
};
अभी, हमें इन फ़ंक्शन की आवश्यकता नहीं हो सकती है, लेकिन जब हम भविष्य में नौकरियों को प्रोसेस करना शुरू करेंगे तो वे महत्वपूर्ण हो जाएंगे। उस समय, हमारे पास केवल जॉब की आईडी (jobId) होगी, और हमें स्क्रैच से अपनी नौकरियों को पुनर्निर्माण करने के लिए एक मेथड की आवश्यकता होगी। यह वही है जो fromId पूरा करता है। यह Redis से जॉब डेटा प्राप्त करता है, इसे Job इंस्टेंस में बदलता है, और इसे वापस करता है, ताकि कतार बाद में इस जॉब को प्रोसेस कर सके।
Queue पर आगे बढ़ना
save() भाग पूरा होने के बाद, आइए Queue के विवरण में तल्लीन करें। यहां हमारे उद्देश्य हैं:
- हम अपनी कतार को सफलता या विफलता पर डेटा को बनाए रखने या हटाने का लक्ष्य रखते हैं, क्योंकि ऐसे मामले हो सकते हैं जहां बाद में पुन: प्रसंस्करण की आवश्यकता हो।
- हम कतार को समवर्तीता के लिए डिजाइन करना चाहते हैं, जिससे कई नौकरियां एक साथ चल सकें।
- हमारा लक्ष्य डेटा प्रोसेसिंग के लिए एक कॉलबैक फ़ंक्शन पास करने की अनुमति देना है। यह फ़ंक्शन बेहतर डेवलपर अनुभव के लिए Job के प्रकार का अनुमान लगाना चाहिए।
- हम कतार के भीतर
Job.save()को कॉल करने में सक्षम होने की योजना बना रहे हैं, जिससे हम Redis इंस्टेंस औरqueueNameपास कर सकें। - अंत में, हम आवश्यकता पड़ने पर कतार को नष्ट करने और कतार से एक जॉब को हटाने की क्षमता सुनिश्चित करना चाहते हैं।
आइए अपनी Queue को परिभाषित करके शुरू करें
export type QueueConfig = {
  redis: Redis;
  queueName: string;
  keepOnSuccess?: boolean;
  keepOnFailure?: boolean;
};
export class Queue extends EventEmitter {
  config: QueueConfig;
  concurrency = 0;
  worker: any;
  running = 0;
  queued = 0;
  constructor(config: QueueConfig) {
    super();
    this.config = {
      redis: config.redis,
      queueName: config.queueName,
      keepOnFailure: config.keepOnFailure ?? true,
      keepOnSuccess: config.keepOnSuccess ?? true,
    };
  }
  createQueueKey(key: string) {
    return formatMessageQueueKey(this.config.queueName, key);
  }
}
Queue क्लास में बाहरी जानकारी स्वीकार करने के लिए एक कॉन्फिग शामिल है, जैसे कतार नाम, Redis इंस्टेंस, और डेटा को बनाए रखने या हटाने के लिए सेटिंग्स। हम किसी भी Redis कार्यान्वयन का स्वागत करते हैं जिसे उपयोगकर्ता पसंद करते हैं, हालांकि हमें Upstash के लिए विशेष प्राथमिकता है 😌। यह लचीलापन उपयोगकर्ताओं को कतार को अपने मौजूदा सिस्टम में आसानी से एकीकृत करने की अनुमति देता है।
और, हमारा क्लास Event Emitter को एक्सटेंड करता है ताकि जब कुछ हो तो उन्हें सूचित किया जा सके।
यहां एक उदाहरण आरंभीकरण है:
const queue = new Queue({
  redis: new Redis(process.env.UPSTASH_REDIS_URL),
  queueName: "upstash-rocks",
  keepOnFailure: true,
  keepOnSuccess: true,
});
Add
async add<T>(payload: T) {
  return new Job<T>(this.config, payload).save();
}
हमारा जॉब पैरेंट कतार के कॉन्फिगरेशन विवरण और पेलोड लेता है, जो वह डेटा है जिसे Redis में संग्रहीत किया जाएगा। हम फिर बस इसे सहेजते हैं।
अब हम यह कर सकते हैं:
const queue = new Queue({
  redis: new Redis(process.env.UPSTASH_REDIS_URL!),
  queueName: "mytest-queue",
  keepOnFailure: true,
  keepOnSuccess: true,
});
const payload = { upstash: "best-redis-ever", };
await queue.add(payload);
अब, हमें उन्हें प्रोसेस करने का एक तरीका चाहिए।
प्रोसेसिंग
यह हमारे कतार कार्यान्वयन का सबसे चुनौतीपूर्ण हिस्सा है। हमें अपने उपयोगकर्ताओं को समवर्ती प्रक्रियाओं की संख्या निर्दिष्ट करने और एक वर्कर प्रदान करने की आवश्यकता है – नौकरियों को प्रोसेस करने के लिए एक कॉलबैक फ़ंक्शन जो जॉब के प्रकार का अनुमान लगाएगा। इसके अलावा, हमें वर्तमान में चल रही नौकरियों और कतारबद्ध नौकरियों की संख्या को ट्रैक करने के लिए एक तंत्र की आवश्यकता है, जिससे हम कतार से अगली नौकरी को सुरक्षित रूप से चुन सकें।
async process<TJobPayload>(
  worker: (job: TJobPayload) => void,
  concurrency: number
): Promise<void> {
  this.concurrency = concurrency;
  this.worker = worker;
  this.running = 0;
  this.queued = 1;
  this.jobTick();
}
सामान्य TJobPayload को स्वीकार करने का प्राथमिक उद्देश्य हमारे उपयोगकर्ताओं के लिए डेवलपर अनुभव को बढ़ाना है। हम उन्हें हमारी कतार का उपयोग करते समय इंटेलीसेंस से लाभ उठाने में सक्षम बनाना चाहते हैं। उपयोगकर्ता जानते हैं कि उन्होंने जॉब में {hello: "world"} जैसा डेटा संग्रहीत किया है, लेकिन TypeScript को सटीक इंटेलीसेंस प्रदान करने के लिए सहायता की आवश्यकता है। यही कारण है कि हमारे पास यह तंत्र है, TypeScript को सूचित करने और बेहतर डेवलपर अनुभव के लिए इसे अनुमान लगाने के लिए मजबूर करने के लिए।
jobTick() पर आगे बढ़ने से पहले, आइए प्रक्रिया पर सावधानीपूर्वक विचार करें:
- चूंकि हमारी कतार FIFO (फर्स्ट इन फर्स्ट आउट) आधार पर काम करती है, हमें कतार के दाईं ओर से एक जॉब को पॉप करके शुरू करने की आवश्यकता है।
- अगला, हम इस जॉब पर अपना वर्कर फ़ंक्शन चलाते हैं।
- जॉब पूरा होने के बाद, हम परिणाम को अपने उपयोगकर्ता को उत्सर्जित करते हैं।
- अंत में, हम अगली जॉब को प्रोसेस करने के लिए फिर से
jobTick()कॉल करते हैं।
इसलिए, jobTick() में ये तीन महत्वपूर्ण भाग होंगे।
private jobTick() {
  this.getNextJob()
    .then(async (jobId) => {
      this.running += 1;
      this.queued -= 1;
      if (this.running + this.queued < this.concurrency) {
        this.queued += 1;
        setImmediate(this.jobTick);
      }
      if (!jobId) { return; }
      const jobCreatedById = await new Job(this.config, null).fromId(jobId);
      if (jobCreatedById) {
        await this.executeJob(jobCreatedById);
      } else {
        console.error(`Job not found with ID: ${jobId}`);
      }
    })
    .catch((error) => { console.error("Error in jobTick:", error); })
    .finally(() => { setImmediate(() => this.jobTick()); });
}
मैं फ़ंक्शन दर फ़ंक्शन समझाने की कोशिश करूंगा। आइए getNextJob() से शुरू करें
private async getNextJob() {
  try {
    const jobId = await this.config.redis.brpoplpush(
      this.createQueueKey("waiting"),
      this.createQueueKey("active"),
      0
    );
    return jobId;
  } catch (error) {
    console.error("Error fetching the next job:", error);
    throw error;
  }
}
हम बस Redis पर एक कॉल कर रहे हैं, लेकिन एक रणनीतिक दृष्टिकोण के साथ: हम राउंड ट्रिप की संख्या को कम करने के लिए lpush के साथ ब्लॉकिंग कॉल का उपयोग करते हैं। ब्लॉकिंग कॉल का उपयोग जानबूझकर किया जाता है; हम अन्य श्रमिकों को एक ही समय में एक ही जॉब को प्रोसेस करने से रोकना चाहते हैं, इस प्रकार रेस कंडीशन से बचते हैं। इसके अलावा, हम नौकरियों को 'waiting' स्टेट से 'active' में ले जाते हैं, प्रभावी रूप से उन्हें प्रक्रिया में अगले चरणों के लिए तैयार करते हैं।
this.getNextJob().then(async (jobId) => {
  this.running += 1;
  this.queued -= 1;
  if (this.running + this.queued < this.concurrency) {
    this.queued += 1;
    setImmediate(this.jobTick);
  }
  if (!jobId) { return; }
  const jobCreatedById = await new Job(this.config, null).fromId(jobId);
  if (jobCreatedById) {
    await this.executeJob(jobCreatedById);
  } else {
    console.error(`Job not found with ID: ${jobId}`);
  }
});
अब जब हमारे पास jobId है, तो हम चल रही नौकरियों की संख्या को एक से बढ़ाते हैं और कतारबद्ध संख्या को एक से घटाते हैं। हम समवर्ती सीमा का सम्मान करते हुए जितनी संभव हो उतनी नई नौकरियां शुरू करने का भी प्रयास करते हैं:
if (this.running + this.queued < this.concurrency) {
  this.queued += 1;
  setImmediate(this.jobTick);
}
अगर सब ठीक रहा, तो हम fromId का उपयोग करके अपना Job बनाने के लिए आगे बढ़ते हैं। एक बार जब हम उसकी आईडी द्वारा अपनी नौकरी को सफलतापूर्वक पुनर्निर्मित कर लेते हैं, तो हम अपने वर्कर फ़ंक्शन के साथ जॉब को निष्पादित करने के लिए आगे बढ़ते हैं।
आइए executeJob पर आगे बढ़ें
private async executeJob<TJobPayload>(jobCreatedById: Job<TJobPayload>) {
  let hasError = false;
  try {
    await this.worker(jobCreatedById.data);
    this.running -= 1;
    this.queued += 1;
  } catch (error) {
    hasError = true;
  } finally {
    const [jobStatus, job] = await this.finishJob<TJobPayload>(jobCreatedById, hasError);
    this.emit(jobStatus, job.id);
    return;
  }
}
अब जब हमारे पास जॉब का डेटा है, तो हम इस डेटा को अपने worker को पास करते हैं। यदि यह सफलतापूर्वक निष्पादित होता है, तो हम कतारबद्ध नौकरियों की संख्या को एक से बढ़ाते हैं और चल रही संख्या को एक से घटाते हैं। यह कदम महत्वपूर्ण है; यदि सही ढंग से नहीं संभाला गया, तो यह समवर्ती रूप से नई नौकरियों को लॉन्च करने की हमारी क्षमता को प्रभावित कर सकता है। वर्कर के निष्पादन के दौरान त्रुटि के मामले में, हम केवल hasError फ्लैग को स्विच करते हैं। अंत में, हम अपने jobCreatedById और hasError फ्लैग के साथ finishJob को कॉल करते हैं और jobId के साथ स्टेटस उत्सर्जित करते हैं।
साइड नोट: उपयोगकर्ता अब इस तरह उत्सर्जित अपडेट को सुन सकते हैं।
queue.on("succeeded", (jobId) => console.log("Succeeded jobId", jobId));आइए finishJob पर आगे बढ़ें
private async finishJob<TJobPayload>(
  job: Job<TJobPayload>,
  hasFailed?: boolean
): Promise<[JobStatuses, Job<TJobPayload>]> {
  const multi = this.config.redis.multi();
  multi.lrem(this.createQueueKey("active"), 0, job.id);
  if (hasFailed) {
    if (this.config.keepOnFailure) {
      multi.hset(this.createQueueKey("jobs"), job.id, convertToJSONString(job.data, job.status));
      multi.sadd(this.createQueueKey("failed"), job.id);
    } else {
      multi.hdel(this.createQueueKey("jobs"), job.id);
    }
    job.status = "failed";
  } else {
    if (this.config.keepOnSuccess) {
      multi.hset(this.createQueueKey("jobs"), job.id, convertToJSONString(job.data, job.status));
      multi.sadd(this.createQueueKey("succeeded"), job.id);
    } else {
      multi.hdel(this.createQueueKey("jobs"), job.id);
    }
    job.status = "succeeded";
  }
  await multi.exec();
  return [job.status, job];
}
यहां एक महत्वपूर्ण पहलू multi() का उपयोग है क्योंकि हमारा उद्देश्य हमेशा राउंड ट्रिप को कम करना है। multi का उपयोग करके, Redis निष्पादन को तब तक स्थगित करता है जब तक हम exec() कॉल नहीं करते। यदि उपयोगकर्ता ने डेटा को संरक्षित करने के लिए keepOnFailure और keepOnSuccess सेट किया है, तो हम दो सेट बनाएंगे: एक जॉब के डेटा के साथ और दूसरा जॉब आईडी की सूची के साथ इस डेटा तक पहुंचने के लिए। यह दृष्टिकोण सफलता और विफलता दोनों परिदृश्यों पर लागू होता है। स्वाभाविक रूप से, हम जॉब की स्थिति को तदनुसार समायोजित करते हैं। अंत में, हम exec के साथ मल्टी कमांड निष्पादित करते हैं और घटना उत्सर्जन उद्देश्यों के लिए जॉब की स्थिति और जॉब को वापस करते हैं।
अंत में, हमारे पास दो शेष मेथड हैं, जिनका मैं विस्तार से विवरण नहीं दूंगा, क्योंकि वे अवधारणाओं का उपयोग करते हैं जिनसे हम पहले से परिचित हैं।
async removeJob(jobId: string) {
  const addJobToQueueScript = await Bun.file("./src/lua-scripts/remove-job.lua").text();
  return await this.config.redis.eval(
    addJobToQueueScript,
    5,
    this.createQueueKey("succeeded"),
    this.createQueueKey("failed"),
    this.createQueueKey("waiting"),
    this.createQueueKey("active"),
    this.createQueueKey("jobs"),
    jobId
  );
}
async destroy() {
  const args = ["id", "jobs", "waiting", "active", "succeeded", "failed"].map((key) => this.createQueueKey(key) );
  const res = await this.config.redis.del(...args);
  return res;
}
remove-job.lua
--[[ key 1 -> [prefix]:test:succeeded key 2 -> [prefix]:test:failed key 3 -> [prefix]:test:waiting key 4 -> [prefix]:test:active key 5 -> [prefix]:test:jobs arg 1 -> jobId ]]
local jobId = ARGV[1]
if (redis.call("sismember", KEYS[1], jobId) + redis.call("sismember", KEYS[2], jobId)) == 0 then
  redis.call("lrem", KEYS[3], 0, jobId)
  redis.call("lrem", KEYS[4], 0, jobId)
end
redis.call("srem", KEYS[1], jobId)
redis.call("srem", KEYS[2], jobId)
redis.call("hdel", KEYS[5], jobId)
destroy() पूरी कतार को पूरी तरह से मिटाने के लिए है, और दूसरा कतार से एक विशिष्ट जॉब को हटाने के लिए है।
आइए सब कुछ एक्शन में देखें
import { sleep } from "bun";
import Redis from "ioredis";
import { Queue } from "./queue";
type Payload = { id: number; data: string; };
const queue = new Queue({
  redis: new Redis(process.env.UPSTASH_REDIS_URL),
  queueName: "mytest-queue",
});
async function main() {
  await generateQueueItems(queue, 20);
  console.log("Sleep starting for 5 sec");
  await sleep(5000);
  queue.on("succeeded", (jobId) => console.log("Succeeded jobId", jobId));
  await queue.process<Payload>((job) => {
    console.log("Processing job:", job.data);
    sleep(1000);
  }, 3);
}
main();
async function generateQueueItems(queue: Queue, itemCount: number) {
  for (let i = 0; i < itemCount; i++) {
    const payload = {
      id: i,
      data: `dummy-data-${i}`,
      // अपने परीक्षण के लिए आवश्यकतानुसार अधिक गुण जोड़ें
    };
    const jobId = await queue.add(payload);
    console.log(`Added item ${i} with jobId: ${jobId}`);
  }
}
बोनस चुनौतियाँ
- Redis एक्सेस और वर्कर प्रक्रियाओं दोनों के लिए एक्सपोनेंशियल बैकऑफ के साथ रिट्री लॉजिक लागू करें।
- 'कम से कम एक बार' गारंटी तंत्र विकसित करें।
- बेहतर प्रदर्शन के लिए सर्विस वर्कर्स में वर्कर्स को निष्पादित करने का प्रयास करें
- शेड्यूल्ड जॉब्स जोड़ें
समापन
कुछ सीखने का सबसे अच्छा तरीका इसे बनाना है, और एक और भी बेहतर दृष्टिकोण Upstash Redis का उपयोग करके ऐसा करना है। रॉक करते रहें।
🔗 प्रोजेक्ट का Github पता