
हम क्या बना रहे हैं
इस लेख में, हम अत्यधिक टिकाऊ LLM स्ट्रीम बना रहे हैं जो आसानी से बच जाते हैं:
- नेटवर्क आउटेज
- पेज रिफ्रेश
- वेबसाइट बंद करना
- लैपटॉप ढक्कन बंद करना
बोनस: आप एक ही स्ट्रीम को एक ही समय में कई डिवाइस (जैसे फोन और लैपटॉप) पर देख सकते हैं।
कोई फर्क नहीं पड़ता कि आप स्ट्रीम को तोड़ने की कितनी कोशिश करते हैं, यह बैकग्राउंड में जारी रहता है जब आप डिस्कनेक्ट होते हैं और जब आप वापस आते हैं तो सुचारू रूप से जारी रहता है। यह एक अविश्वसनीय यूजर एक्सपीरियंस है।
टिकाऊ LLM स्ट्रीम डेमो 👇
प्रेरणा
AI के साथ निर्माण करते समय, रियल-टाइम में AI प्रतिक्रियाओं को स्ट्रीम करना एक सर्वोत्तम अभ्यास है।
पूरी प्रतिक्रिया की प्रतीक्षा करने के बजाय, आपका यूजर कंटेंट को रियल-टाइम में देखता है जैसे ही यह उत्पन्न होता है - जो UX के लिए अद्भुत है। Vercel द्वारा AI SDK जैसे टूल्स ने इसे बेहद आसान बना दिया है:
import { openai } from "@ai-sdk/openai";
import { streamText } from "ai";
const { textStream } = streamText({
  model: openai("gpt-4o"),
  prompt: "एक नई छुट्टी का आविष्कार करें और इसकी परंपराओं का वर्णन करें।",
});
तकनीकी स्तर पर रियल-टाइम LLM स्ट्रीम काम करने के लिए, आप एक क्लाइंट को एक API से कनेक्ट करते हैं और सर्वर सेंट इवेंट्स (SSE) जैसे प्रोटोकॉल का उपयोग करके डेटा को वापस स्ट्रीम करते हैं:
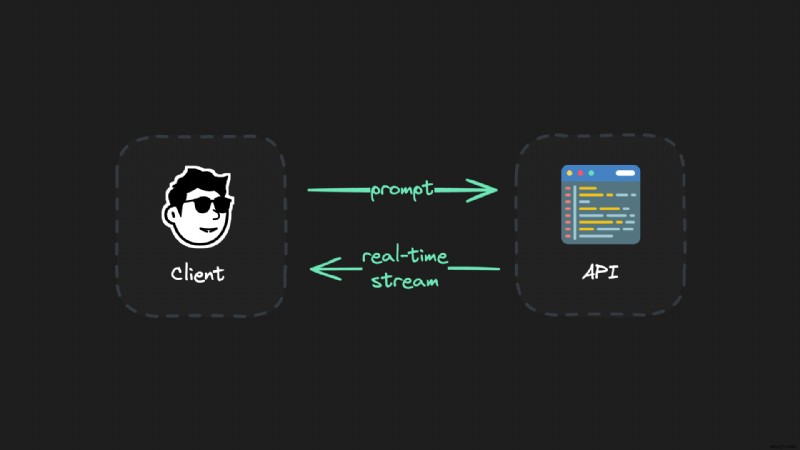
लेकिन: इस सेटअप में एक समस्या है।
यदि स्ट्रीम के दौरान कुछ भी होता है, जैसे आपका इंटरनेट डिस्कनेक्ट होना, लैपटॉप ढक्कन बंद करना, या नेटवर्क हिचकी, तो पूरी जनरेशन खो जाती है। आपको फिर से शुरू करना होगा और पूरी जनरेशन के लिए फिर से प्रतीक्षा करनी होगी। यह विशेष रूप से लंबी जनरेशन (जैसे O1 जैसे महंगे मॉडल के साथ) के लिए कष्टप्रद है।
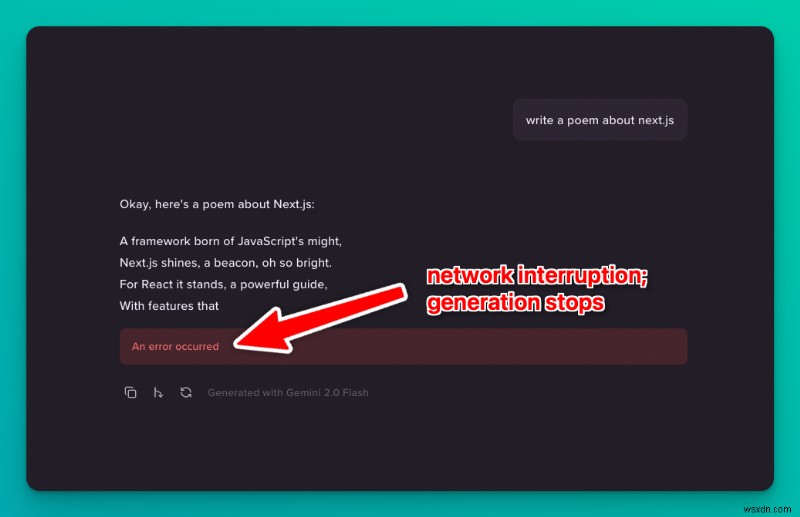
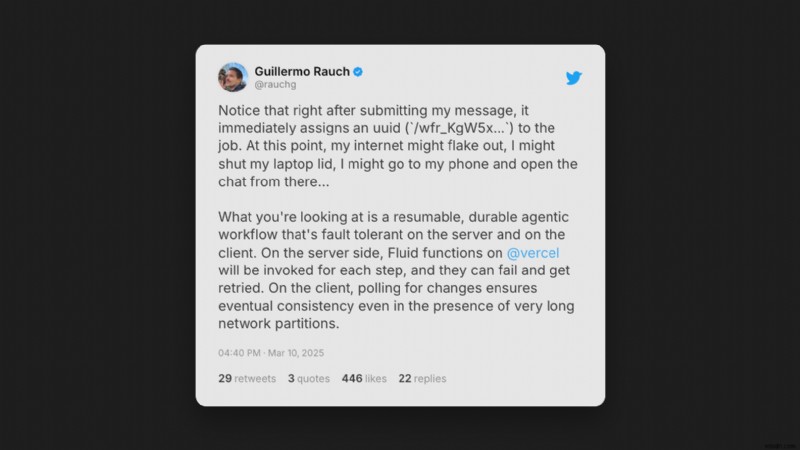
जाहिर है यह समस्या लोगों के रडार पर है। विश्वसनीय रियल-टाइम LLM स्ट्रीमिंग की वास्तविक मांग है, और अधिक डेवलपर्स इसे काम करने के तरीकों के साथ प्रयोग कर रहे हैं:
हाई-ड्यूरेबिलिटी LLM स्ट्रीम बनाना
वास्तव में टिकाऊ, रिज्यूमेबल LLM स्ट्रीम बनाने का सीक्रेट सॉस क्लाइंट को जनरेशन एनवायरनमेंट से अलग करना है। क्लाइंट कनेक्शन अस्थिर होते हैं और कई कारणों से डिस्कनेक्ट हो सकते हैं, जैसे लैपटॉप बंद करना, नेटवर्क समस्याएं या पेज रिफ्रेश करना।
क्लाइंट और जनरेशन प्रोसेस को अलग रखकर, जनरेशन हमेशा निर्बाध रूप से जारी रहती है। क्लाइंट किसी भी समय पुनः कनेक्ट कर सकते हैं - चल रही जनरेशन को बाधित किए बिना।
बुरा विचार: लगातार, डायरेक्ट कनेक्शन:
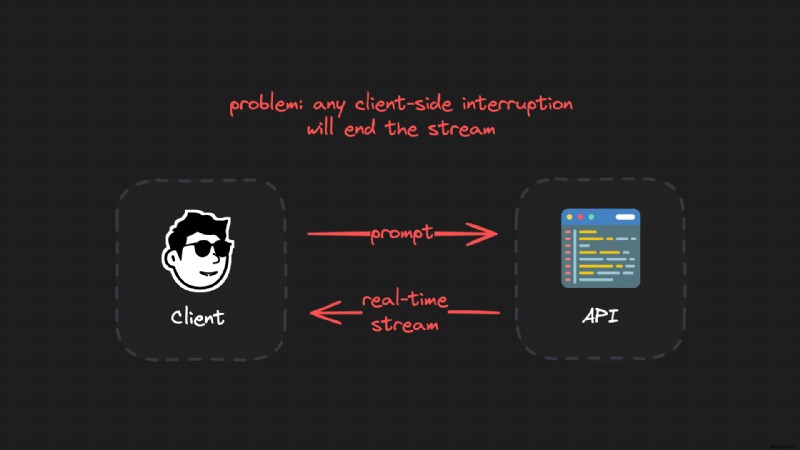
अच्छा विचार: रिप्लेसेबल, इंटरप्टिबल स्ट्रीम कनेक्शन:
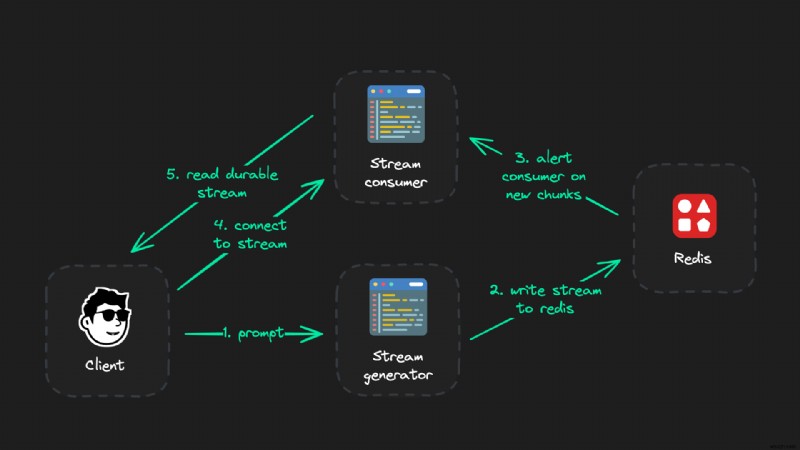
और हां - यह आर्किटेक्चर एक साधारण AI स्ट्रीम के लिए काफी जटिल लग सकता है। जैसा कि आप अभी कोड में देखेंगे, यह केवल कुछ लाइनों का कोड है और इसे लागू करने में केवल कुछ मिनट लगते हैं।
टिकाऊ स्ट्रीम सेट करना
एक अत्यधिक विश्वसनीय LLM स्ट्रीम सेटअप के तीन भाग हैं:
- क्लाइंट (फ्रंटएंड)
- स्ट्रीम जनरेटर (एक API रूट)
- स्ट्रीम कंज्यूमर (एक API रूट भी)
क्लाइंट के लिए सभी डायरेक्ट कनेक्शन किसी भी समय इंटरप्ट या पॉज किए जा सकते हैं। LLM आउटपुट स्ट्रीम जनरेट करने के लिए जिम्मेदार लॉजिक का टुकड़ा (स्ट्रीम जनरेटर) इसलिए एक स्वतंत्र API होना चाहिए जिसका क्लाइंट के साथ कभी भी एक्टिव कनेक्शन न हो।
इसके बजाय, हम एक कंज्यूमर के माध्यम से क्लाइंट से कनेक्ट करेंगे - जो सिर्फ रेडिस से डेटा पढ़ता है और अन्यथा बहुत "बेवकूफ" है। इसका एकमात्र उद्देश्य जनरेटर के आउटपुट को पढ़ना और जब भी कोई क्लाइंट इससे कनेक्ट होता है तो उन सभी LLM चंक्स को प्रदान करना है जो क्लाइंट ने अभी तक नहीं देखे हैं। बस इतना ही।
त्वरित सारांश - प्रत्येक भाग क्या करता है:
- क्लाइंट: स्ट्रीम जनरेटर को ट्रिगर करता है (लेकिन कभी भी ओपन कनेक्शन नहीं रखता) और रियल-टाइम स्ट्रीम रेंडर करता है
- स्ट्रीम जनरेटर: रियल-टाइम में LLM आउटपुट जनरेट करता है और रेडिस पर पब्लिश करता है
- स्ट्रीम कंज्यूमर: जनरेटर की स्ट्रीम पढ़ता है और चंक्स को क्लाइंट को पुश करता है
जनरेटर केवल LLM स्ट्रीम पढ़ने और इसे रियल-टाइम में रेडिस पर पब्लिश करने के लिए जिम्मेदार है। हमें क्लाइंट से स्ट्रीम कंज्यूमर तक एक रिप्लेसेबल कनेक्शन मिलता है जिसे समाप्त किया जा सकता है, पुनः कनेक्ट किया जा सकता है, आदि - कुछ भी स्ट्रीम जनरेटर को प्रभावित नहीं करता।
कोड उदाहरण
इस सेक्शन में, हम कोड पर एक नज़र डालेंगे। सिद्धांतों को बहुत स्पष्ट बनाने के लिए, हम अंत में वास्तविक, पूर्ण प्रोडक्शन कोड कार्यान्वयन को देखेंगे।
अभी के लिए, कोर स्निपेट्स और उनके उद्देश्य को देखने के बजाय संपूर्ण कोड फाइलों को देखना बहुत आसान है।
1. क्लाइंट
क्लाइंट की केवल 3 जिम्मेदारियां हैं:
- सेशन आईडी जनरेट करना
- जनरेटर को ट्रिगर करना
- जनरेशन स्ट्रीम रेंडर करना
आइए प्रत्येक को देखें:
क्लाइंट: सेशन आईडी जनरेट करना
जब कोई क्लाइंट किसी स्ट्रीम से कनेक्ट या पुनः कनेक्ट होता है, तो हम उन सभी मैसेजेस को भेजना चाहते हैं जो क्लाइंट ने अभी तक नहीं देखे हैं। इसका मतलब है कि एक एक्टिव स्ट्रीम के दौरान, प्रत्येक मैसेज में केवल वही सटीक डेल्टा होता है जिसे क्लाइंट को देखने की आवश्यकता होती है न कि पूरी स्ट्रीम।
पुनः कनेक्ट करते समय, वर्तमान जनरेशन बिंदु तक पूरी स्ट्रीम भेजी जाती है और सभी भविष्य की घटनाओं की सदस्यता किसी भी लापता चंक के बिना बिल्कुल निर्बाध होती है।
कैसे?
रेडिस स्ट्रीम्स, रियल-टाइम डेटा को कुशलतापूर्वक स्टोर और पुनर्प्राप्त करने का एक तरीका, कंज्यूमर ग्रुप्स नामक किसी चीज़ के माध्यम से इस नॉट-येट-सीन कार्यक्षमता को बिल्ट-इन करते हैं। हमें केवल एक चीज करने की आवश्यकता है: सुनिश्चित करें कि प्रत्येक क्लाइंट का एक यूनिक सेशन है - जिसका अर्थ है कि हम प्रत्येक जनरेशन को एक यूनिक आईडी असाइन करते हैं।
जब हम स्ट्रीम कंज्यूमर को देखेंगे तो हम कंज्यूमर ग्रुप्स के बारे में अधिक जानेंगे। वे इस तरह दिखते हैं:
await redis.xgroup("redis-key", { type: "CREATE", group: "my-group-name", id: "0", });किस क्लाइंट ने किस स्ट्रीम को किस बिंदु तक देखा है और कौन से टुकड़े गायब हैं, इसकी पूरी लॉजिक रेडिस स्ट्रीम्स द्वारा पूरी तरह से गारंटीकृत सटीकता के साथ संभाली जाती है। हमें कभी भी लापता LLM चंक नहीं मिलता और हमेशा वही डेटा भेजते हैं जिसकी क्लाइंट को आवश्यकता होती है।
क्लाइंट को अभी केवल एक चीज करने की आवश्यकता है: प्रत्येक जनरेशन के लिए एक आईडी असाइन करें। हम बस nanoid का उपयोग करते हैं:
import { customAlphabet } from "nanoid"
const nanoid = customAlphabet("0123456789", 6);
क्लाइंट: एक जनरेशन स्ट्रीम ट्रिगर करना
क्लाइंट का जनरेशन इंजन के साथ एकमात्र इंटरैक्शन इसे ट्रिगर करना है। तकनीकी रूप से, आप जनरेशन को कहीं और से भी ट्रिगर कर सकते हैं (जैसे CRON जॉब्स, ऑटोमेटेड पाइपलाइन्स)।
इसके सरलतम रूप में, यह केवल जनरेशन API रूट को एक फेच कॉल है:
// 👇 स्ट्रीम जनरेटर ट्रिगर करें
await fetch("/api/llm-stream", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ prompt, sessionId }),
});
क्लाइंट: एक जनरेशन स्ट्रीम पढ़ना
जनरेशन को ट्रिगर करने के बाद, जनरेटर LLM आउटपुट को एक केंद्रीकृत रेडिस स्टोर में स्ट्रीम करना शुरू करता है - क्लाइंट से पूरी तरह से डिकपल्ड। आइए स्ट्रीम कंज्यूमर से कनेक्ट करें ताकि जनरेशन स्ट्रीम पढ़ी जा सके:
// 👇 स्ट्रीम कंज्यूमर से कनेक्ट करें
const res = await fetch(`/api/check-stream?sessionId=${sessionId}`, {
  headers: { "Content-Type": "text/event-stream" },
});
बस इतना ही!
ये क्लाइंट की तीन जिम्मेदारियां हैं। बेशक, हम कस्टम हुक्स के साथ ID जनरेशन, अतिरिक्त विश्वसनीयता के लिए react-query और अधिक के साथ बहुत फैंसी प्राप्त कर सकते हैं - हम बाद में पूर्ण कोड उदाहरणों में उस तक पहुंचेंगे।
2. स्ट्रीम जनरेटर
स्ट्रीम जनरेटर एक LLM स्ट्रीम खोलता है और प्रत्येक चंक को एक रेडिस स्ट्रीम में लिखता है। यह स्ट्रीम कंज्यूमर को रियल-टाइम अपडेट के लिए नए डेटा के बारे में अलर्ट करने के लिए लिखे गए प्रत्येक चंक के लिए एक मैसेज पब्लिश करता है।
नोट: फिर से, यह जानबूझकर एक पूर्ण कोड उदाहरण नहीं है। हम अंत में पूर्ण कोड प्राप्त करेंगे - यह अवधारणा को समझने के लिए है।
import { streamText } from "ai"
import { redis } from "@/utils"
const result = await new Promise(
  async (resolve, reject) => {
    const { textStream } = streamText({
      model: openai("gpt-4o"),
      prompt,
      onError: (err) => reject(err),
      onFinish: async () => {
        resolve({ /* ... */ })
      }
    })
    for await (const chunk of textStream) {
      if (chunk) {
        const chunkMessage: ChunkMessage = {
          type: MessageType.CHUNK,
          content: chunk,
        }
        // 👇 चंक को रेडिस स्ट्रीम में लिखें
        await redis.xadd(streamKey, "*", chunkMessage)
        // 👇 कंज्यूमर को अलर्ट करें कि एक नया चंक है
        await redis.publish(streamKey, { type: MessageType.CHUNK })
      }
    }
  }
)
3. स्ट्रीम कंज्यूमर
स्ट्रीम कंज्यूमर रेडिस से कनेक्ट होता है और रेडिस पब/सब के माध्यम से नए चंक अलर्ट सुनता है। प्रत्येक क्लाइंट को अपने स्वयं के कंज्यूमर ग्रुप मिलते हैं जो इसके देखे गए और अनदेखे मैसेजेस को ट्रैक करते हैं।
नोट: पब्लिश वास्तविक चंक को ट्रांसफर नहीं करता है, यह सिर्फ अलर्ट करता है कि स्ट्रीम में एक नया चंक उपलब्ध है।
जब एक नया चंक उपलब्ध होता है, तो स्ट्रीम कंज्यूमर API इसे स्ट्रीम से पढ़ता है और सभी कनेक्टेड क्लाइंट्स को फॉरवर्ड करता है। रेडिस कंज्यूमर ग्रुप्स ट्रैक करते हैं कि प्रत्येक क्लाइंट ने क्या देखा है ताकि कोई डुप्लिकेट या लापता चंक ट्रांसफर न हो।
कोर स्ट्रीम कंज्यूमर इस तरह दिखता है:
const streamKey = `llm:stream:${sessionId}`;
const groupName = `sse-group-${nanoid()}`;
await redis.xgroup(streamKey, {
  type: "CREATE",
  group: groupName,
  id: "0",
});
const readStreamMessages = async () => {
  const chunks = (await redis.xreadgroup(
    groupName,
    `consumer-1`,
    streamKey,
    // 👇 बिल्ट-इन रेडिस स्ट्रीम कार्यक्षमता: केवल अनदेखे मैसेजेस भेजें
    ">",
  )) as StreamData[];
  if (chunks?.length > 0) {
    const [_streamKey, messages] = chunks[0];
    for (const [_messageId, fields] of messages) {
      const rawObj = arrToObj(fields);
      const validatedMessage = validateMessage(rawObj);
      if (validatedMessage) {
        controller.enqueue(json(validatedMessage));
      }
    }
  }
};
// 👇 प्रारंभिक पढ़ें
await readStreamMessages();
const subscription = redis.subscribe(streamKey);
subscription.on("message", async () => {
  // 👇 हर बार पढ़ें जब स्ट्रीम में एक नया चंक लिखा जाता है
  await readStreamMessages();
});
नोट: हम हर कनेक्शन पर एक कंज्यूमर ग्रुप बना रहे हैं। यह इतनी अच्छी तरह से काम करता है क्योंकि रेडिस इस ऑपरेशन को आइडेम्पोटेंटली संभालता है, यानी अगर ग्रुप पहले से मौजूद है तो कुछ नहीं होता।
पूर्ण कोड
सेशनआईडी जनरेशन
अब तक, हमने क्लाइंट के कार्यों, स्ट्रीम जनरेटर और स्ट्रीम कंज्यूमर को व्यक्तिगत रूप से समझने के लिए कोड के व्यक्तिगत टुकड़ों को देखा है। अब, आइए देखें कि ये टुकड़े पूर्ण कार्यान्वयन को देखकर कैसे एक साथ फिट होते हैं।
शुरू करने के लिए, nanoid() का उपयोग करने की तुलना में सेशनआईडी बनाना अधिक लचीला होना चाहिए। आखिरकार, क्या होगा अगर वेबसाइट रिफ्रेश या बंद हो जाए? पुनः कनेक्ट पर, यदि हम इसे कहीं स्टोर नहीं करते हैं तो हम जनरेटेड सेशनआईडी खो देंगे - जब तक जनरेशन चलता है तब तक इसे पर्सिस्ट करने की आवश्यकता है।
सौभाग्य से localStorage इसके लिए एकदम सही है:
import { customAlphabet } from "nanoid";
import { useRouter } from "next/navigation";
import { useCallback, useEffect, useState } from "react";
export const useLLMSession = () => {
  const [sessionId, setSessionId] = useState("");
  const router = useRouter();
  const nanoid = customAlphabet("0123456789", 6);
  const updateUrlWithSessionId = useCallback(
    (id: string) => {
      const url = new URL(window.location.href);
      url.searchParams.set("sessionId", id);
      router.replace(url.toString(), { scroll: false });
    },
    [router],
  );
  useEffect(() => {
    const urlParams = new URLSearchParams(window.location.search);
    const urlSessionId = urlParams.get("sessionId");
    const storedSessionId = localStorage.getItem("llm-session-id");
    if (urlSessionId) {
      localStorage.setItem("llm-session-id", urlSessionId);
      setSessionId(urlSessionId);
    } else if (storedSessionId) {
      setSessionId(storedSessionId);
      updateUrlWithSessionId(storedSessionId);
    } else {
      const newSessionId = nanoid();
      localStorage.setItem("llm-session-id", newSessionId);
      setSessionId(newSessionId);
      updateUrlWithSessionId(newSessionId);
    }
  }, []);
  const clearSessionId = useCallback(() => {
    localStorage.removeItem("llm-session-id");
    setSessionId("");
    const url = new URL(window.location.href);
    url.searchParams.delete("sessionId");
    router.replace(url.toString(), { scroll: false });
  }, [router]);
  const regenerateSessionId = () => {
    const newSessionId = nanoid();
    localStorage.setItem("llm-session-id", newSessionId);
    setSessionId(newSessionId);
    updateUrlWithSessionId(newSessionId);
    return newSessionId;
  };
  return { sessionId, regenerateSessionId, clearSessionId };
};
क्लाइंट
हमने पहले ही क्लाइंट के दो सबसे महत्वपूर्ण भाग देखे हैं: एक स्ट्रीम शुरू करना और एक स्ट्रीम से कनेक्ट करना। एक बार जब हमें अपने API से पुष्टि मिल जाती है कि जनरेटर चल रहा है, तो हम react-query के refetch यूटिलिटी का उपयोग करके अपने कनेक्शन क्वेरी को लागू करके स्ट्रीम से कनेक्ट करते हैं।
यहां सभी टुकड़े एक साथ कैसे फिट होते हैं:
"use client"
import { useLLMSession } from "@/use-llm-session"
import { useMutation, useQuery } from "@tanstack/react-query"
import { FormEvent, useRef, useState, useEffect } from "react"
import { MessageType, validateMessage, type ChunkMessage, type MetadataMessage, StreamStatus } from "@/lib/message-schema"
class PreconditionFailedError extends Error {
constructor(message: string) {
super(message)
this.name = "PreconditionFailedError"
}
}
export default function Home() {
const { sessionId, regenerateSessionId, clearSessionId } = useLLMSession()
const [prompt, setPrompt] = useState("")
const [status, setStatus] = useState<"idle" | "loading" | "streaming" | "completed" | "error">("idle")
const [response, setResponse] = useState("")
const [chunkCount, setChunkCount] = useState(0)
const controller = useRef(null)
const responseRef = useRef(null)
const isInitialRequest = useRef(true)
useEffect(() => {
if (responseRef.current) {
responseRef.current.scrollTop = responseRef.current.scrollHeight
}
}, [response])
const { mutate, error, isIdle } = useMutation({
mutationFn: async (newSessionId: string) => {
controller.current?.abort()
isInitialRequest.current = false
await fetch("/api/llm-stream", {
method: "POST",
headers: { "Content-Type": "application/json" },
body: JSON.stringify({ prompt, sessionId: newSessionId }),
})
},
onSuccess: () => {
setStatus("streaming")
refetch()
},
})
const { refetch } = useQuery({
queryKey: ["stream", sessionId],
queryFn: async () => {
if (!sessionId) return null
setResponse("")
setChunkCount(0)
const abortController = new AbortController()
controller.current = abortController
const res = await fetch(`/api/check-stream?sessionId=${sessionId}`, {
headers: { "Content-Type": "text/event-stream" },
signal: controller.current.signal,
})
if (res.status === 412) {
throw new PreconditionFailedError("Stream not ready yet")
}
if (!res.body) return null
const reader = res.body.pipeThrough(new TextDecoderStream()).getReader()
let streamContent = ""
while (true) {
const { value, done } = await reader.read()
if (done) break
if (value) {
const messages = value.split("\n\n").filter(Boolean)
for (const message of messages) {
if (message.startsWith("data: ")) {
const data = message.slice(6)
try {
const parsedData = JSON.parse(data)
const validatedMessage = validateMessage(parsedData)
if (!validatedMessage) continue
switch (validatedMessage.type) {
case MessageType.CHUNK:
const chunkMessage = validatedMessage as ChunkMessage
streamContent += chunkMessage.content
setResponse((prev) => prev + chunkMessage.content)
setChunkCount((prev) => prev + 1)
break
case MessageType.METADATA:
const metadataMessage = validatedMessage as MetadataMessage
if (metadataMessage.status === StreamStatus.COMPLETED) {
setStatus("completed")
}
break
case MessageType.ERROR:
setStatus("error")
break
}
} catch (e) {
console.error("Failed to parse message:", e)
}
}
}
}
}
return streamContent
},
refetchOnWindowFocus: false,
refetchOnMount: false,
retry(failureCount, error) {
if (isInitialRequest.current === true) return false
if (error instanceof PreconditionFailedError) {
return failureCount < 10
}
return false
},
})
const handleSubmit = async (e: FormEvent) => {
e.preventDefault()
setStatus("loading")
const newSessionId = regenerateSessionId()
mutate(newSessionId)
}
const handleReset = () => {
controller.current?.abort()
clearSessionId()
setPrompt("")
setResponse("")
setChunkCount(0)
setStatus("idle")
}
return (
Resumable LLM Stream