आज हम उन कुछ रणनीतियों में गोता लगाएंगे जिनका उपयोग आप रूबी ऑन रेल्स एप्लिकेशन को एक विशाल उपयोगकर्ता आधार तक स्केल करने के लिए कर सकते हैं।
एप्लिकेशन को स्केल करने का एक स्पष्ट तरीका उन पर अधिक पैसा फेंकना है। और यह आश्चर्यजनक रूप से अच्छी तरह से काम करता है — कुछ और सर्वर जोड़ें, अपने डेटाबेस सर्वर को अपग्रेड करें, और वॉयला, बहुत सारे प्रदर्शन मुद्दे बस पूफ हो जाते हैं!
लेकिन अक्सर अधिक सर्वर जोड़े बिना भी एप्लिकेशन को स्केल करना संभव है। आज हम इसी पर चर्चा करेंगे।
चलिए शुरू करते हैं!
अपने रेल्स एप्लिकेशन के लिए AppSignal का उपयोग करें
स्केलिंग और प्रदर्शन अनुकूलन में गोता लगाने से पहले, आपको पहले यह पहचानने की आवश्यकता है कि क्या आपको ऐसा करने की आवश्यकता है, आपके एप्लिकेशन में बॉटलनेक क्या हैं, और किन संसाधनों को स्केल किया जा सकता है।
इसे करने का एक आसान तरीका रूबी के लिए AppSignal के प्रदर्शन निगरानी और मेट्रिक्स का उपयोग करना है।
प्रदर्शन डैशबोर्ड आपको उन सटीक कंट्रोलर एक्शन्स और बैकग्राउंड जॉब्स को इंगित करने में मदद करता है जो औसतन धीमे हैं।
उदाहरण के लिए, यहां ActiveRecord के लिए एक प्रदर्शन डैशबोर्ड कैसा दिख सकता है:
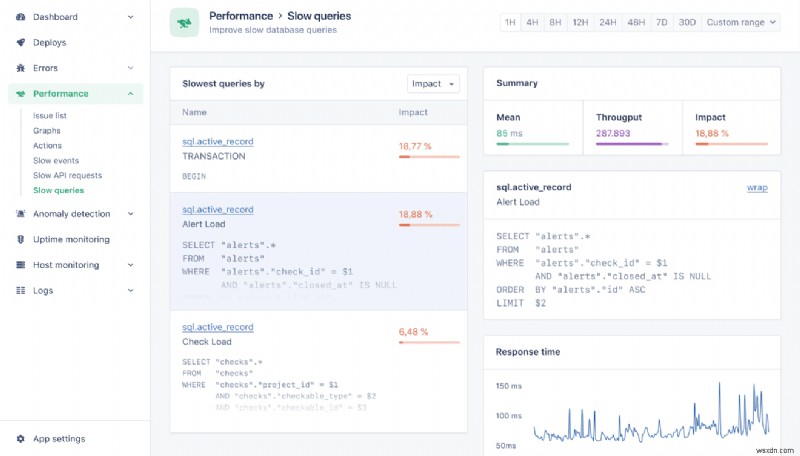
यह किसी भी स्केलिंग यात्रा के लिए एक अच्छा प्रारंभिक बिंदु देता है — चाहे आप अधिक सर्वर जोड़ने का फैसला करें या कोड के माध्यम से प्रदर्शन को अनुकूलित करें।
अब आइए अपने रेल्स ऐप को स्केल करने के लिए उपयोग की जा सकने वाली सबसे सरल तकनीकों में से एक पर चलते हैं — कैशिंग।
रूबी ऑन रेल्स में कैशिंग
कैशिंग आपको बार-बार वही चीजें गणना करने से रोकने की अनुमति देता है।
उदाहरण के लिए, मान लें कि आप एक सोशल मीडिया प्लेटफॉर्म चलाते हैं और एक बहुत लोकप्रिय पोस्ट है। कैशिंग तुरंत आपको उन सभी CPU साइकिलों को पुनः प्राप्त करने में मदद कर सकता है जो आप उस पोस्ट को हर उपयोगकर्ता के लिए रेंडर करने में खर्च करते हैं। और यह केवल एक हिस्सा है जो कैशिंग आपकी मदद कर सकता है।
आइए उन सभी संभावित संसाधनों को देखें जिन्हें कैश किया जा सकता है।
व्यूज़ कैश करना
व्यूज़ रेंडर करना कभी-कभी एक महंगा ऑपरेशन हो सकता है, खासकर जब उस व्यू में रेंडर करने के लिए बहुत सारा डेटा हो। यहां तक कि जब ऑपरेशन महंगा नहीं होता, तो प्री-रेंडर्ड व्यू का उपयोग आपको उसी व्यू को दस लाख बार रेंडर करने के विपरीत बहुत अधिक प्रदर्शन देगा।
रेल्स cache व्यू हेल्पर का उपयोग करके इसे बॉक्स से बाहर सपोर्ट करता है। उदाहरण के लिए, यह एक सूची रेंडर करते समय प्रत्येक पोस्ट को कैसे कैश कर सकता है:
इसके लिए, रेल्स स्वचालित रूप से प्रत्येक पोस्ट को एक विशिष्ट कुंजी के तहत कैश करता है जो टेम्पलेट के HTML कंटेंट, पोस्ट आईडी, और अपडेट टाइमस्टैम्प पर निर्भर करती है।
इस तकनीक के बारे में अधिक पढ़ने के लिए, रेल्स में फ्रैगमेंट कैशिंग और रेल्स कलेक्शन कैशिंग पोस्ट देखें।
एक बात ध्यान में रखने वाली है, हालांकि, कैश कुंजियों में नेस्टेड टेम्पलेट कंटेंट शामिल नहीं होता। इसलिए यदि आप कैश कॉल को एक स्तर से अधिक गहरा नेस्ट कर रहे हैं, तो स्टेल परिणाम हो सकते हैं। रशियन डॉल कैशिंग इन रेल्स में इसके बारे में अधिक पढ़ें।
रिस्पॉन्स कैश करना
व्यूज़/फ्रैगमेंट्स कैश करने के अलावा, आप GET रिक्वेस्ट के पूर्ण रिस्पॉन्स को कैश करना भी चुन सकते हैं। यह ब्राउज़र द्वारा भेजे गए If-None-Match और If-Modified-Since हेडर्स के माध्यम से समर्थित है।
जब रिक्वेस्ट पर If-None-Match हेडर मौजूद होता है, तो सर्वर 304 Not Modified रिस्पॉन्स बिना किसी कंटेंट के वापस कर सकता है यदि रिस्पॉन्स में कोई बदलाव नहीं हैं। सर्वर-गणना Etag की तुलना उस हेडर के अंदर के मान से की जाती है।
इसी तरह, यदि If-None-Match के बिना If-Modified-Since हेडर मौजूद है, तो सर्वर 304 Not Modified रिस्पॉन्स बिना किसी कंटेंट के वापस कर सकता है (जब तक कि रिस्पॉन्स उस तारीख के बाद नहीं बदला है)।
रेल्स कंट्रोलर एक्शन्स के अंदर इसे करने के आसान तरीके प्रदान करता है। आप बस लिख सकते हैं:
रेल्स कैशिंग का समर्थन करने के लिए सभी आवश्यक हेडर्स भेजेगा, इनकमिंग हेडर्स को संभालेगा, और जब डेटा नहीं बदला है तो 304 के साथ प्रतिक्रिया देगा। सर्वर पूर्ण व्यूज़ को फिर से रेंडर करने से बच सकता है जब तक कि चीजें नहीं बदलतीं। आप इस रणनीति के लिए उन्नत कॉन्फ़िगरेशन के बारे में क्लाइंट-साइड कैशिंग इन रेल्स: कंडीशनल GET रिक्वेस्ट्स में अधिक पढ़ सकते हैं।
वैल्यूज़ कैश करना
अंत में, कच्चे वैल्यूज़ (कुछ भी जिसे कैश स्टोर में सीरियलाइज़ किया जा सकता है) को कैश करना भी संभव है। यह आमतौर पर संसाधन-गहन या धीमे ऑपरेशन के परिणामों को कैश करने और उन्हें फिर से करने से बचने के लिए उपयोगी होता है।
एक वैल्यू की पहचान करना जो इस कैशिंग से लाभान्वित हो सकता है, एप्लिकेशन पर बहुत निर्भर करता है, लेकिन आमतौर पर, अपने सबसे धीमे इवेंट्स को देखने से आपको सही दिशा में इंगित करने में मदद मिल सकती है।
अंत में, जब आप पहचान लेते हैं कि क्या कैश करना है, तो इसके लिए रेल्स द्वारा प्रदान किया गया API उपयोग करने में बहुत सरल है:
उपरोक्त कोड perform_the_slow_computation को केवल एक बार करेगा और फिर वैल्यू को cache_key_with_version कुंजी के तहत कैश करेगा। अगली बार जब वही कोड कॉल किया जाता है, तो रेल्स पहले जांचेगा कि क्या हमारे पास पहले से एक कैश्ड वैल्यू है और perform_the_slow_computation को फिर से ट्रिगर करने के बजाय उसका उपयोग करेगा।
इस कैशिंग रणनीति का सबसे महत्वपूर्ण हिस्सा एक अच्छी कैश कुंजी की गणना करना है जो वैल्यू की गणना में उपयोग किए गए सभी इनपुट पर निर्भर करती है। यह सुनिश्चित करने के लिए है कि हम स्टेल वैल्यू का उपयोग न करते रहें।
कैश स्टोर्स
अब जब हम जानते हैं कि क्या कैश करना है और रेल्स चीजों को कैश में स्टोर करने के लिए कौन सी तकनीक प्रदान करता है, तो अगला तार्किक प्रश्न है — हम इस डेटा को कहां कैश करते हैं? रेल्स कई अंतर्निहित कैश स्टोर एडाप्टर्स के साथ आता है। उत्पादन उपयोग के मामलों के लिए सबसे लोकप्रिय कैश स्टोर्स Redis और Memcached हैं। कुछ अन्य विकल्प भी हैं — फाइल स्टोर और मेमोरी स्टोर। इन स्टोर्स की पूरी चर्चा रेल्स के बिल्ट-इन कैश स्टोर्स: एन ओवरव्यू पोस्ट में पाई जा सकती है।
फाइल और मेमोरी स्टोर विकास उपयोग के लिए चीजों को जल्दी से चालू करने के लिए बहुत अच्छे हो सकते हैं। हालांकि, वे आमतौर पर उत्पादन के लिए अनुपयुक्त होते हैं, खासकर यदि आप कई सर्वरों के साथ वितरित सेटअप में काम कर रहे हैं। Redis और memcached दोनों उत्पादन उपयोग के लिए उपयुक्त हैं। आप किसका उपयोग करते हैं यह आमतौर पर एप्लिकेशन पर निर्भर करता है।
रूबी ऑन रेल्स में बैकग्राउंड वर्कर्स
अधिकांश एप्लिकेशन को मेलर्स, नियमित क्लीन-अप, या किसी अन्य समय लेने वाले ऑपरेशन के लिए बैकग्राउंड जॉब्स की आवश्यकता होती है जिसमें उपयोगकर्ता को उपस्थित होने की आवश्यकता नहीं होती। संभावना है, आपके पास पहले से ही एक बैकग्राउंड वर्कर सेट अप है।
जब भी आप खुद को कंट्रोलर एक्शन के अंदर कुछ ऐसा करते हुए पाते हैं जिसमें एक सेकंड से अधिक समय लगता है, तो देखें कि क्या आप इसे बैकग्राउंड वर्कर में स्थानांतरित कर सकते हैं। यह एक बड़े टेबल के अंदर डेटा खोजने जैसे उपयोगकर्ता-सामना करने वाले ऑपरेशन से लेकर बड़ी मात्रा में डेटा ग्रहण करने वाले API मेथड तक हो सकता है।
उदाहरण कार्यान्वयन
कस्टम जॉब्स चलाने के लिए, रेल्स Active Job फ्रेमवर्क प्रदान करता है। आइए देखें कि हम इसका उपयोग बहुत जटिल फ़िल्टरिंग लॉजिक को बैकग्राउंड जॉब में स्थानांतरित करने के लिए कैसे कर सकते हैं। पहले, आइए अपना बैकग्राउंड जॉब बनाएं:
हम इस जॉब को कंट्रोलर से इस तरह चला सकते हैं:
हमें अपने टेम्पलेट पर एक लोडिंग इंडिकेटर रेंडर करने की आवश्यकता है जबकि हम अपने जॉब के डेटा की गणना करने और परिणाम देने की प्रतीक्षा करते हैं।
लेकिन हम अपने जॉब से व्यू तक परिणाम कैसे प्राप्त कर सकते हैं? Turbo इसे वास्तव में आसान बनाता है। उदाहरण के लिए, व्यू के अंदर, हम turbo_stream_from का उपयोग करके एक विशिष्ट नोटिफिकेशन चैनल पर टर्बो-स्ट्रीम इवेंट्स की सदस्यता ले सकते हैं।
इसका उपयोग करके, आइए अपने टेम्पलेट लिखें:
चूंकि डेटा प्रारंभिक कंट्रोलर एक्शन में परिभाषित नहीं है, हम केवल एक लोडिंग इंडिकेटर रेंडर करेंगे। आइए अब अपने जॉब से परिणाम डिलीवर करें:
यहां महत्वपूर्ण हिस्सा notify_completed मेथड है। यह Turbo::StreamsChannel का उपयोग करता है, [user, :huge_datasets] नोटिफिकेशन स्ट्रीम पर एक रिप्लेस इवेंट प्रसारित करता है जिसे हमने अपने व्यू से सब्सक्राइब किया था।
यही वह सब कुछ है जो हमें अपने कंट्रोलर से बैकग्राउंड जॉब्स में जटिल ऑपरेशन्स को स्थानांतरित करने के लिए चाहिए। बैकग्राउंड में कार्यों को स्थानांतरित करने का मुख्य लाभ यह है कि बैकग्राउंड वर्कर्स को वेब सर्वर्स से स्वतंत्र रूप से स्केल किया जा सकता है। यह वेब सर्वर साइड पर संसाधनों को काफी मुक्त करता है। उपयोगकर्ता के लिए, ऐसे इंटरफेस भी बहुत अधिक रिस्पॉन्सिव महसूस होते हैं क्योंकि हम जल्दी प्रतिक्रिया दे सकते हैं और परिणाम इंक्रीमेंटली डिलीवर कर सकते हैं।
नोट: यदि आपको बैकग्राउंड जॉब वर्कर के बीच निर्णय लेने में सहायता की आवश्यकता है, तो Delayed Job vs. Sidekiq: Which Is Better? पढ़ें।
अपने रूबी ऑन रेल्स एप्लिकेशन में डेटाबेस स्केल करना
आखिरी स्केलेबल संसाधन जिस पर हम इस पोस्ट में चर्चा करेंगे वह है डेटाबेस। डेटाबेस अधिकांश एप्लिकेशन का मूल बनाते हैं। जैसे-जैसे डेटा और उस डेटा तक पहुंचने वाले सर्वरों की संख्या बढ़ती है, डेटाबेस लोड महसूस करने लगते हैं।
डेटाबेस को स्केल करने का सबसे आसान तरीका डेटाबेस सर्वर में अधिक प्रोसेसिंग पावर और मेमोरी जोड़ना है। वेब सर्वर्स को स्केल करने के विपरीत, डेटाबेस के साथ ऐसा करना आमतौर पर बहुत धीमा ऑपरेशन होता है, खासकर यदि आपके पास उच्च स्टोरेज है।
डेटाबेस को स्केल करने का दूसरा विकल्प कई डेटाबेस का उपयोग करके या अपने डेटाबेस को शार्ड करके क्षैतिज रूप से स्केल करना है। अधिक जानकारी के लिए Active Record के साथ मल्टीपल डेटाबेस देखें।
इसके बजाय, हम PostgreSQL को देखकर अपने डेटाबेस के प्रदर्शन को अनुकूलित करने पर ध्यान केंद्रित करेंगे।
PostgreSQL में समय लेने वाले क्वेरीज़ खोजें
पहले, हमें अपने सबसे अधिक समय लेने वाले क्वेरीज़ की पहचान करने की आवश्यकता है। हम इसे pg_stat_statements टेबल को क्वेरी करके कर सकते हैं जिसमें सर्वर पर निष्पादित सभी SQL स्टेटमेंट्स के बारे में आंकड़े होते हैं। आइए देखें कि हम उच्चतम रन टाइम वाले टॉप 100 क्वेरीज़ कैसे ढूंढ सकते हैं:
यह क्वेरी, कॉल की संख्या, और इन क्वेरीज़ के औसत रन टाइम को वापस करेगा। उन लोगों को खोजने का प्रयास करें जिन्हें आप तेज़ कर सकते हैं और विश्लेषण करें कि वे धीमे क्यों थे।
आप क्वेरी पर EXPLAIN या EXPLAIN ANALYZE भी चला सकते हैं ताकि क्वेरी प्लान और वास्तविक निष्पादन विवरण क्रमशः देख सकें।
परिणामों में देखने के लिए सबसे महत्वपूर्ण चीजों में से एक Seq Scan है, जो इंगित करता है कि Postgres को क्वेरी चलाने के लिए सभी रिकॉर्ड्स को क्रमिक रूप से पार करना होगा। यदि ऐसा होता है, तो उन कॉलम्स पर इंडेक्स जोड़कर उस क्रमिक स्कैन को बायपास करने का प्रयास करें जिन पर आपने फ़िल्टर किया है।
सबसे अधिक क्रमिक स्कैन वाली टेबल्स
एक और उपयोगी क्वेरी जिसे मैं चलाना पसंद करता हूं वह है एक टेबल के खिलाफ चलाए गए क्रमिक स्कैन की कुल संख्या ढूंढना:
यदि आप एक बहुत बड़ी टेबल (उच्च पंक्तियों की संख्या के साथ) और इस परिणाम से उच्च काउंट वैल्यू देखते हैं, तो आपको समस्या है। उस टेबल के खिलाफ सभी क्वेरीज़ की जांच करें, उन लोगों को ढूंढें जो क्रमिक स्कैन चला सकते हैं, और इंडेक्स जोड़कर इसे कम करें।
इंडेक्स उपयोग
आप इस क्वेरी को चलाकर इंडेक्स उपयोग के बारे में आंकड़े भी ढूंढ सकते हैं:
यह प्रत्येक टेबल के लिए इंडेक्स उपयोग का प्रतिशत लौटाता है। एक कम संख्या का मतलब है कि आप उस टेबल पर कुछ इंडेक्स खो रहे हैं।
समापन
इस पोस्ट में, हमने आपके रूबी ऑन रेल्स एप्लिकेशन को स्केल करने की कई रणनीतियों का पता लगाया, जिसमें कैशिंग और बैकग्राउंड वर्कर्स शामिल हैं। हमने आपके PostgreSQL डेटाबेस के प्रदर्शन को अनुकूलित करने पर भी ध्यान दिया।
रेल्स आपके एप्लिकेशन में प्रदर्शन अनुकूलन की कई परतों को जोड़ना वास्तव में आसान बनाता है।
स्केलेबिलिटी के साथ सबसे महत्वपूर्ण विचार यह है कि हम उन पर कार्य करने से पहले एप्लिकेशन में बॉटलनेक्स की पहचान करें। एक अच्छा प्रदर्शन निगरानी टूल मदद कर सकता है। यदि आपको एक की आवश्यकता है, तो रूबी के लिए AppSignal देखें।
हैप्पी कोडिंग!
P.S. यदि आप रूबी मैजिक पोस्ट को प्रेस से बाहर आते ही पढ़ना चाहते हैं, तो हमारे रूबी मैजिक न्यूज़लेटर की सदस्यता लें और कभी भी एक भी पोस्ट मिस न करें!