बैकग्राउंड टास्क वेब एप्लिकेशन को स्केल के लिए मानते समय मुख्य स्तंभों में से एक हैं। मूल विचार सरल है: एक क्लाइंट आपके वेब एप्लिकेशन पर एक अनुरोध करता है और उस अनुरोध को संभालने में, आपका ऐप कई समय-खर्चीले कार्य करता है। क्लाइंट को तेजी से प्रतिक्रिया देने की अनुमति देने के लिए, ऐप एक बैकग्राउंड जॉब को बैकग्राउंड प्रोसेसिंग सिस्टम में एनक्यू करता है। बैकग्राउंड प्रोसेसिंग को फिर सभी भारी काम सौंपे जाते हैं, जैसे गणना या I/O ऑपरेशन। बैकग्राउंड जॉब्स पर प्रभावी ढंग से भरोसा करना आपके वेब एप्लिकेशन को स्केल करते समय सबसे महत्वपूर्ण बिल्डिंग ब्लॉक्स में से एक है।
रेल्स डेवलपर्स के रूप में, हम कई शानदार लाइब्रेरीज से चुनने के लिए धन्य हैं, सभी अलग-अलग फायदे, नुकसान, और यहां तक कि बैकएंड डेटाबेस के साथ। ये लाइब्रेरीज किसी भी भारी काम को ऑफलोड करना आसान बनाती हैं, जिससे हमारे एप्लिकेशन तेजी से प्रतिक्रिया दे सकते हैं और कम संसाधनों के साथ अधिक उपयोगकर्ताओं की सेवा कर सकते हैं।
हाल तक, हम हनीबैजर के अधिकांश बैकग्राउंड प्रोसेसिंग जॉब्स को करने के लिए Sidekiq का उपयोग करते थे। इसने हमें एक तेज़ उपयोगकर्ता अनुभव और हमारे द्वारा निगले जाने वाले भारी मात्रा में डेटा को प्रोसेस करने के लिए एक मजबूत पाइपलाइन बनाए रखने में सहायक भूमिका निभाई है।
Sidekiq हमारे लिए कहां कम पड़ता है?
इसकी विश्वसनीयता के बावजूद, Redis की कुछ सीमाएं हैं। हाल तक, हमने अपने सभी जॉब प्रोसेसिंग के लिए Sidekiq का उपयोग किया, जिसमें हमारे एरर-ट्रैकिंग एंडपॉइंट्स के लिए इंजेस्ट को संभालना शामिल है। एरर ट्रैफिक अत्यधिक परिवर्तनशील है। हम अक्सर अपनी कतारों में जॉब्स की संख्या को 10x या 20x कर देते थे — जिसके परिणामस्वरूप बड़े बैकलॉग होते थे जब तक कि हमारा ऑटोस्केलिंग पकड़ने के लिए पर्याप्त वर्कर्स को स्पिन नहीं कर लेता। लेकिन बड़ी समस्या हमारे ElastiCache क्लस्टर में मेमोरी एग्जॉशन थी।
हमारे ElastiCache क्लस्टर के माध्यम से पर्याप्त जॉब ट्रैफिक जा रहा था कि डाउनस्ट्रीम प्रोसेसिंग में कोई भी महत्वपूर्ण देरी क्लस्टर को मेमोरी से बाहर निकलने का जोखिम देगी। जबकि हम नॉन-क्यू डेटा को स्टोर करने के लिए एक अलग क्लस्टर का उपयोग करते हैं, समय के साथ, हमारे प्राथमिक क्लस्टर में भी कुछ नॉन-क्यू डेटा दिखाई दिया, जो आउट-ऑफ-मेमोरी त्रुटियों के मामले में बेदखल हो सकता था। अधिक महत्वपूर्ण मुद्दा, हालांकि, क्लस्टर के मेमोरी से बाहर निकलने पर नई जॉब्स को स्वीकार न कर पाना था।
एक द्वितीयक मुद्दा यह है कि Redis/ElastiCache डिफ़ॉल्ट रूप से volatile-lru निष्कासन नीति का उपयोग करता है। इसका परिणाम यह है कि उच्च मेमोरी उपयोग के समय, Redis TTL सेट के साथ सबसे कम हाल ही में उपयोग किए गए डेटा को हटा देगा। एक बिंदु पर, हनीबैजर की एक घटना थी जहां हमारा मेमोरी उपयोग इतना अधिक था कि Redis ने अपना कैश साफ करना शुरू कर दिया जब हमारा इरादा नहीं था। सौभाग्य से, बेदखल डेटा पुनरुत्पादन योग्य था (इसलिए TTL), इसलिए हमने कोई स्थायी डेटा नहीं खोया।
फिर भी, इसने हमें एक प्रश्न के साथ छोड़ दिया जिसे संबोधित करने की आवश्यकता थी - क्या होता है अगर एक समान घटना होती है और हम उस डेटा को खोना शुरू कर देते हैं जिसे हम पुनर्निर्माण नहीं कर सकते? हम यह कैसे सुनिश्चित कर सकते हैं कि हम कभी ग्राहक डेटा न खोएं? ग्राहक त्रुटि डेटा को संभालना हमारे व्यवसाय का मूल है, इसलिए हमें एक ऐसी प्रणाली की आवश्यकता है जो डेटा हानि के प्रति लचीला हो।
डेटा इंजेस्ट करने के लिए Kafka का उपयोग करना
Kafka एक वितरित इवेंट पाइपलाइन है जो स्केलेबिलिटी और लचीलापन दोनों प्रदान करता है। Insights के हमारे हालिया लॉन्च के साथ, हमने अपने इवेंट डेटा को प्रोसेस करने के लिए इंफ्रास्ट्रक्चर के रूप में Kafka को खड़ा करने का बहुत अनुभव प्राप्त किया। उसके बाद, हम उसी टेक्नोलॉजी स्टैक का उपयोग अपने एरर इंजेस्ट डेटा को प्रोसेस करने के लिए करना चाहते थे। हम Kafka का उपयोग करके रिडंडेंट स्टोरेज, बेहतर विस्तारशीलता, और अधिक किफायती लागत प्राप्त करना चाहते थे।
चूंकि हम Insights के लिए अपना खुद का AWS MSK क्लस्टर चला रहे थे, इसलिए हमारे पास पहले से ही इंफ्रास्ट्रक्चर और ऑटोस्केलिंग सेटअप था। इसका मतलब था कि हमें "बस" कुछ टॉपिक्स सेट करने थे और कुछ कंज्यूमर्स बनाने थे जो हमारे Sidekiq वर्कर्स के समान कोड चलाते थे। अवधारणा काफी सरल थी जिसने हमें अपने Kafka कंज्यूमर्स की फाइन-ट्यूनिंग पर अधिक ध्यान केंद्रित करने दिया।
Sidekiq से Karafka में माइग्रेट करना
हनीबैजर एक राजसी मोनोलिथ के रूप में आर्किटेक्टेड है, और Karafka हमें उसी आर्किटेक्चर को बनाए रखने में मदद करता है। हम पहले से ही अपने कुछ Insights डेटा को प्रोसेस करने के लिए Karafka का उपयोग कर रहे थे, इसलिए कुछ नए कंज्यूमर्स जोड़ना एक सरल कार्य था।
Karafka और Sidekiq के बीच मुख्य अंतरों में से एक यह है कि जॉब्स कैसे प्राप्त किए जाते हैं। Karafka के साथ, जॉब्स को बैच किया जाता है और एक सिंगल कंज्यूमर रन में एक साथ प्रोसेस किया जाता है। कंज्यूमर में, हम मैसेजेस की सरणी पर पुनरावृति कर सकते हैं और Sidekiq वर्कर को इंलाइन चला सकते हैं:
class NoticeConsumer < ApplicationConsumer
  def consume
    messages.each do |message|
      NoticeWorker.new.perform(message.payload)
    end
  end
end
एक और अंतर जिस पर हमें विचार करना था, वह यह है कि त्रुटि प्रबंधन कैसे काम करता है। Sidekiq के साथ, चूंकि प्रत्येक जॉब परमाणु है, एक वर्कर रीट्राइ और फेल्योर कॉलबैक के माध्यम से अपनी त्रुटि को संभालता है। Kafka के बैचिंग व्यवहार के साथ, त्रुटियों को संभालने के लिए अधिक विकल्प हैं। सबसे विशेष रूप से, Karafka एक तंत्र प्रदान करता है जिसे डेड लेटर क्यू कहा जाता है। यह आपको बैच या व्यक्तिगत आधार पर त्रुटि प्रबंधन निर्दिष्ट करने की अनुमति देता है।
dead_letter_queue(
  topic: "ingestion.errors.dead",
  max_retries: 5,
  independent: true
)
जब भी Karafka कंज्यूमर किसी व्यक्तिगत मैसेज को प्रोसेस करने में विफल होता है, तो यह 5 बार पुनर्प्रयास करेगा। यदि यह 5वें प्रयास में विफल होता है, तो मैसेज को निर्दिष्ट टॉपिक पर भेजा जाएगा। independent: true विकल्प कंज्यूमर को बताता है कि केवल विफल मैसेज को DLQ पर भेजा जाना चाहिए न कि पूरे बैच को।
Karafka की निगरानी और स्केलिंग
जैसा कि यह पता चला है, Karafka कंज्यूमर्स की निगरानी और स्केलिंग काफी जटिल है। AWS/MSK और Karafka दोनों से कई चीजें हैं जिन्हें आप ट्रैक कर सकते हैं, और आपके सिस्टम को ट्यून करने के लिए कई नॉब्स हैं। इसके लिए आपके कोड क्या कर रहा है, डेटा फ्लो के व्यवहार पर सावधानीपूर्वक ध्यान देने की आवश्यकता है।
AWS CloudWatch के साथ हम बहुत सी चीजों की निगरानी करते हैं, लेकिन यहां कुछ Kafka-विशिष्ट मेट्रिक्स हैं जिन्हें हम देखते हैं:
- SumOffsetLag — एक निर्दिष्ट टॉपिक और कंज्यूमर ग्रुप के लिए, यह सभी पार्टीशन में सभी ऑफसेट लैग का योग है।
- EstimatedMaxTimeLag — एक निर्दिष्ट टॉपिक और कंज्यूमर ग्रुप के लिए, यह अनुमानित समय है जो वर्तमान ऑफसेट तक सभी पार्टीशन पर पकड़ने में लगेगा।
Karafka कुछ बेहतरीन इंस्ट्रूमेंटेशन भी प्रदान करता है, लेकिन आपको इस डेटा को स्वयं प्रकाशित और संग्रहीत करना होगा:
- processing_lag* — यह मान खपत किए गए मैसेजेस के हर बैच के लिए उपलब्ध है। यह आपको बताता है कि Kafkas को मैसेज लेने और इसे प्रोसेस करना शुरू करने में कितना समय लगा।
- consumption_lag* — यह मान processing_lag के समान है सिवाय इसके कि यह बैच के अंतिम मैसेज के Kafka सिस्टम में प्रवेश करने के समय से लेकर आपके कंज्यूमर द्वारा इसे प्रोसेस करना शुरू करने तक का समय है।
- duration* — यह एक कंज्यूमर द्वारा मैसेजेस के पूरे बैच को प्रोसेस करने में लगने वाला समय है।
जैसा कि यह पता चला है, Sidekiq प्रोसेस को स्केल करना Karafka कंज्यूमर प्रोसेस को स्केल करने से बहुत अलग है। Sidekiq के समानांतरीकरण को बढ़ाते समय, आप अपने Redis इंस्टेंस जितने अधिक प्रोसेस जोड़ सकते हैं। Kafka के साथ, आप अपने टॉपिक में प्रति पार्टीशन अधिकतम 1 प्रोसेस रखने के लिए बाध्य हैं। एक सामान्य नियम के रूप में, आप योजना से अधिक पार्टीशन रखना चाहेंगे क्योंकि एक Kafka कंज्यूमर को 1 से अधिक पार्टीशन को असाइन किया जा सकता है।
याद रखने वाली एक और बात यह है कि Kafka कंज्यूमर्स को स्केल अप और स्केल डाउन करना एक बहुत लंबा ऑपरेशन हो सकता है। एक कंज्यूमर ग्रुप में कंज्यूमर्स को जोड़ने और हटाने के लिए ग्रुप को खुद को रीबैलेंस करने की आवश्यकता होती है। इसका मतलब है आवश्यकतानुसार पार्टीशन को पुनः असाइन करना। पुनः असाइनमेंट के दौरान, कंज्यूमर्स मैसेज प्रोसेस करना बंद कर देते हैं। यद्यपि आप sticky-cooperative असाइनमेंट के साथ इस मुद्दे को कुछ हद तक कम कर सकते हैं, आप आम तौर पर संसाधनों को ओवर-प्रोविजन करके रीबैलेंसिंग से बचना चाहते हैं।
हम वर्तमान में अपने स्केलिंग मेट्रिक्स में से एक के रूप में SumOffsetLag की निगरानी कर रहे हैं। ध्यान देने वाली एक महत्वपूर्ण बात यह है कि रीबैलेंसिंग के दौरान, यह मेट्रिक रिपोर्ट नहीं की जाती है। इसलिए जैसा कि आप कल्पना कर सकते हैं, रीबैलेंसिंग अवधि के दौरान, यह मेट्रिक तब तक नाटकीय रूप से बढ़ेगी जब तक रीबैलेंसिंग समाप्त नहीं हो जाती। यह एक और कारण है कि स्केलिंग को न्यूनतम रखना महत्वपूर्ण है।
हनीबैजर में Karafka के लिए आगे क्या है?
हम अपने Kafka/Karafka कार्यान्वयन को एक महीने से अधिक समय से 100% पर चला रहे हैं और यह कहना सुरक्षित है कि हम काफी संतुष्ट हैं। फिर भी, यह जानना बहुत अच्छा है कि अगर हमें कभी आवश्यकता हुई तो हम एक बटन के धक्का पर Sidekiq पर वापस जा सकते हैं। यह हमें इनमें से किसी भी सिस्टम पर रखरखाव कार्य की आवश्यकता होने पर और भी अधिक लचीलापन देता है।
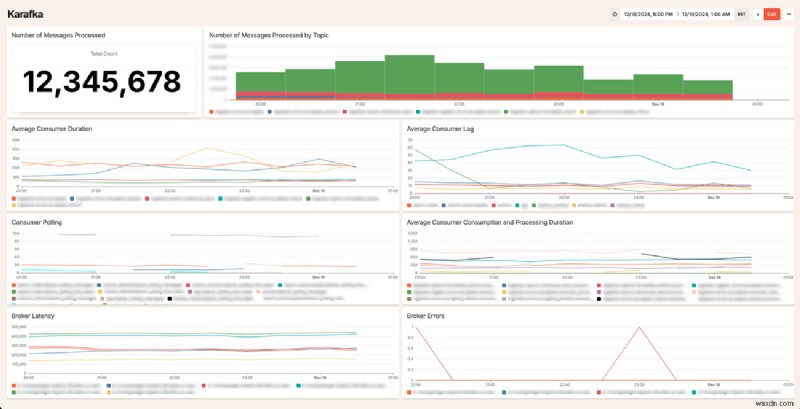
Sidekiq से Karafka में माइग्रेट करने की प्रक्रिया में, हमने Kafka और Karafka के साथ काम करने के बारे में बहुत कुछ सीखा। यदि आपने हनीबैजर जेम के नवीनतम संस्करण में अपडेट नहीं किया है, तो आपको इसे देखना चाहिए! मैंने Karafka प्लगइन में कुछ नई सुविधाएं जोड़ीं। जब आपके पास Insights सक्षम है, तो हमारा जेम आपके Kafka सिस्टम के समग्र स्वास्थ्य पर बेहतर दृश्य देने के लिए कुछ महत्वपूर्ण आँकड़ों को ट्रैक करना शुरू कर देगा।
इसके अलावा, हमारे पास अब एक Insights Karafka डैशबोर्ड है जो आपको इस डेटा को विज़ुअलाइज़ करने और यह समझने में मदद करता है कि आपके Kafka कंज्यूमर कैसे व्यवहार कर रहे हैं। Karafka डैशबोर्ड के लिए प्लगइन के लिए मेट्रिक्स सक्षम होना आवश्यक है। ऐसा करने के लिए अपने honeybadger.yml में निम्नलिखित कॉन्फ़िगरेशन जोड़ें:
karafka:
  insights:
    metrics: true
यहां डैशबोर्ड कैसा दिखता है इसका एक नमूना है:
हम यह देखने के लिए उत्साहित हैं कि हमारे ग्राहक अपने Kafka सिस्टम को बेहतर बनाने के लिए इस डेटा का उपयोग कैसे करते हैं। यदि आपके पास Sidekiq से Karafka में हमारे माइग्रेशन के बारे में, या हम आम तौर पर Kafka का उपयोग कैसे करते हैं, इसके बारे में कोई प्रश्न हैं, तो बेझिझक संपर्क करें!