एक प्रीफिक्स ट्री (जिसे ट्राई भी कहा जाता है) एक डेटा संरचना है जो आपको शब्द सूची को व्यवस्थित करने और विशिष्ट प्रीफिक्स से शुरू होने वाले शब्दों को जल्दी से ढूंढने में मदद करती है।
उदाहरण के लिए, आप अपने डिक्शनरी में उन सभी शब्दों को ढूंढ सकते हैं जो "ca" अक्षरों से शुरू होते हैं, जैसे "cat" या "cape"।
इस चित्र को देखें:
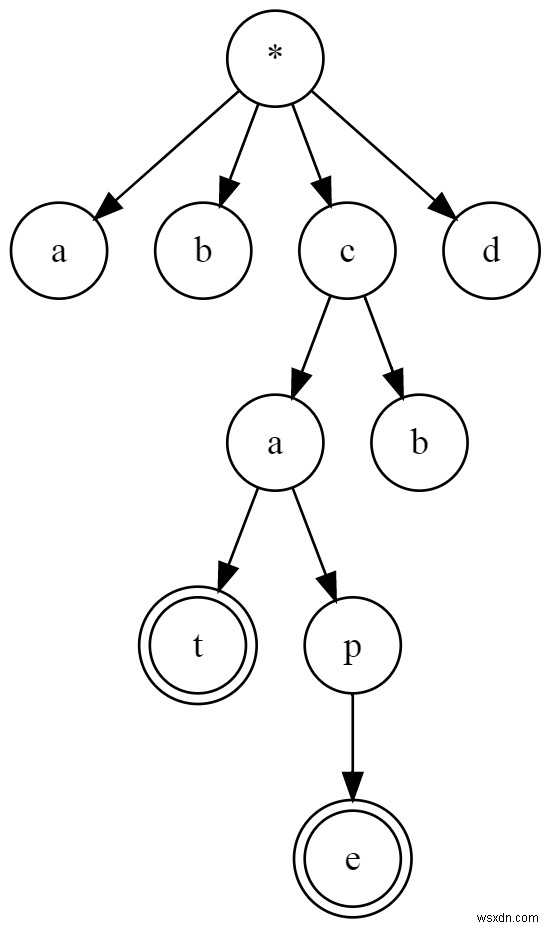
यह एक प्रीफिक्स ट्री है।
आप रूट (*) से एक चिह्नित नोड (जैसे e और t) तक जा सकते हैं ताकि शब्द मिल सकें।
इस लेख में आप सीखेंगे कि रूबी में अपना खुद का प्रीफिक्स ट्री कैसे कार्यान्वित करें और समस्याओं को हल करने के लिए इसका उपयोग कैसे करें!
प्रीफिक्स ट्री कार्यान्वयन
इसे रूबी में कार्यान्वित करने के लिए मैंने कुछ विशेषताओं के साथ एक Node क्लास का उपयोग करने का निर्णय लिया:
- मान (एक वर्ण)
- "शब्द" वेरिएबल। एक true/false मान जो बताता है कि यह एक वैध शब्द है या नहीं
- "अगला" सरणी। यह उन सभी वर्णों को संग्रहीत करता है (जो
Nodeऑब्जेक्ट्स के रूप में हैं) जो इस ट्री में इसके बाद आते हैं
यहाँ कोड है:
class Node attr_reader :value, :next attr_accessor :word def initialize(value) @value = value @word = false @next = [] end end
अब हमें रूट नोड और इन नोड्स के साथ काम करने के मेथड्स को रखने के लिए एक क्लास की आवश्यकता है।
आइए Trie क्लास को देखें:
class Trie def initialize @root = Node.new("*") end end इस क्लास के अंदर हमारे पास निम्नलिखित मेथड्स हैं:
def add_word(word) letters = word.chars base = @root letters.each { |letter| base = add_character(letter, base.next) } base.word = true end def find_word(word) letters = word.chars base = @root word_found = letters.all? { |letter| base = find_character(letter, base.next) } yield word_found, base if block_given? base end दोनों मेथड्स दिए गए शब्द को वर्णों की एक सरणी में तोड़ते हैं (chars मेथड का उपयोग करके)।
फिर हम रूट से शुरू करके ट्री को नेविगेट करते हैं और या तो एक वर्ण ढूंढते हैं या उसे जोड़ते हैं।
यहाँ सहायक मेथड्स हैं (भी Trie क्लास के अंदर):
def add_character(character, trie) trie.find { |n| n.value == character } || add_node(character, trie) end def find_character(character, trie) trie.find { |n| n.value == character } end def add_node(character, trie) Node.new(character).tap { |new_node| trie << new_node } end एक वर्ण जोड़ने के लिए हम जांचते हैं कि क्या यह पहले से मौजूद है (find मेथड का उपयोग करके)। यदि हां तो हम नोड लौटाते हैं।
अन्यथा हम इसे बनाते हैं और नया नोड लौटाते हैं।
फिर हमारे पास include? मेथड भी है:
def include?(word) find_word(word) { |found, base| return found && base.word } end अब हम अपनी नई डेटा संरचना का उपयोग शुरू करने के लिए तैयार हैं और देखते हैं कि हम इसके साथ क्या कर सकते हैं 🙂
ट्राई के उपयोग और उदाहरण
आइए अपने ट्री में कुछ शब्द जोड़कर शुरू करें:
trie = Trie.new trie.add_word("cat") trie.add_word("cap") trie.add_word("cape") trie.add_word("camp") आप इस तरह जांच सकते हैं कि कोई शब्द ट्री में शामिल है या नहीं:
p trie.include?("cape") # true p trie.include?("ca") # false इस डेटा संरचना के कुछ उपयोग क्या हैं?
- शब्द खेल हल करना
- स्पेल चेकिंग
- ऑटोकंप्लीट
आपको अपने ट्री में लोड करने के लिए एक अच्छा डिक्शनरी चाहिए।
मुझे ये मिले जो आपके लिए उपयोगी हो सकते हैं:
- https://raw.githubusercontent.com/first20hours/google-10000-english/master/20k.txt
- https://raw.githubusercontent.com/dwyl/english-words/master/words_alpha.txt
प्रीफिक्स वाले शब्द ढूंढना
तो पहले दिखाए गए कोड उदाहरण में हमने add और find ऑपरेशन लागू किए हैं।
लेकिन हम एक find_words_starting_with मेथड भी चाहते हैं।
हम इसे "डेप्थ फर्स्ट सर्च" (DFS) एल्गोरिथम का उपयोग करके कर सकते हैं। हमें उस शब्द को ट्रैक करने का एक तरीका भी चाहिए जिसे हम देख रहे हैं।
याद रखें कि हमारे नोड्स में प्रत्येक में केवल एक वर्ण होता है, इसलिए हमें ट्री पर चलकर वास्तविक स्ट्रिंग्स को पुनर्निर्मित करने की आवश्यकता है।
यहाँ एक मेथड है जो यह सब करता है:
def find_words_starting_with(prefix) stack = [] words = [] prefix_stack = [] stack << find_word(prefix) prefix_stack << prefix.chars.take(prefix.size-1) return [] unless stack.first until stack.empty? node = stack.pop prefix_stack.pop and next if node == :guard_node prefix_stack << node.value stack << :guard_node words << prefix_stack.join if node.word node.next.each { |n| stack << n } end words end हम यहां दो स्टैक्स का उपयोग करते हैं, एक अनविज़िटेड नोड्स को ट्रैक करने के लिए (stack) और दूसरा वर्तमान स्ट्रिंग को ट्रैक करने के लिए (prefix_stack)।
हम तब तक लूप करते हैं जब तक हम सभी नोड्स को विज़िट नहीं कर लेते और नोड के मान को prefix_stack में जोड़ते हैं। प्रत्येक नोड केवल एक वर्ण का मान रखता है, इसलिए हमें एक शब्द बनाने के लिए इन वर्णों को इकट्ठा करने की आवश्यकता है।
:guard_node सिम्बल को prefix_stack में जोड़ा जाता है ताकि हमें पता चले कि हम कब बैकट्रैकिंग कर रहे हैं। हमें इसकी आवश्यकता है ताकि हम अपने स्ट्रिंग बफर (prefix_stack) से सही समय पर वर्णों को हटा सकें।
फिर यदि node.word true है तो इसका मतलब है कि हमें एक पूरा शब्द मिल गया और हम इसे अपनी शब्द सूची में जोड़ते हैं।
इस मेथड का उपयोग करने का उदाहरण:
t.find_words_starting_with("cap") # ["cap", "cape"] यदि कोई शब्द नहीं मिलता है तो आपको एक खाली सरणी मिलेगी:
t.find_words_starting_with("b") # [] इस मेथड का उपयोग ऑटोकंप्लीट फीचर को लागू करने के लिए किया जा सकता है।
सारांश
आपने प्रीफिक्स ट्रीज़ (जिन्हें ट्राईज़ भी कहा जाता है) के बारे में सीखा, एक डेटा संरचना जिसका उपयोग शब्दों की सूची को ट्री में व्यवस्थित करने के लिए किया जाता है। आप इस ट्री को जल्दी से क्वेरी कर सकते हैं ताकि यह जांच सकें कि कोई शब्द वैध है या नहीं और उन शब्दों को ढूंढ सकें जो समान प्रीफिक्स साझा करते हैं।
इस पोस्ट को शेयर करना न भूलें ताकि अधिक लोग सीख सकें!