हमारे द्वारा किए जाने वाले कई विकल्प संख्यात्मक संबंधों के इर्द-गिर्द घूमते हैं।
- हम कुछ खाद्य पदार्थ खाते हैं क्योंकि विज्ञान कहता है कि वे हमारे कोलेस्ट्रॉल को कम करते हैं
- हम अपनी शिक्षा आगे बढ़ाते हैं क्योंकि हमारे वेतन में वृद्धि होने की संभावना है
- हम उस पड़ोस में एक घर खरीदते हैं जिसका हमें विश्वास है कि मूल्य में सबसे अधिक सराहना होगी
हम इन निष्कर्षों पर कैसे पहुंचते हैं? सबसे अधिक संभावना है, किसी ने बड़ी मात्रा में डेटा एकत्र किया और इसका उपयोग निष्कर्ष बनाने के लिए किया। एक सामान्य तकनीक लीनियर रिग्रेशन है, जो सुपरवाइज़्ड लर्निंग का एक रूप है। सुपरवाइज़्ड लर्निंग और इसके लिए अक्सर उपयोग किए जाने वाले उदाहरणों के बारे में अधिक जानकारी के लिए, इस श्रृंखला के भाग 1 को देखें।
लीनियर संबंध
जब दो मान — उन्हें x और y कहें — का एक लीनियर संबंध होता है, तो इसका मतलब है कि x को 1 से बदलने से y हमेशा एक निश्चित मात्रा से बदल जाएगा। उदाहरण देना आसान है:
- 10 पिज्जा एक पिज्जा की कीमत का 10x खर्च करते हैं।
- 10-फुट ऊंची दीवार को 5-फुट दीवार की तुलना में दोगुने पेंट की आवश्यकता होती है
गणितीय रूप से, इस तरह के संबंध को एक रेखा के समीकरण का उपयोग करके वर्णित किया जाता है:
y = mx + b
गणित भयानक रूप से भ्रमित करने वाला हो सकता है, लेकिन अक्सर यह मुझे जादू की तरह लगता है। जब मैंने पहली बार एक रेखा का समीकरण सीखा, तो मुझे याद है कि यह सोचकर कितना सुंदर था कि केवल एक सूत्र के साथ दूरी, ढलान, और एक रेखा पर अन्य बिंदुओं की गणना करना संभव था।
लेकिन आप यह सूत्र कैसे प्राप्त करते हैं, यदि आपके पास केवल डेटा पॉइंट्स हैं? उत्तर लीनियर रिग्रेशन है — एक बहुत लोकप्रिय मशीन लर्निंग टूल।
लीनियर रिग्रेशन का एक उदाहरण
इस पोस्ट में, हम यह पता लगाने जा रहे हैं कि क्या किसी गाने में बीट्स प्रति मिनट (BPM) स्पॉटिफाई पर इसकी लोकप्रियता की भविष्यवाणी करता है।
लीनियर रिग्रेशन दो चरों के बीच संबंध को मॉडल करता है। एक को "व्याख्यात्मक चर" कहा जाता है और दूसरे को "निर्भर चर" कहा जाता है।
हमारे उदाहरण में, हम देखना चाहते हैं कि क्या BPM लोकप्रियता को "बता सकता है"। इसलिए BPM हमारा व्याख्यात्मक चर होगा। यह लोकप्रियता को निर्भर चर बनाता है।
मॉडल बेस्ट फिटिंग लाइन को खोजने के लिए लीस्ट-स्क्वेयर्स रिग्रेशन का उपयोग करेगा, आपने सही अनुमान लगाया, y = mx + b के रूप का।
हालांकि कई व्याख्यात्मक चर हो सकते हैं, इस उदाहरण के लिए हम सरल लीनियर रिग्रेशन करेंगे जहां केवल एक है।
लीस्ट-स्क्वेयर्स क्या?
लीनियर रिग्रेशन करने के कई तरीके हैं। उनमें से एक को "लीस्ट-स्क्वेयर्स" कहा जाता है। यह प्रत्येक डेटा पॉइंट से रेखा तक लंबवत विचलन के वर्गों के योग को न्यूनतम करके बेस्ट फिटिंग लाइन की गणना करता है।
मुझे पता है कि यह भ्रमित करने वाला लगता है, लेकिन यह मूल रूप से सिर्फ कह रहा है, "मुझे एक रेखा बनाओ जो उक्त रेखा और डेटा पॉइंट्स के बीच की जगह की मात्रा को न्यूनतम करे।"
वर्ग और योग करने का कारण यह है कि सकारात्मक और नकारात्मक मूल्यों के बीच कोई कैंसिलेशन न हो।
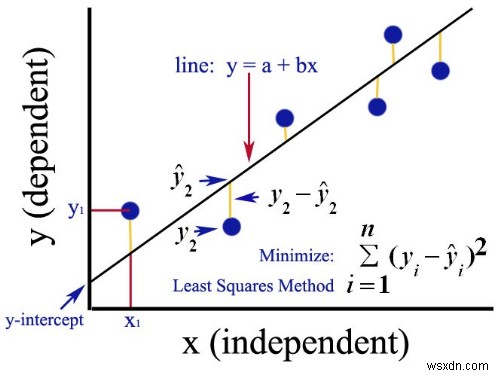
यहाँ क्वोरा पर मिली एक छवि है जो इसे समझाने का काफी अच्छा काम करती है।
डेटासेट
हम कागल से इस डेटासेट का उपयोग करेंगे: https://www.kaggle.com/leonardopena/top50spotify2019 आप इसे CSV के रूप में डाउनलोड कर सकते हैं।
डेटासेट में 16 कॉलम हैं; हालांकि, हमें केवल तीन की परवाह है — "ट्रैक नाम," "बीट्स प्रति मिनट," और "लोकप्रियता।" मशीन लर्निंग के सबसे महत्वपूर्ण चरणों में से एक है अपने डेटा को ठीक से फॉर्मेट करना, जिसे अक्सर "मंगिंग" कहा जाता है। आप उपरोक्त तीन कॉलम को छोड़कर सभी डेटा को हटा सकते हैं।
आपका CSV ऐसा दिखना चाहिए: 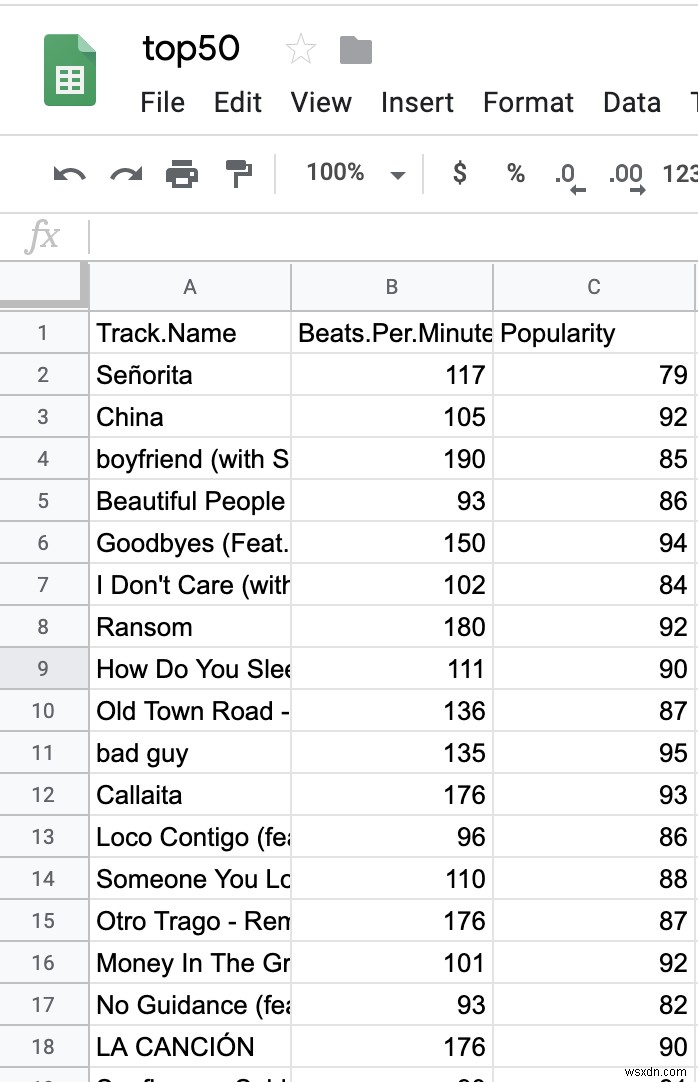
रूबी का उपयोग करके रिग्रेशन करना
इस उदाहरण में, हम ruby_linear_regression जेम का उपयोग करेंगे। इंस्टॉल करने के लिए, चलाएं:
gem install ruby_linear_regression
ठीक है, हम कोडिंग शुरू करने के लिए तैयार हैं! एक नई रूबी फाइल बनाएं और ये requires जोड़ें:
require "ruby_linear_regression"
require "csv"
अगला, हम अपना CSV डेटा पढ़ते हैं और हेडर पंक्ति को त्यागने के लिए #shift कॉल करते हैं। वैकल्पिक रूप से, आप CSV फाइल से पहली पंक्ति को हटा सकते हैं।
csv = CSV.read("top50.csv")
csv.shift
आइए हमारे x-डेटा पॉइंट्स और y-डेटा पॉइंट्स को रखने के लिए दो खाली सरणियाँ बनाएं।
x_data = []
y_data = []
...और हम .each मेथड का उपयोग करके पुनरावृति करते हैं ताकि Beats Per Minute डेटा को हमारे x सरणी में और Popularity डेटा को हमारे y सरणी में जोड़ सकें।
यदि आप यह देखने के लिए उत्सुक हैं कि यहां वास्तव में क्या हो रहा है, तो आप अपने
rowको या तोputsयाpके साथ लॉग करके प्रयोग कर सकते हैं। उदाहरण के लिए:puts row
csv.each do |row|
  x_data.push( [row[1].to_i] )
  y_data.push( row[2].to_i )
end
अब ruby_linear_regression जेम का उपयोग करने का समय है। हम अपने रिग्रेशन मॉडल का एक नया इंस्टेंस बनाएंगे, अपना डेटा लोड करेंगे, और अपने मॉडल को प्रशिक्षित करेंगे:
linear_regression = RubyLinearRegression.new
linear_regression.load_training_data(x_data, y_data)
linear_regression.train_normal_equation
अगला, हम मीन स्क्वेयर एरर (MSE) प्रिंट करेंगे — अवलोकित मूल्यों और अनुमानित मूल्यों के बीच अंतर का एक माप। अंतर को वर्ग किया जाता है ताकि नकारात्मक और सकारात्मक मूल्य एक-दूसरे को कैंसिल न करें। हम MSE को न्यूनतम करना चाहते हैं क्योंकि हम अपने अनुमानित और वास्तविक मूल्यों के बीच की दूरी को बड़ा नहीं चाहते हैं।
puts "Trained model with the following cost fit #{linear_regression.compute_cost}"
अंत में, आइए कंप्यूटर को हमारे मॉडल का उपयोग करके भविष्यवाणी करने दें। विशेष रूप से, 250 BPM वाले गाने की लोकप्रियता कितनी होगी? prediction_data सरणी में विभिन्न मूल्यों के साथ खेलने के लिए स्वतंत्र महसूस करें।
prediction_data = [250]
predicted_popularity = linear_regression.predict(prediction_data)
puts "Predicted popularity: #{predicted_popularity.round}"
परिणाम
आइए अपने कंसोल में प्रोग्राम चलाएं और देखें कि हमें क्या मिलता है!
➜ ~ ruby spotify_regression.rb
Trained model with the following cost fit 9.504882197447587
Predicted popularity: 91
कूल! आइए "250" को "50" में बदलें और देखें कि हमारा मॉडल क्या भविष्यवाणी करता है।
➜ ~ ruby spotify_regression.rb
Trained model with the following cost fit 9.504882197447587
Predicted popularity: 86
ऐसा प्रतीत होता है कि अधिक बीट्स प्रति मिनट वाले गाने अधिक लोकप्रिय हैं।
संपूर्ण प्रोग्राम
यहां मेरी पूरी फाइल कैसी दिखती है:
require 'csv'
require 'ruby_linear_regression'
x_data = []
y_data = []
csv = CSV.read("top50.csv")
csv.shift # CSV फाइल से डेटा को दो सरणियों में लोड करें -- एक इंडिपेंडेंट वेरिएबल्स X (x_data) के लिए और एक डिपेंडेंट वेरिएबल y (y_data) के लिए
# Row[0] = शीर्षक
# Row[1] = BPM
# Row[2] = लोकप्रियता
csv.each do |row|
  x_data.push( [row[1].to_i] )
  y_data.push( row[2].to_i )
end
# रिग्रेशन मॉडल बनाएं
linear_regression = RubyLinearRegression.new
# प्रशिक्षण डेटा लोड करें
linear_regression.load_training_data(x_data, y_data)
# सामान्य समीकरण का उपयोग करके मॉडल प्रशिक्षित करें
linear_regression.train_normal_equation
# लागत आउटपुट करें
puts "Trained model with the following cost fit #{linear_regression.compute_cost}"
# 250 BPM वाले गाने की लोकप्रियता की भविष्यवाणी करें
prediction_data = [250]
predicted_popularity = linear_regression.predict(prediction_data)
puts "Predicted popularity: #{predicted_popularity.round}"
अगले कदम
यह एक बहुत सरल उदाहरण है, लेकिन फिर भी, आपने अभी अपना पहला लीनियर रिग्रेशन चलाया है, जो मशीन लर्निंग के लिए उपयोग की जाने वाली एक प्रमुख तकनीक है। यदि आप अधिक के लिए तरस रहे हैं, तो यहां कुछ अन्य चीजें हैं जो आप आगे कर सकते हैं: - हमारे द्वारा उपयोग किए जा रहे रूबी जेम के स्रोत कोड को देखें ताकि हुड के नीचे होने वाले गणित को देखा जा सके - मूल डेटा सेट पर वापस जाएं और मॉडल में अतिरिक्त चर जोड़ने का प्रयास करें और मल्टी-वेरिएबल लीनियर रिग्रेशन चलाएं यह देखने के लिए कि क्या यह हमारे MSE को कम कर सकता है। उदाहरण के लिए, शायद "वैलेंस" (गाना कितना सकारात्मक है) भी लोकप्रियता में भूमिका निभाता है। - ग्रेडिएंट डिसेंट मॉडल आज़माएं, जिसे ruby_linear_regression जेम का उपयोग करके भी चलाया जा सकता है।