
इस पोस्ट में, हम न्यूरल नेटवर्क की मूल बातें सीखेंगे और कैसे हम उन्हें रूबी का उपयोग करके लागू कर सकते हैं! यदि आप कृत्रिम बुद्धिमत्ता और डीप लर्निंग से प्रभावित हैं लेकिन अनिश्चित हैं कि कैसे शुरू करें, तो यह पोस्ट आपके लिए है! हम प्रमुख अवधारणाओं को उजागर करने के लिए एक सरल उदाहरण के माध्यम से चलेंगे। यह बहुत संभावना नहीं है कि आप कभी भी रूबी का उपयोग करके मल्टीपल-लेयर न्यूरल नेटवर्क लिखेंगे, लेकिन सरलता और पठनीयता के लिए, यह समझने का एक शानदार तरीका है कि क्या हो रहा है। पहले, आइए एक कदम पीछे हटें और देखें कि हम यहां कैसे पहुंचे।
 फिल्म एक्स माकिना से एक स्टिल। फोटो क्रेडिट
एक्स माकिना 2014 में रिलीज़ हुई एक फिल्म थी। यदि आप शीर्षक को गूगल पर देखते हैं, तो यह फिल्म की शैली को "ड्रामा/फंतासी" के रूप में वर्गीकृत करता है। और, जब मैंने पहली बार फिल्म देखी, तो यह विज्ञान कथा की तरह लग रही थी।
लेकिन, बहुत अधिक समय तक?
यदि आप रे कुर्ज़वील से पूछते हैं, एक प्रसिद्ध भविष्यवादी जो गूगल में काम करते हैं, 2029 वह वर्ष हो सकता है जब कृत्रिम बुद्धिमत्ता एक वैध ट्यूरिंग टेस्ट पास करेगी (जो एक प्रयोग है यह देखने के लिए कि क्या कोई मानव किसी मशीन/कंप्यूटर और दूसरे मानव के बीच अंतर कर सकता है।) वह यह भी भविष्यवाणी करते हैं कि सिंगुलैरिटी (जब कंप्यूटर मानव बुद्धि को पार कर जाते हैं) 2045 तक उभरेगी।
कुर्ज़वील इतने आश्वस्त क्यों हैं?
डीप लर्निंग का उदय
सीधे शब्दों में कहें तो, डीप लर्निंग मशीन लर्निंग का एक सबसेट है जो बड़ी मात्रा में डेटा से अंतर्दृष्टि निकालने के लिए न्यूरल नेटवर्क का उपयोग करता है। डीप लर्निंग के वास्तविक दुनिया के अनुप्रयोगों में निम्नलिखित शामिल हैं: - सेल्फ-ड्राइविंग कारें - कैंसर का पता लगाना - वर्चुअल असिस्टेंट, जैसे सिरी और एलेक्सा - चरम मौसम की घटनाओं की भविष्यवाणी, जैसे भूकंप
लेकिन, "न्यूरल नेटवर्क" क्या है?
न्यूरल नेटवर्क को उनका नाम न्यूरॉन्स से मिलता है, जो मस्तिष्क की कोशिकाएं हैं जो विद्युत और रासायनिक संकेतों के माध्यम से जानकारी को संसाधित और संचारित करती हैं। मजेदार तथ्य: मानव मस्तिष्क 80+ बिलियन न्यूरॉन्स से बना है!
कंप्यूटिंग में, एक न्यूरल नेटवर्क ऐसा दिखता है:
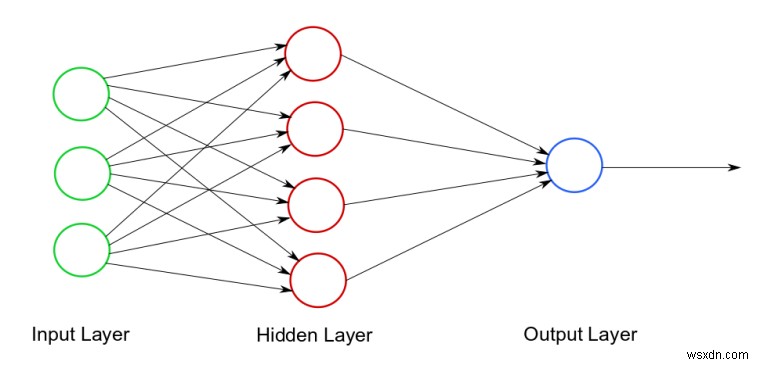 एक उदाहरण न्यूरल नेटवर्क आरेख। फोटो क्रेडिट
जैसा कि आप देख सकते हैं, तीन भाग हैं: 1) इनपुट लेयर -- प्रारंभिक डेटा 2) हिडन लेयर(एस) -- एक न्यूरल नेटवर्क में 1 (या अधिक) हिडन लेयर्स हो सकते हैं। यहीं सभी गणना की जाती है! 3) आउटपुट लेयर -- अंतिम परिणाम/भविष्यवाणी
एक त्वरित इतिहास सबक
न्यूरल नेटवर्क नए नहीं हैं। वास्तव में, पहला प्रशिक्षण योग्य न्यूरल नेटवर्क (द पर्सेप्ट्रॉन) 1950 के दशक में कॉर्नेल विश्वविद्यालय में विकसित किया गया था। हालांकि, न्यूरल नेटवर्क की प्रयोज्यता के आसपास बहुत निराशावाद था, मुख्य रूप से क्योंकि मूल मॉडल में केवल एक हिडन लेयर शामिल था। 1969 में प्रकाशित एक पुस्तक ने दिखाया कि काफी सरल गणनाओं के लिए पर्सेप्ट्रॉन का उपयोग करना अव्यावहारिक होगा।
न्यूरल नेटवर्क का पुनरुत्थान कंप्यूटर गेम के लिए जिम्मेदार ठहराया जा सकता है, जिनके लिए अब अत्यधिक उच्च शक्ति वाले ग्राफिक्स प्रोसेसिंग यूनिट्स (GPUs) की आवश्यकता होती है, जिनकी आर्किटेक्चर एक न्यूरल नेट की तरह निकटता से मिलती है। अंतर हिडन लेयर्स की संख्या है। एक के बजाय, आज प्रशिक्षित न्यूरल नेटवर्क 10, 15, या यहां तक कि 50+ लेयर्स का उपयोग कर रहे हैं!
उदाहरण समय!
यह समझने के लिए कि यह कैसे काम करता है, आइए एक उदाहरण देखें। आपको ruby-fann जेम इंस्टॉल करना होगा। अपना टर्मिनल खोलें और अपनी वर्किंग डायरेक्टरी में जाएं। फिर, निम्नलिखित चलाएं:
gem install ruby-fann
एक नई रूबी फाइल बनाएं (मैंने अपनी neural-net.rb नाम दी)।
अगला, हम कागल से "स्टूडेंट अल्कोहल कंजम्पशन" डेटासेट का उपयोग करेंगे। आप इसे यहां से डाउनलोड कर सकते हैं। "student-mat.csv" फाइल को गूगल शीट्स (या अपनी पसंद के एडिटर) में खोलें। इन को छोड़कर सभी कॉलम हटाएं: - Dalc (वर्कडे अल्कोहल खपत जहां 1 बहुत कम है और 5 बहुत अधिक है) - Walc (वीकेंड अल्कोहल खपत जहां 1 बहुत कम है और 5 बहुत अधिक है) - G3 (अंतिम ग्रेड 0 और 20 के बीच)
हमें अपने अंतिम ग्रेड कॉलम को बाइनरी बनाने की आवश्यकता है -- या तो 0 या 1 -- ruby-fann जेम के काम करने के लिए। इस उदाहरण के लिए, हम मान लेंगे कि 10 से कम या बराबर कुछ भी "0" है और 10 से अधिक "1" है। आप जिस प्रोग्राम का उपयोग कर रहे हैं, उसके आधार पर, आपको सेल में एक फॉर्मूला लिखने में सक्षम होना चाहिए जो सेल के मूल्य के आधार पर मूल्य को स्वचालित रूप से 1 या 0 में बदल दे। गूगल शीट्स में, यह कुछ इस तरह दिखता है:
=IF(C3 >= 10, 1, 0)
इस डेटा को .CSV फाइल के रूप में सेव करें (मैंने अपनी students.csv नाम दी) उसी डायरेक्टरी में जहां आपकी रूबी फाइल है।
हमारे न्यूरल नेटवर्क में निम्नलिखित लेयर्स होंगे: - इनपुट लेयर: 2 नोड्स (वर्कडे अल्कोहल खपत और वीकेंड अल्कोहल खपत) - हिडन लेयर: 6 हिडन नोड्स (यह शुरू करने के लिए कुछ हद तक मनमाना है; आप बाद में टेस्ट करते समय इसे संशोधित कर सकते हैं) - आउटपुट लेयर: 1 नोड (या तो 0 या 1)
सबसे पहले, हमें ruby-fann जेम के साथ-साथ बिल्ट-इन csv लाइब्रेरी की आवश्यकता होगी। इसे अपने रूबी प्रोग्राम की पहली पंक्ति में जोड़ें:
require 'ruby-fann' require 'csv'
अगला, हमें अपने CSV फाइल से डेटा को सरणियों में लोड करना होगा।
# दो खाली सरणियाँ बनाएं। एक हमारे इंडिपेंडेंट वेरिएबल्स (x_data) को धारण करेगा, और दूसरा हमारे डिपेंडेंट वेरिएबल (y_data) को धारण करेगा।
x_data = []
y_data = []
# हमारे CSV डेटा के माध्यम से पुनरावृति करें और लागू सरणियों में तत्व जोड़ें।
# ध्यान दें कि यदि हम .to_f और .to_i नहीं जोड़ते हैं, तो हमारी सरणियों में स्ट्रिंग्स होंगी, और ruby-fann लाइब्रेरी खुश नहीं होगी।
CSV.foreach("students.csv", headers: false) do |row|
  x_data.push([row[0].to_f, row[1].to_f])
  y_data.push(row[2].to_i)
end
अगला, हमें अपने डेटा को प्रशिक्षण और टेस्टिंग डेटा में विभाजित करने की आवश्यकता है। 80/20 विभाजन काफी आम है, जहां आपके 20% डेटा का उपयोग टेस्टिंग के लिए और 80% प्रशिक्षण के लिए किया जाता है। "प्रशिक्षण," यहां, का अर्थ है कि मॉडल इस डेटा के आधार पर सीखेगा, और फिर हम अपने "टेस्टिंग" डेटा का उपयोग यह देखने के लिए करेंगे कि मॉडल परिणामों की भविष्यवाणी कितनी अच्छी तरह करता है।
# डेटा को एक प्रशिक्षण सेट और टेस्ट सेट में विभाजित करें।
testing_percentage = 20.0
# तत्वों की कुल संख्या लें और टेस्ट प्रतिशत से गुणा करें।
testing_size = x_data.size * (testing_percentage/100.to_f)
# शुरुआत से शुरू करें और testing_size - 1 पर समाप्त करें क्योंकि सरणी 0-इंडेक्स्ड हैं।
x_test_data = x_data[0 .. (testing_size-1)]
y_test_data = y_data[0 .. (testing_size-1)]
# जहां हमने छोड़ा था वहां से डेटासेट के अंत तक उठाएं।
x_train_data = x_data[testing_size .. x_data.size]
y_train_data = y_data[testing_size .. y_data.size]
कूल! हमारे डेटा जाने के लिए तैयार हैं। अगला जादू आता है!
# प्रशिक्षण डेटा मॉडल सेट करें।
train = RubyFann::TrainData.new(:inputs=> x_train_data, :desired_outputs=>y_train_data)
हम RubyFann::TrainData ऑब्जेक्ट का उपयोग करते हैं, और अपने x_train_data में पास करते हैं, जो हमारी वर्कडे और वीकेंड अल्कोहल खपत है, और हमारे y_train_data, जो अंतिम कोर्स ग्रेड के आधार पर 0 या 1 है।
अब, आइए पहले चर्चा किए गए हिडन न्यूरॉन्स की संख्या के साथ अपना वास्तविक न्यूरल नेटवर्क मॉडल सेट करें।
# मॉडल सेट करें और प्रशिक्षण डेटा का उपयोग करके प्रशिक्षित करें।
model = RubyFann::Standard.new(
  num_inputs: 2,
  hidden_neurons: [6],
  num_outputs: 1
);
ठीक है, प्रशिक्षित करने का समय!
model.train_on_data(train, 1000, 10, 0.01)
यहां, हम पहले बनाए गए train वेरिएबल को पास करते हैं। 1000 मैक्स_एपोक्स की संख्या का प्रतिनिधित्व करता है, 10 रिपोर्ट के बीच त्रुटियों की संख्या का प्रतिनिधित्व करता है, और 0.1 हमारी वांछित मीन-स्क्वेयर्ड एरर है। एक एपोक तब होता है जब पूरा डेटासेट न्यूरल नेटवर्क के माध्यम से पारित होता है। मीन-स्क्वेयर्ड एरर वह है जिसे हम कम करने की कोशिश कर रहे हैं। आप इसके बारे में यहां और पढ़ सकते हैं।
अगला, हम यह जानना चाहते हैं कि हमारे मॉडल ने हमारे टेस्ट डेटा के लिए जो भविष्यवाणी की थी, उसकी तुलना वास्तविक परिणामों से करके हमारा मॉडल कितना अच्छा किया। हम इसे इस कोड का उपयोग करके पूरा कर सकते हैं:
predicted = []
# हमारे x_test_data पर पुनरावृति करें, प्रत्येक पर अपना मॉडल चलाएं, और इसे हमारे predicted सरणी में जोड़ें।
x_test_data.each do |params|
  predicted.push( model.run(params).map{ |e| e.round } )
end
# भविष्यवाणी किए गए परिणामों की तुलना वास्तविक परिणामों से करें।
correct = predicted.collect.with_index { |e,i| (e == y_test_data[i]) ? 1 : 0 }.inject{ |sum,e| sum+e }
# सटीकता दर प्रिंट करें।
puts "Accuracy: #{((correct.to_f / testing_size) * 100).round(2)}% - test set of size #{testing_percentage}%"
आइए अपना प्रोग्राम चलाएं और देखें क्या होता है!
ruby neural-net.rb
आपको एपोक्स के लिए बहुत सारा आउटपुट देखना चाहिए, लेकिन नीचे, आपको ऐसा कुछ देखना चाहिए:
Accuracy: 56.82% - test set of size 20.0%
उफ़, यह बहुत अच्छा नहीं है! लेकिन, आइए अपने खुद के डेटा पॉइंट्स लेकर आएं और मॉडल चलाएं।
prediction = model.run( [1, 1] )
# आउटपुट को राउंड करके भविष्यवाणी प्राप्त करें।
puts "Algorithm predicted class: #{prediction.map{ |e| e.round }}"
prediction_two = model.run( [5, 4] )
# आउटपुट को राउंड करके भविष्यवाणी प्राप्त करें।
puts "Algorithm predicted class: #{prediction_two.map{ |e| e.round }}"
यहां, हमारे पास दो उदाहरण हैं। पहले के लिए, हम अपने वर्कडे और वीकेंड अल्कोहल खपत के लिए 1 पास कर रहे हैं। अगर मैं एक सट्टेबाज व्यक्ति होता, तो मुझे लगता है कि इस छात्र का अंतिम ग्रेड 10 से ऊपर होगा (यानी, एक 1)। दूसरा उदाहरण अल्कोहल खपत के लिए उच्च मूल्यों (5 और 4) को पास करता है, इसलिए मुझे लगता है कि इस छात्र का अंतिम ग्रेड 10 के बराबर या उससे कम होगा (यानी, एक 0।) आइए अपना प्रोग्राम फिर से चलाएं और देखें क्या होता है!
आपका आउटपुट कुछ इस तरह दिखना चाहिए:
Algorithm predicted class: [1]
Algorithm predicted class: [0]
हमारा मॉडल स्पेक्ट्रम के निचले या उच्च छोर पर संख्याओं के लिए वही करता है जिसकी हम उम्मीद करेंगे। लेकिन, यह तब संघर्ष करता है जब संख्याएं विपरीत होती हैं (बेझिझक अलग-अलग संयोजन आज़माएं -- 1 और 5, या 2 और 3 उदाहरण के रूप में) या बीच में। हम अपने एपोक डेटा से यह भी देख सकते हैं कि, जबकि त्रुटि घटती है, यह बहुत अधिक रहती है (मिड-20%।) इसका मतलब है कि अल्कोहल खपत और कोर्स ग्रेड के बीच कोई संबंध नहीं हो सकता है। मैं आपको कागल से मूल डेटासेट के साथ खेलने के लिए प्रोत्साहित करता हूं -- क्या अन्य इंडिपेंडेंट वेरिएबल्स हैं जिनका उपयोग हम कोर्स परिणामों की भविष्यवाणी करने के लिए कर सकते हैं?
समापन
हुड के नीचे बहुत सारी जटिलताएं हैं (ज्यादातर गणित के संबंध में) जो यह सब काम करने के लिए होती हैं। यदि आप उत्सुक हैं और अधिक सीखना चाहते हैं, तो मैं FANN पर डॉक्स देखने या ruby-fann जेम के स्रोत कोड को देखने की अत्यधिक अनुशंसा करता हूं। मैं नेटफ्लिक्स पर "अल्फागो" डॉक्यूमेंट्री देखने की भी सिफारिश करता हूं -- इसका आनंद लेने के लिए बहुत अधिक तकनीकी ज्ञान की आवश्यकता नहीं है और यह एक शानदार, वास्तविक जीवन का उदाहरण देता है कि डीप लर्निंग कंप्यूटर क्या हासिल कर सकते हैं की सीमाओं को कैसे आगे बढ़ा रहा है।
क्या कुर्ज़वील अपनी भविष्यवाणी के साथ सही साबित होंगे? केवल समय बताएगा!


