मेरे अभी बच्चे नहीं हैं, लेकिन जब होंगे, तो मैं चाहता हूं कि वे दो चीजें सीखें:
- पर्सनल फाइनेंस
- मशीन लर्निंग
चाहे आप मानते हों कि सिंगुलैरिटी निकट है या नहीं, इस बात से इनकार नहीं किया जा सकता कि दुनिया डेटा पर चलती है। यह समझना कि वह डेटा ज्ञान में कैसे बदला जाता है, आजकल उम्र के आने वाले किसी भी व्यक्ति के लिए महत्वपूर्ण है — और डेवलपर्स के लिए तो और भी अधिक।
यह उस श्रृंखला का पहला लेख है जो फुल-स्टैक Ruby डेवलपर्स के लिए मशीन लर्निंग (ML) को सुलभ बनाने का प्रयास करेगा। अपने निपटान में ML टूल्स को समझकर, आप अपने स्टेकहोल्डर्स को बेहतर निर्णय लेने में मदद कर पाएंगे। भविष्य के लेख व्यक्तिगत तकनीकों और व्यावहारिक उदाहरणों पर ध्यान केंद्रित करेंगे, लेकिन इसमें हम मंच तैयार कर रहे हैं — आपको एक नक्शा दिखा रहे हैं और एक पिन लगा रहे हैं जिस पर लिखा है "आप यहाँ हैं।"
विनम्र शुरुआत
आर्टिफिशियल इंटेलिजेंस (AI) और मशीन लर्निंग कुछ नया नहीं है। 1950 के दशक में, आर्थर सैमुअल ने एक कंप्यूटर प्रोग्राम बनाया जो चेकर्स खेल सकता था। उन्होंने "अल्फा-बीटा प्रूनिंग" का इस्तेमाल किया — एक सामान्य सर्च एल्गोरिदम।
1960 के दशक में मल्टी-लेयर्ड न्यूरल नेटवर्क्स और नियरेस्ट-नेबर एल्गोरिदम का आगमन देखा गया, जिसका उपयोग वेयरहाउस में इष्टतम पाथफाइंडिंग के लिए किया जाता है।
तो अगर AI इतना पुराना है, तो AI स्टार्टअप्स इतने ट्रेंडी क्यों हैं? मेरी राय में, इसके दो कारण हैं:
- कंप्यूटिंग पावर (मूर के नियम देखें)
- हर दिन इंटरनेट पर जोड़े जाने वाले डेटा की मात्रा
दैनिक आधार पर बनाए जा रहे डेटा की मात्रा से संबंधित दो आंकड़े हैं जो हर बार जब मैं उनके बारे में सोचता हूं तो मेरा दिमाग चकरा जाता है:
- 2018 तक, हम हर दिन 2.5 क्विंटिलियन बाइट्स डेटा का उत्पादन कर रहे हैं। इसमें कोई संदेह नहीं कि यह संख्या तब से केवल बढ़ी है जब यह फोर्ब्स लेख प्रकाशित हुआ था।
पिछले दो वर्षों में अकेले, दुनिया में 90% डेटा उत्पन्न हुआ था।
एक साथ, इसका मतलब है कि (1) डेटा स्टोर करने और एल्गोरिदम चलाने के लिए आवश्यक हार्डवेयर अधिक किफायती होता जा रहा है और (2) ML मॉडल्स को प्रशिक्षित करने के लिए उपलब्ध डेटा की मात्रा पागलपन भरी तेज गति से बढ़ रही है।
हर दिन हम कृत्रिम बुद्धिमत्ता और मशीन लर्निंग की दुनिया के साथ इंटरैक्ट कर रहे हैं, इससे प्रभावित हो रहे हैं, और इसमें योगदान दे रहे हैं। उदाहरण के लिए, आप एल्गोरिदम को धन्यवाद दे सकते हैं (या दोष दे सकते हैं) निम्नलिखित के लिए:
- आपकी क्रेडिट लाइन
- बीमारी का निदान करने में मदद
- शायद यह भी कि आपको नौकरी मिली या नहीं
- वर्तमान ट्रैफ़िक स्थितियों को देखते हुए सबसे कुशल मार्ग खोजने में मदद
- एलेक्सा को ठीक-ठीक समझना कि आपका मतलब क्या है जब आप उसे बताते हैं कि आपने छींक मारी
- Spotify आपको आपका नया पसंदीदा गाना पेश कर रहा है
मैंने अपने काल्पनिक भविष्य के बच्चों का जिक्र इसीलिए किया है: मैं चाहता हूं कि वे समझें कि उनका डिजिटल जीवन उनके "वास्तविक" जीवन को कैसे प्रभावित करता है, उनके डेटा गोपनीयता निर्णयों के निहितार्थ, और अपनी खुद की राय कैसे बनाएं कि उन्हें मशीन पर कब भरोसा करना चाहिए बनाम कब नहीं।
इस पोस्ट के शेष भाग में, मैं उन तीन प्रकार के मशीन लर्निंग का अवलोकन देना चाहता हूं जिनका मैंने अध्ययन किया है: सुपरवाइज़्ड लर्निंग, अनसुपरवाइज़्ड लर्निंग, और रीइन्फोर्समेंट लर्निंग। हम बात करेंगे कि प्रत्येक दृष्टिकोण को क्या विशिष्ट बनाता है और प्रत्येक किन समस्याओं को हल करने में विशेष रूप से अच्छा है।
सुपरवाइज़्ड लर्निंग
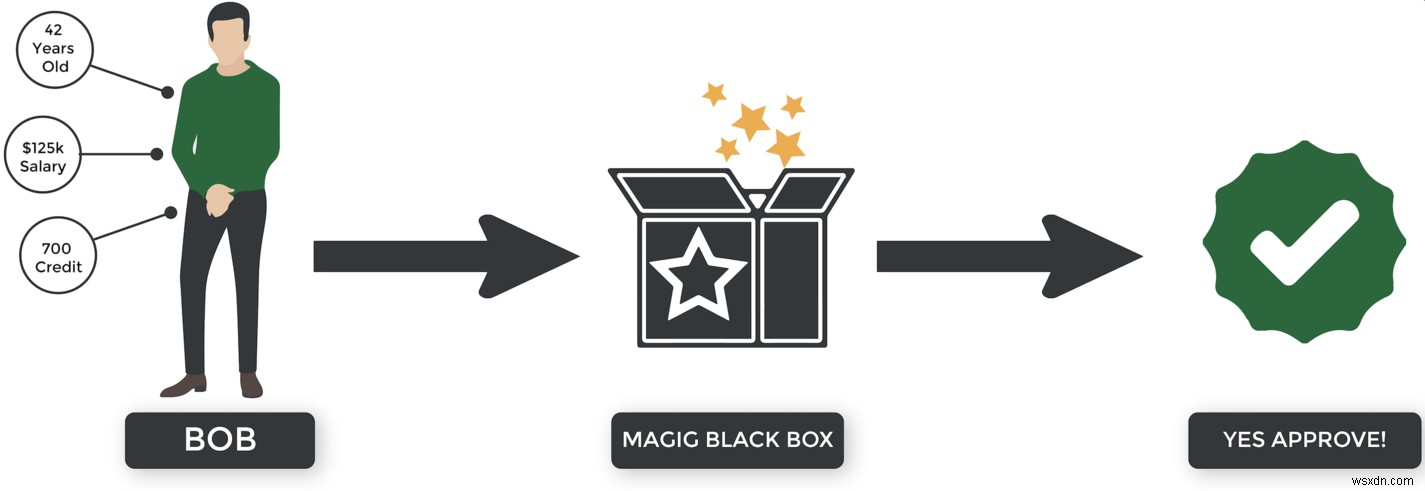
सुपरवाइज़्ड लर्निंग है... खैर, इंसानों द्वारा सुपरवाइज़्ड। :) कल्पना करें कि हम एक सुपरवाइज़्ड लर्निंग सिस्टम बना रहे हैं जो यह तय करता है कि किसे मॉर्गेज के लिए मंजूरी मिलती है। यहाँ यह कैसे काम कर सकता है:
- बैंक एक डेटासेट संकलित करता है जो ग्राहक विशेषताओं (उम्र, वेतन, आदि) को परिणामों (पुनर्भुगतान, डिफ़ॉल्ट, आदि) से मैप करता है।
- हम डेटा का उपयोग करके अपने सिस्टम को प्रशिक्षित करते हैं।
- सिस्टम जो सीखता है उसका उपयोग आवेदक की विशेषताओं के आधार पर भविष्य के परिणामों का अनुमान लगाने के लिए करता है।
- यदि एल्गोरिदम सही अनुमान लगाता है, तो हम इसे बताते हैं, "शाबाश! आप सही हैं।" लेकिन अगर यह गलत है, तो हम इसे बताते हैं, "नहीं, आप गलत हैं। कृपया सुधारें और फिर से प्रयास करें।"
इस उदाहरण को "वर्गीकरण" समस्या माना जाता है क्योंकि एल्गोरिदम का आउटपुट एक श्रेणी है — इस मामले में, स्वीकृत या अस्वीकृत। वर्गीकरण समस्याओं के अन्य उदाहरणों में यह तय करना शामिल है कि:
- किसी व्यक्ति को कोई बीमारी है
- किसी एक्स-रे में टूटी हुई हड्डी है
- कोई ईमेल स्पैम है
यदि आप ML वर्गीकरण एल्गोरिदम के पीछे के गणित के बारे में अधिक जानने के लिए उत्सुक हैं, तो इनमें से किसी को भी गूगल करें: नाइव बायेस क्लासिफायर्स, सपोर्ट वेक्टर मशीन्स, लॉजिस्टिक रिग्रेशन, न्यूरल नेटवर्क्स, रैंडम फॉरेस्ट्स।
वर्गीकरण समस्याओं के अलावा जो "हां/नहीं" परिणाम देते हैं, सुपरवाइज़्ड लर्निंग का उपयोग रिग्रेशन समस्याओं को हल करने के लिए भी किया जा सकता है — यहां, हम एक निरंतर पैमाने पर भविष्यवाणी करते हैं, उदाहरण के लिए:
- स्टॉक का भविष्य का मूल्य
- न्यू इंग्लैंड पैट्रियट्स के सुपर बाउल जीतने की संभावना
- औसत वेतन जो एक कंपनी को एक उम्मीदवार को पेशकश करने की आवश्यकता है ताकि वे स्वीकार करें
सुपरवाइज़्ड रिग्रेशन समस्याओं के लिए उपयोग किए जाने वाले एल्गोरिदम के उदाहरणों में लीनियर रिग्रेशन, नॉन-लीनियर रिग्रेशन, और बायेसियन लीनियर रिग्रेशन शामिल हैं।
अनसुपरवाइज़्ड लर्निंग
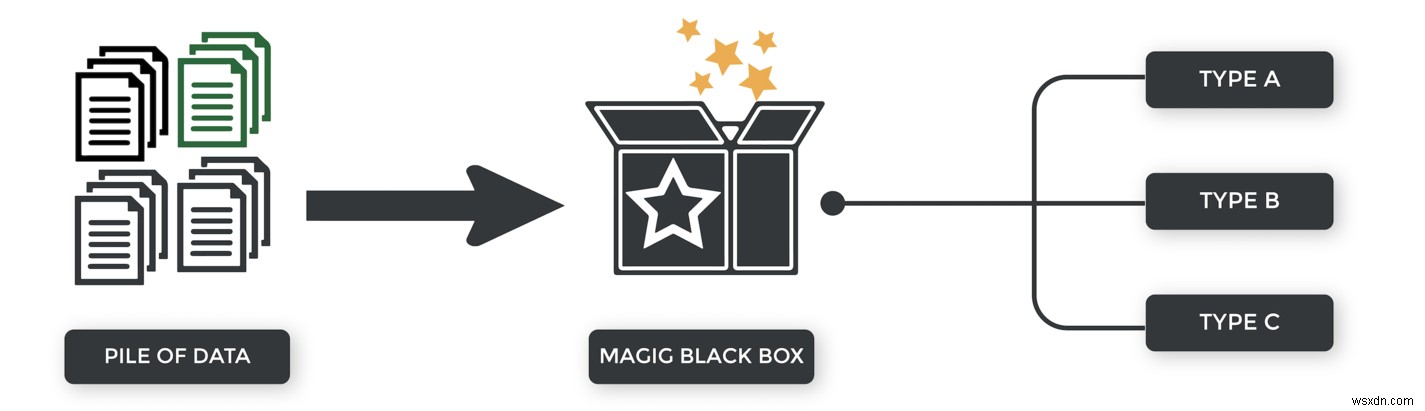
हमारे सुपरवाइज़्ड लर्निंग उदाहरण के साथ, हमने वर्गीकरण श्रेणियों को पूर्वनिर्धारित किया। मॉर्गेज आवेदक या तो स्वीकृत था या अस्वीकृत।
अनसुपरवाइज़्ड लर्निंग के साथ, हम श्रेणियाँ प्रदान नहीं करते। वे हमारे लिए उपलब्ध नहीं हैं। एल्गोरिदम को अपने निष्कर्ष खुद निकालने होंगे।
हम अनसुपरवाइज़्ड दृष्टिकोण का उपयोग क्यों करना चाहेंगे?
1) कभी-कभी हम पहले से श्रेणियों को नहीं जानते हैं। इंटरनेट पर तैरने वाला बहुत सारा डेटा अनस्ट्रक्चर्ड है — यानी, लेबल रहित।
2) दूसरी बार, हम नहीं जानते कि हम क्या खोज रहे हैं, इसलिए हम एल्गोरिदम को पैटर्न/विशेषताएं खोजने के लिए कह सकते हैं जो वर्गीकरण के लिए उपयोगी हो सकती हैं।
अनस्ट्रक्चर्ड डेटा को मशीन लर्निंग के साथ संभालने का एक और तरीका है कि बस इंसानों को इसे देखने दें और मैन्युअल रूप से लेबल करें। बहुत सारी कंपनियां हैं जो डेटा को मैन्युअली वर्गीकृत करने के लिए कर्मचारियों को हायर करती हैं: डेटा लेबलिंग।
अनसुपरवाइज़्ड लर्निंग के दृष्टिकोण
अनसुपरवाइज़्ड लर्निंग में आमतौर पर उपयोग की जाने वाली दो तकनीकें एसोसिएशन और क्लस्टरिंग हैं।
एसोसिएशन: कल्पना करें कि आप Amazon हैं। आपके पास बहुत सारा ग्राहक डेटा, खरीद इतिहास, आदि है। अनसुपरवाइज़्ड लर्निंग का उपयोग करके, आप ग्राहकों को "खरीदारों के प्रकार" में विभाजित कर सकते हैं — शायद यह पता लगा सकते हैं कि जो लोग गुलाबी छाते खरीदते हैं, उनके Matcha चाय खरीदने की भी अधिक संभावना है।
क्लस्टरिंग: क्लस्टरिंग आपके डेटा को देखता है और इसे निर्दिष्ट संख्या में समूहों, या क्लस्टर्स में विभाजित करता है। उदाहरण के लिए, शायद आपके पास बहुत सारा हाउसिंग डेटा है और आप देखना चाहते हैं कि क्या कोई विशेषताएं (संभवतः अपराध डेटा?) हैं जो भविष्यवाणी कर सकती हैं कि घर किस पड़ोस में है। या, कोसाइन सिमिलैरिटी जैसी तकनीकों का उपयोग टेक्स्ट वर्गीकरण के लिए किया जा सकता है (उदाहरण के लिए, क्या यह लेख टेनिस, खाना पकाने, या अंतरिक्ष के बारे में है?)।
यदि आप विशिष्ट अनसुपरवाइज़्ड लर्निंग तकनीकों के बारे में अधिक जानने में रुचि रखते हैं, तो k-मीन्स क्लस्टरिंग, कोसाइन सिमिलैरिटी, हायरार्किकल क्लस्टरिंग, और k-नियरेस्ट-नेबर क्लस्टरिंग के लिए गूगल खोजें।
रीइन्फोर्समेंट लर्निंग
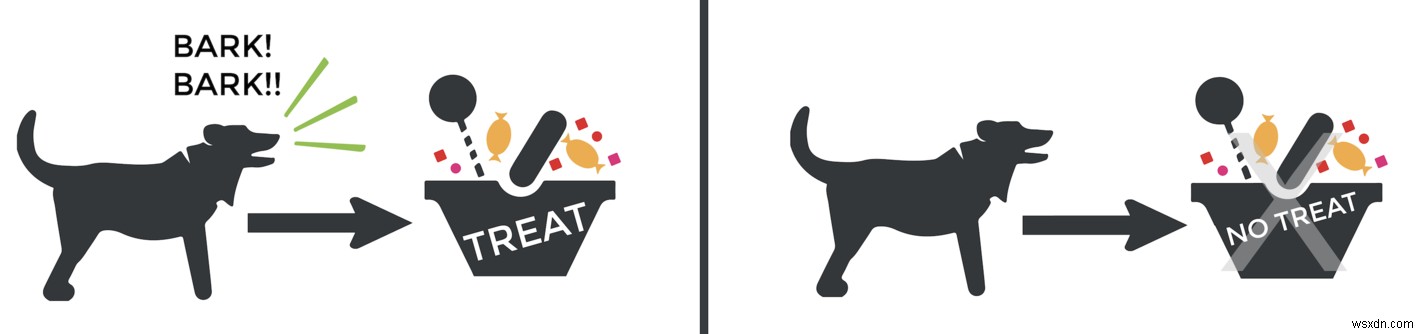
मशीन लर्निंग का यह सबसेट आमतौर पर गेम्स में उपयोग किया जाता है क्योंकि यह लक्ष्य-उन्मुख एल्गोरिदम का उपयोग करता है। सुपरवाइज़्ड लर्निंग के विपरीत, प्रत्येक निर्णय स्वतंत्र नहीं होता — दिए गए वर्तमान इनपुट को देखते हुए, एल्गोरिदम एक निर्णय लेता है और अगला इनपुट इस निर्णय पर निर्भर करता है।
जैसे मैं अपने कुत्ते को सिर पर थपथपाता हूं जब वह दरवाजे की घंटी बजने पर लगातार भौंकना बंद कर देता है या उसे उसके केनेल में डाल देता हूं जब वह चुप नहीं होता, रीइन्फोर्समेंट एल्गोरिदम को लक्ष्य-अनुकूल निर्णय लेने पर पुरस्कृत किया जाता है (उदाहरण के लिए, अधिकतम अंक प्राप्त करना) और खराब निर्णय लेने पर दंडित किया जाता है।
रीइन्फोर्समेंट लर्निंग एल्गोरिदम के स्पष्ट अनुप्रयोगों में शामिल हैं:
- शतरंज और गो जैसे खेल (यदि आपने अभी तक नहीं देखा है तो नेटफ्लिक्स पर AlphaGo डॉक्यूमेंट्री देखने की अत्यधिक अनुशंसा करता हूं।)
- रोबोटिक्स (बॉट्स को वांछित कार्य पूरा करना सिखाना)
- स्वायत्त वाहन
- रोबो-सलाहकार जो शेयर बाजार को हराने के लिए प्रशिक्षित हैं
यदि आप रीइन्फोर्समेंट लर्निंग के पीछे के एल्गोरिदम के बारे में अधिक जानने में रुचि रखते हैं, तो Q-लर्निंग, स्टेट-एक्शन-रिवॉर्ड-स्टेट-एक्शन (SARSA), DQN, और एसिंक्रोनस एडवांटेज एक्टर क्रिटिक के लिए गूगल खोजें।
निष्कर्ष
मुझे उम्मीद है कि इन उदाहरणों ने आपको मशीन लर्निंग तकनीकों पर एक पकड़ बनाने में मदद की है और प्रत्येक का उपयोग आज हमारे द्वारा जी रही पागल दुनिया को प्रभावित करने के लिए कैसे किया जाता है। जबकि मैं कभी-कभी खुद को सीखने के लिए बहुत कुछ पाकर अभिभूत पाता हूं, कहीं से शुरू करना कुछ न करने से बेहतर है, और याद रखें कि इसमें से बहुत कुछ वास्तव में बिल्कुल भी नया नहीं है — हम बस इसके बारे में अधिक सुन रहे हैं क्योंकि डेटा अधिक उपलब्ध होता जा रहा है और प्रोसेसिंग पावर सस्ती हो रही है।