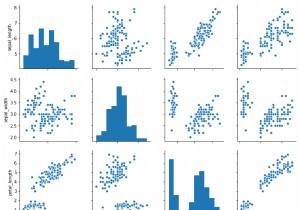
सहसंबंध दो चर के बीच संबंध को मापने के लिए एक सांख्यिकीय शब्द है। यदि संबंध मजबूत है, अर्थात एक चर में परिवर्तन दूसरे चर में पूर्वानुमेय पैटर्न में परिवर्तन को दर्शाता है, तो हम कहते हैं कि चर सहसंबद्ध हैं। इसके अलावा पहले चर में भिन्नता दूसरे चर में सकारात्मक या नकारात्मक भिन्नता ला सकती है। तदनुसार, उन्हें सकारात्मक या नकारात्मक सहसंबद्ध कहा जाता है। आदर्श रूप से सहसंबंध गुणांक का मान -1 से +1 के बीच भिन्न होता है।
- यदि मान +1 या इसके करीब है तो हम कहते हैं कि चर सकारात्मक रूप से सहसंबद्ध हैं। और वे एक ही दिशा में एक साथ भिन्न होते हैं।
- यदि मान -1 या इसके करीब है तो हम कहते हैं कि चर नकारात्मक रूप से सहसंबद्ध हैं। और वे विपरीत दिशा में एक साथ भिन्न होते हैं।
- यदि मान 0 या इसके करीब है तो हम कहते हैं कि चर सहसंबद्ध नहीं हैं।
सहसंबंध गुणांक को मापने के अलग-अलग तरीके हैं। वे numpy या scipy.stats में फ़ंक्शन के रूप में उपलब्ध हैं। नीचे हम देखेंगे कि उनका उपयोग कैसे किया जाता है।
स्पीयरमैन सहसंबंध का उपयोग
स्पीयरमैन सहसंबंध रैखिक रूप से संबंधित चर के बीच संबंध की डिग्री को मापने के लिए है। यह एक सूत्र पर आधारित है जिसका उपयोग scipy.stats पैकेज द्वारा परिणाम उत्पन्न करने के लिए किया जाता है। यह सहसंबंध खोजने के लिए सबसे व्यापक रूप से उपयोग किया जाने वाला सूत्र है।
नीचे दिए गए उदाहरण में हम दो चर लेते हैं जिनके मान numpy.random() फ़ंक्शन का उपयोग करके उत्पन्न होते हैं। फिर अंतिम परिणाम प्राप्त करने के लिए spearmanr() लागू किया जाता है।
उदाहरण
from numpy.random import randn
from numpy.random import seed
from scipy.stats import spearmanr

seed(1)
data_input1 = 20 * randn(1000) + 100
data_input2 = data_input1 + (10 * randn(1000) + 50)
correlation = spearmanr(data_input1, data_input2)
print(correlation)
आउटपुट
SpearmanrResult(correlation=0.8724050484050484, pvalue=1.58425746359e-312)
पियर्सन सहसंबंध का उपयोग
पियर्सन सहसंबंध रैखिक रूप से संबंधित चर के बीच संबंध की डिग्री को मापने का एक और तरीका है। यह एक सूत्र पर आधारित है जिसका उपयोग scipy.stats पैकेज द्वारा परिणाम उत्पन्न करने के लिए किया जाता है।
नीचे दिए गए उदाहरण में हम दो चर लेते हैं जिनके मान numpy.random() फ़ंक्शन का उपयोग करके उत्पन्न होते हैं। फिर अंतिम परिणाम प्राप्त करने के लिए pearsonr() लागू किया जाता है।
उदाहरण
from numpy.random import randn
from numpy.random import seed
from scipy.stats import pearsonr

seed(1)
data1 = 20 * randn(1000) + 100
data2 = data1 + (10 * randn(1000) + 50)
correlation, _ = pearsonr(data1, data2)
print('Pearsons correlation: %.3f' % correlation)
आउटपुट
Pearsons correlation: 0.888
निष्कर्ष
पायथन में scipy.stats से स्पीयरमैन और पियर्सन सहसंबंध गुणांक की गणना करें।