हाल ही में, वास्तव में अच्छे, नए, अद्वितीय Linux सॉफ़्टवेयर को ढूंढना एक मुश्किल काम बन गया है। एक काम। और हाल ही में से, मेरा वास्तव में मतलब पिछले चार या पांच साल से है, जब से डेस्कटॉप स्पेस में उत्साह और नवाचार की धीमी गिरावट शुरू हुई। आखिरकार, एक सीमा है कि कितना अच्छा सामान बुद्धि के एक सीमित आयतन में मौजूद हो सकता है, लेकिन मोबाइल पर फोकस के गलत बदलाव और Linux के वर्ष के सपने के टूटने को न भूलें।
यह चार साल पुराने सॉफ़्टवेयर के मेरे परीक्षण को मान्य बनाता है जिसका नाम OCRFeeder है, मुझे लगता है। दो कारणों से। यदि यह अच्छा है, तो यह अच्छा है। दूसरा, मुझे हमेशा ऑप्टिकल कैरेक्टर रिकग्निशन की प्रगति में दिलचस्पी रही है, और क्या हमारे टूल (AI पढ़ें) यहां उचित काम कर सकते हैं। मैंने इसके बारे में विस्तार से कुछ समय पहले लिखा था, और फिर 2015 में YAGF की समीक्षा की। अब, आइए OCRFeeder पर नज़र डालें और यह क्या कर सकता है। मेरे पीछे आइए, बहादुर Linux योद्धाओं।
JPG के लिए शब्द आसानी से नहीं आते
मैंने प्रोग्राम इंस्टॉल किया। काफी कुछ लाइब्रेरी हैं जिन्हें आपको हथियाने की आवश्यकता है। Ubuntu 18.04 में, सूची कई पंक्तियों में चली गई। आपको इस प्रोग्राम के लिए डिफ़ॉल्ट किट के रूप में Tesseract OCR इंजन मिलता है।
The following additional packages will be installed:
blt gir1.2-goocanvas-2.0 gir1.2-gtkspell3-3.0 libgoocanvas-2.0-9 libgoocanvas-2.0-common libgtkspell3-3-0 liblept5 libtesseract4 libyelp0 python-bs4 python-chardet python-enchant python-html5lib python-lxml python-numpy python-olefile python-pil python-renderpm python-reportlab python-reportlab-accel python-sane python-tk python-webencodings tesseract-ocr tesseract-ocr-eng tesseract-ocr-osd tk8.6-blt2.5 unpaper yelp yelp-xsl
Suggested packages:
blt-demo python-gobject python-wxgtk3.0 python-genshi python-lxml-dbg python-lxml-doc gfortran python-dev python-nose python-numpy-dbg python-numpy-doc python-pil-doc python-pil-dbg python-renderpm-dbg python-egenix-mxtexttools python-reportlab-doc python-sane-dbg tix python-tk-dbg
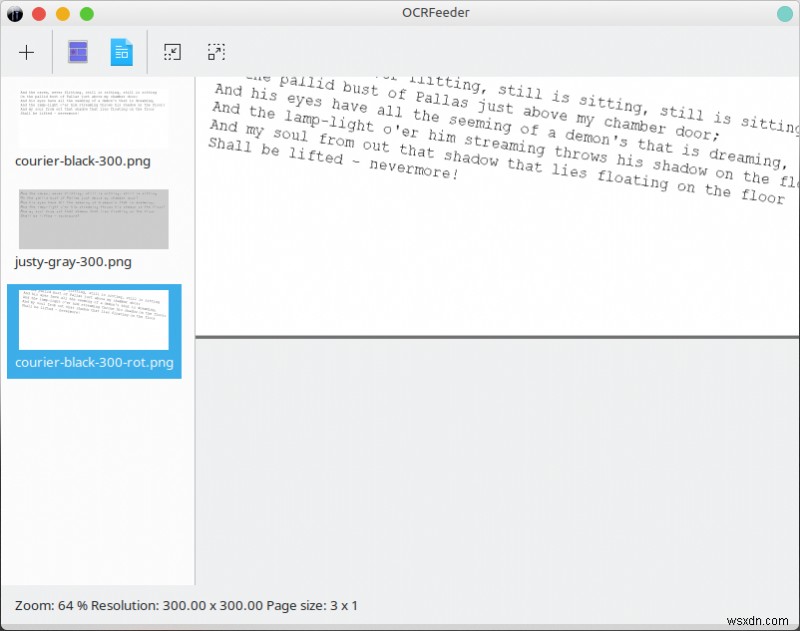
इसे लॉन्च किया। इंटरफ़ेस थोड़ा उपयोगितावादी है। आपको पहले एक या अधिक इमेज लोड करने की आवश्यकता है, जिन्हें आप तब अपने OCR इंजन को खिलाने के लिए उपयोग करेंगे, और उम्मीद है कि यह दूसरे छोर पर उचित-सटीकता वाला टेक्स्ट उत्पन्न करेगा। एक बार जब आप इसके साथ हो जाते हैं, तो आप टेक्स्ट को LibreOffice में निर्यात कर सकते हैं।
OCR इंजन
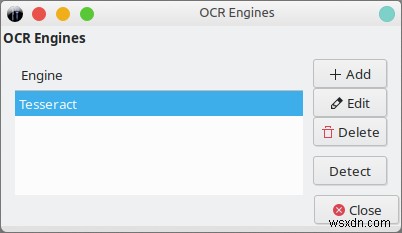
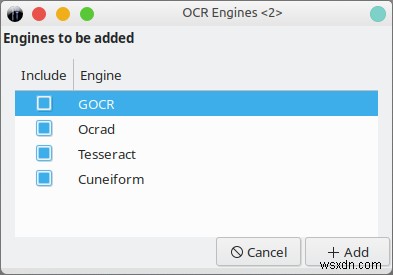
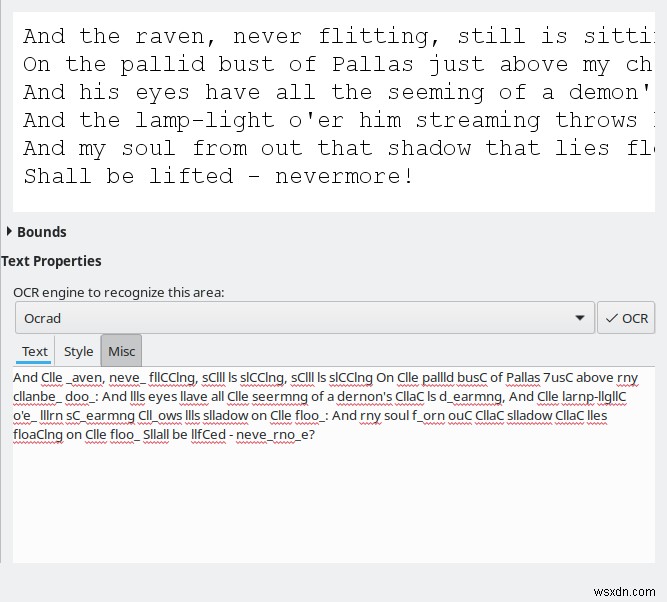
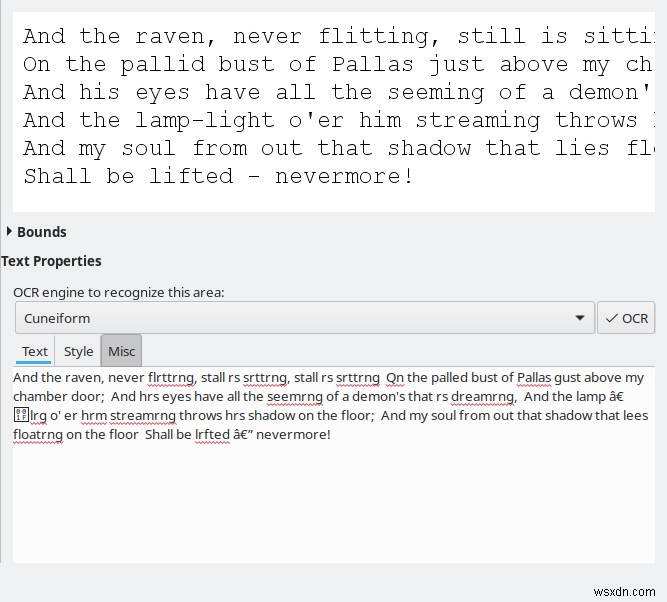
जैसा कि मैंने उल्लेख किया है, डिफ़ॉल्ट रूप से, OCRFeeder Tesseract का उपयोग करेगा, लेकिन आप कोई अन्य इंजन जोड़ सकते हैं जो आप पसंद करते हैं। वास्तव में, मैंने CuneiForm, GOCR और Ocrad आज़माए, और प्रोग्राम ने उन सभी को सही ढंग से पहचाना और लोड किया। बहुत साफ। यह आपको अपने दस्तावेज़ों को कई तरीकों से आज़माने की क्षमता देता है, क्योंकि इनमें से कुछ इंजनों के साथ आपको अधिक भाग्य हो सकता है।
sudo apt-get install cuneiform gocr ocrad
इमेज-टू-टेक्स्ट रूपांतरण
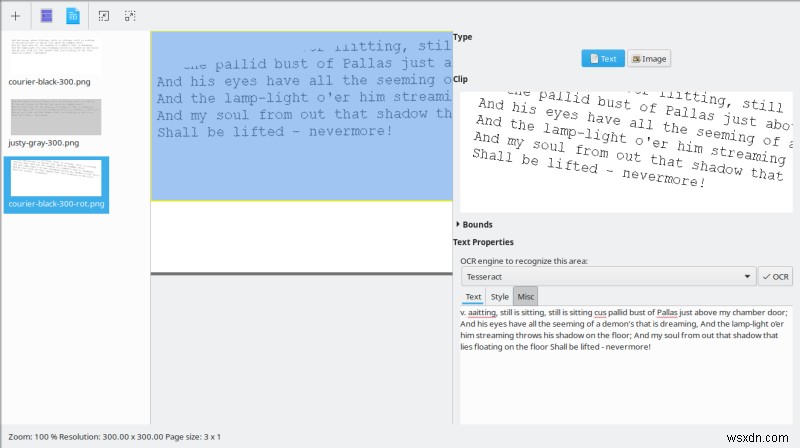
अब, महत्वपूर्ण हिस्सा। मुझे यहां थोड़ा संघर्ष करना पड़ा। मैंने प्रोग्राम को सभी उपलब्ध इमेज में टेक्स्ट को ऑटो-डिटेक्ट (सभी पेज पहचानें) करने दिया, और मुझे कुछ अजीब रंग-चिह्नित आउटपुट मिला। इस चीज़ को लोड की गई तीन PNG फ़ाइलों के लिए पूरा होने में लगभग तीन मिनट लगे, और उस दौरान, OCRFeeder CPU उपयोग लगभग 17% था, और Tesseract लगभग 4-5% उपयोग कर रहा था। इसलिए यदि एप्लिकेशन सभी प्रोसेसर कोर का बेहतर उपयोग करने का काम करता है तो समय निश्चित रूप से कम किया जा सकता है। फिर, अजीब आउटपुट। मुझे यकीन नहीं था कि क्या करना है। अजीब। ऐसा लग रहा था कि मैं बिल्कुल भी प्रगति नहीं कर रहा हूं।
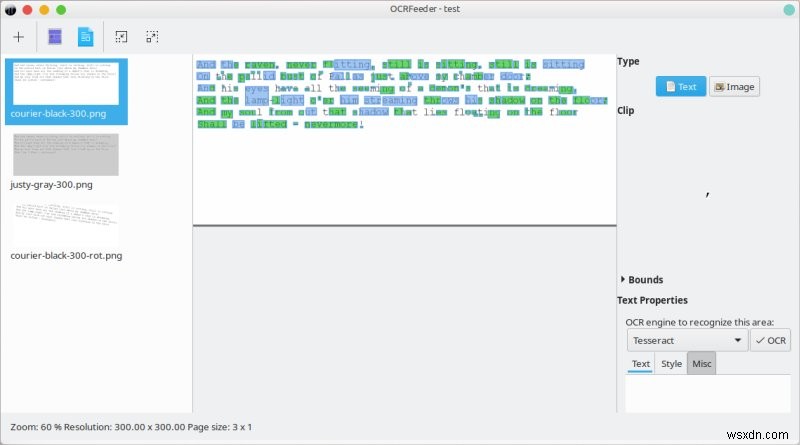
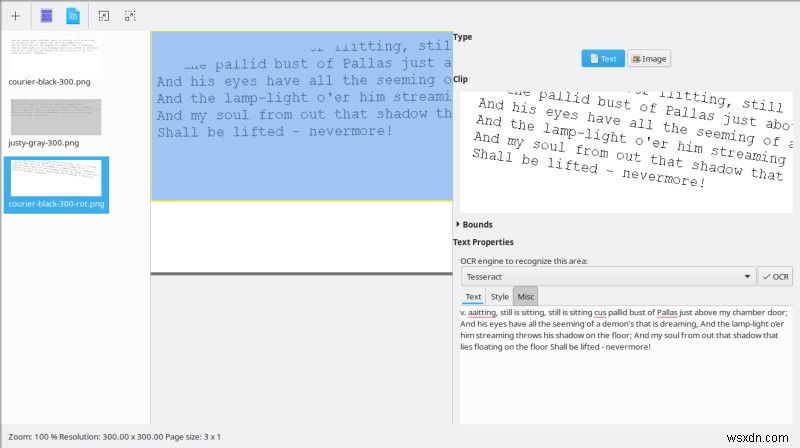
फिर, मुझे एहसास हुआ कि मैं प्रदर्शित इमेज के भागों को खींचकर और चुनने के लिए माउस का उपयोग कर सकता हूं, और फिर, एक अलग फलक खुलेगा, जहां मैं वांछित OCR इंजन चुन सकता हूं, और वास्तविक रूपांतरण चला सकता हूं। दृश्य गड़बड़ियों के बावजूद, यह उचित रूप से अच्छी तरह से काम करता था, और प्रत्येक इमेज को प्रोसेस करने में केवल कुछ सेकंड लगे।
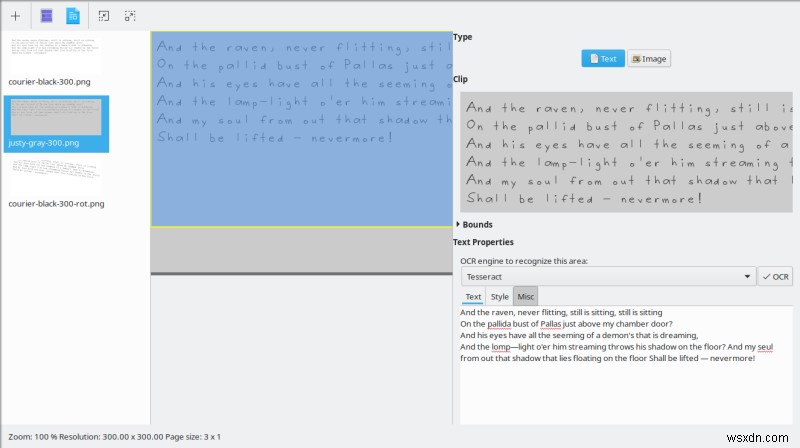
किसी भी प्रशिक्षण या डिफ़ॉल्ट में बदलाव के बिना, चार उपलब्ध इंजनों के बीच परिणामों का अंतर बहुत बड़ा था। Tesseract ने सर्वश्रेष्ठ - और केवल स्वीकार्य रूपांतरण प्रदर्शित किया। बाकी केवल उपयोग करने पर विचार करने के लिए पर्याप्त नहीं थे। मुझे यकीन नहीं है क्यों, बस ऐसा ही है।
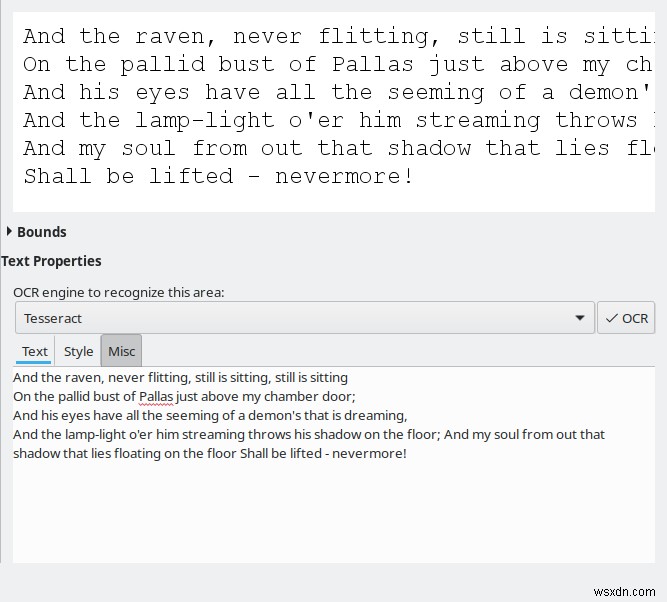
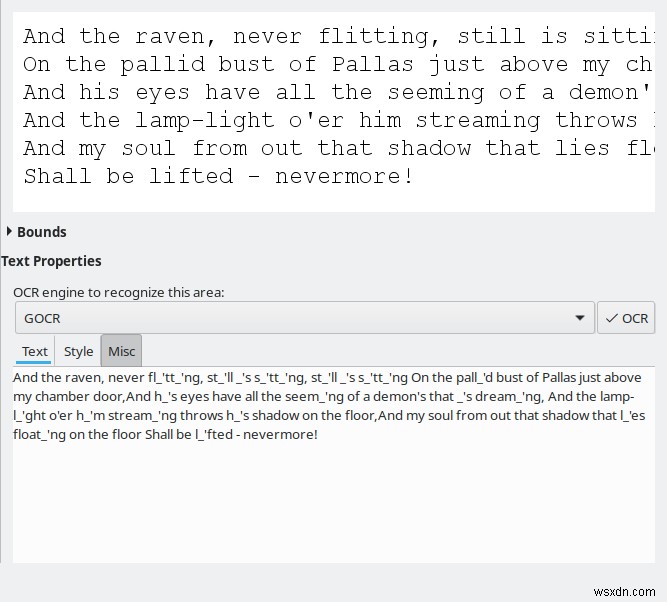
मैंने ग्रे-बैकग्राउंड इमेज के साथ बेहतर परिणाम भी देखे। अतीत में, Tesseract संघर्ष करता था, इसलिए इस इंजन में जो भी सुधार हुए हैं, वे सबसे स्वागत योग्य हैं। लेकिन फिर, यह सख्ती से OCRFeeder की बात नहीं है, और यदि आप चाहें तो आप Tesseract को स्वयं, कमांड लाइन से चला सकते हैं।
डिस्क्यूइंग और अनपेपरिंग
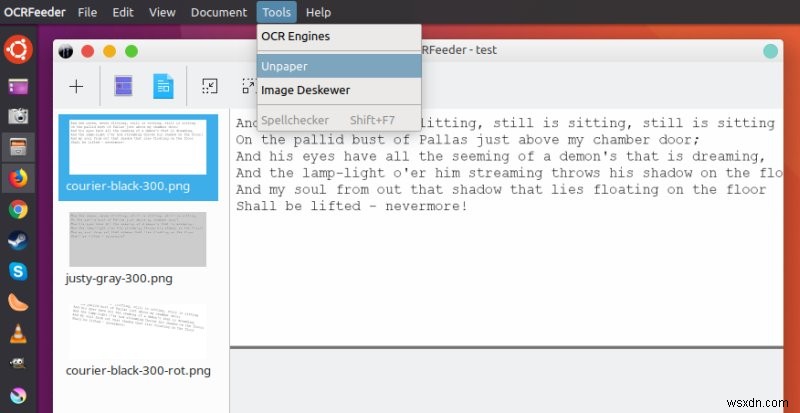
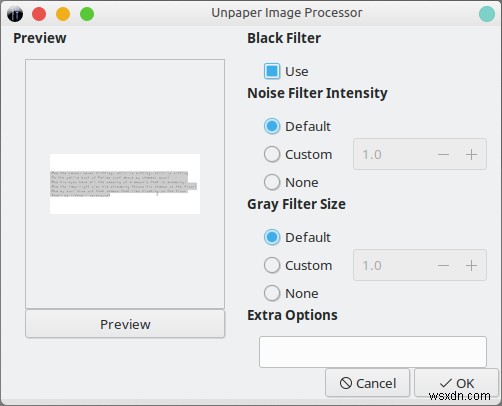
OCRFeeder दो निफ्टी फ़ंक्शन के साथ आता है - तिरछी इमेज स्कैन में टेक्स्ट को ऑटो-रोटेट करने की क्षमता, और पेपर बैकग्राउंड को हटाने की क्षमता ताकि शोर कम हो और अधिक सटीक रूपांतरण की अनुमति मिले। मैंने दोनों विकल्पों को आज़माया, और डिस्क्यू ठीक काम करता था। अनपेपरिंग, ठीक-ठाक। लेकिन जब मैंने टेक्स्ट को घुमाया (जिसे मैंने बहुत पहले नियंत्रण इमेज में GIMP में किया था), तो रूपांतरण के परिणाम और भी बेहतर थे।
ODT में निर्यात करें
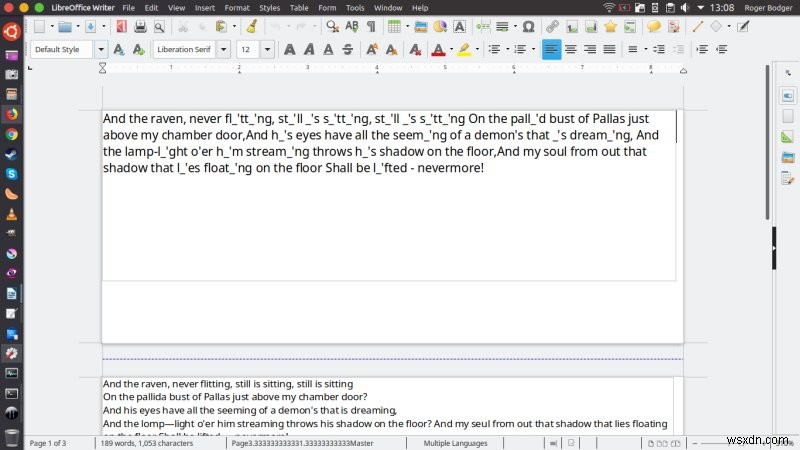
यह थोड़ा मुश्किल था। मैंने इसे कुछ बार आज़माया, और मुझे कई त्रुटियों का सामना करना पड़ा। अंततः यह काम कर गया। आउटपुट सबसे सुंदर नहीं है, लेकिन अच्छी बात यह है कि आप एक ही समय में कई रूपांतरण निर्यात कर सकते हैं, जिसमें विभिन्न इमेज के लिए विभिन्न इंजनों का उपयोग शामिल है। काफी साफ।
वरीयताएँ
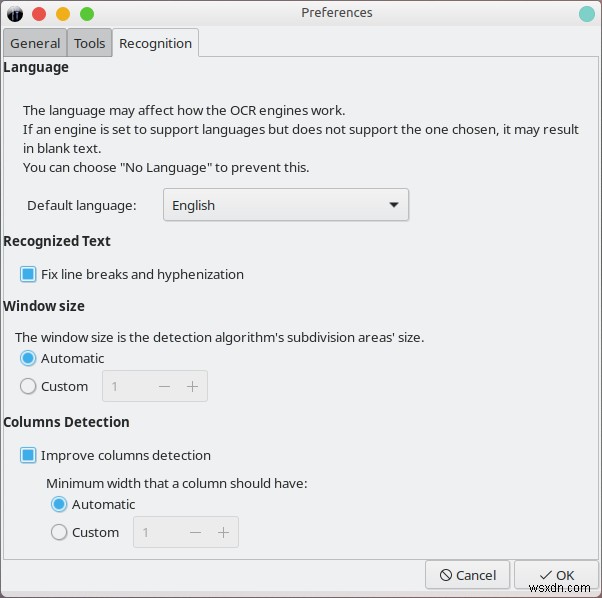
अंत में, आपके पास प्रोग्राम के व्यवहार को बदलने का विकल्प है। कुछ भी बड़ा नहीं, लेकिन यह पहचान और सटीकता में मदद कर सकता है। ज्यादातर यह इस बात पर निर्भर करता है कि आप टेक्स्ट कॉलम चौड़ाई, मार्जिन, भाषा चयन, और इसी तरह का पता कैसे लगाते हैं। अधिकांश लोगों के लिए, डिफ़ॉल्ट एक उचित प्रारंभिक बिंदु होगा।
निष्कर्ष
OCRFeeder एक उचित, लचीला सॉफ़्टवेयर है। यह कई इंजनों का उपयोग कर सकता है, और इमेज-फिक्सिंग एल्गोरिदम एक अच्छा जोड़ है। यह OCRFeeder को शायद इस तरह के सबसे आशाजनक सॉफ़्टवेयर को मुफ्त बाजार पर बनाता है, लेकिन फिर आपकी उम्मीदों को तुरंत धराशायी होना चाहिए, क्योंकि इसे जल्द ही कोई अपडेट मिलने की संभावना नहीं है, जब तक कि कोई इसे उठा न ले। क्योंकि इसमें बाजार है, लेकिन Linux दुनिया थकान और उदासीनता के बीच एक कठिन स्थिति में फंसी हुई है।
उसके बावजूद, उम्र और अपडेट की बात को छोड़कर, अधिकांश भाग के लिए, OCRFeeder ने काम किया। रूपांतरण गुणवत्ता खराब नहीं थी, आप UI का उपयोग करके अपना काम करके कुछ भी नहीं खोते हैं, और निर्यात फ़ंक्शन आपको आगे संपादन और ऐसे के लिए अच्छे दस्तावेज़ बनाने देता है। मैं Tesseract में सुधारों से भी खुश हूं। इसलिए यदि आपके पास टेक्स्ट-खुश इमेज का एक गुच्छा है, और आप प्राचीन फॉर्म पर हस्तलिखित टेक्स्ट को कुछ आधुनिक और उपयोग योग्य में बदलने की कोशिश करना चाहते हैं, तो आप यह कर सकते हैं। OCRFeeder PDF के साथ-साथ स्कैनर से सीधे पढ़ने का भी समर्थन करता है। प्रयोग के लायक। अब जाने का समय, अलविदा।
चीयर्स।