प्रकाशित: 30 अप्रैल 2026, 10:30 AM EDT
यासिर एक मैकेनिकल इंजीनियर हैं जो MUO पर टेक के बारे में लिखते हैं, जिसमें विंडोज, प्रोडक्टिविटी, सिक्योरिटी और इंटरनेट शामिल हैं। ऑटोनोमस सिस्टम में उनकी रुचि उन्हें लगातार हार्डवेयर और सॉफ्टवेयर दोनों के साथ टिंकर करने के लिए प्रेरित करती है।
उनकी टेक राइटिंग यात्रा इंजीनियरिंग के जूनियर वर्ष के दौरान शुरू हुई, जिससे वे एंड्रॉइड पुलिस से होते हुए MUO में शामिल हुए। वे टेक्नोलॉजी को सुलभ बनाने पर ध्यान केंद्रित करते हैं, चाहे वह विंडोज की समस्याओं का निवारण करना हो, प्रोडक्टिविटी टूल्स का पता लगाना हो, या सुरक्षा जोखिमों को सरल अंग्रेजी में समझाना हो। यासिर के लिए, ऐसा करने का सबसे अच्छा तरीका है टूल्स का वास्तव में उपयोग करना और उन्हीं समस्याओं का सामना करना जो पाठकों को आती हैं।
जब वे लिख या इंजीनियरिंग नहीं कर रहे होते, तो आप यासिर को इम्प्रैक्टिकल जोकर्स देखते हुए और उन प्रैंक्स पर वास्तव में हंसते हुए पाएंगे जिन्हें उन्होंने दर्जनों बार देखा है।
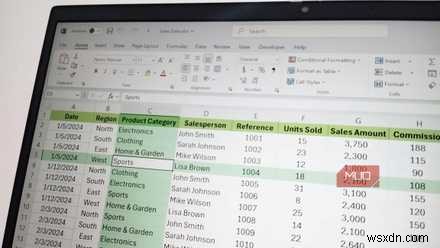
मैं जिन अधिकांश एक्सेल यूजर्स को जानता हूं, उन्होंने फॉर्मूला उसी तरह सीखे जैसे मैंने सीखे — एक बार में एक फंक्शन, जो वे पहले से जानते थे उसके ऊपर स्टैक्ड। डायनामिक ऐरे फंक्शन्स उन स्किल्स को रिप्लेस नहीं करते; वे बस बहुत सारे वर्कअराउंड को अनावश्यक बना देते हैं। मैं कुछ समय से TAKE और DROP के साथ अपने सेल्फ-अपडेटिंग टॉप-फाइव लिस्ट चला रहा हूं, और नीचे दिए गए चार फंक्शन्स के साथ भी वही बदलाव हुआ है। प्रत्येक ने एक मल्टी-स्टेप रूटीन को घटा दिया जिसे मैं रिफ्लेक्सिवली करता था, एक सिंगल फॉर्मूला में।
 संबंधित
FILTER ने हेल्पर कॉलम और ऐरे फॉर्मूला के पूरे अनुष्ठान को रिप्लेस किया
एक फॉर्मूला अब वही करता है जो कई फंक्शन्स मिलकर करते थे
पुराने एक्सेल में मिलती-जुलती पंक्तियों को निकालने का मतलब था नेस्टेड INDEX, MATCH, SMALL, और IFERROR फॉर्मूला बनाना और इसे Ctrl + Shift + Enter से एंटर करना। यह काम करता था, लेकिन बाद में इसे मेंटेन करना एक समस्या थी। दूसरा विकल्प था ऑटोफिल्टर लागू करना, विजिबल पंक्तियों को कॉपी करना, और उन्हें कहीं और स्टैटिक वैल्यू के रूप में पेस्ट करना। यह भी तब तक ठीक था जब तक सोर्स डेटा नहीं बदलता।
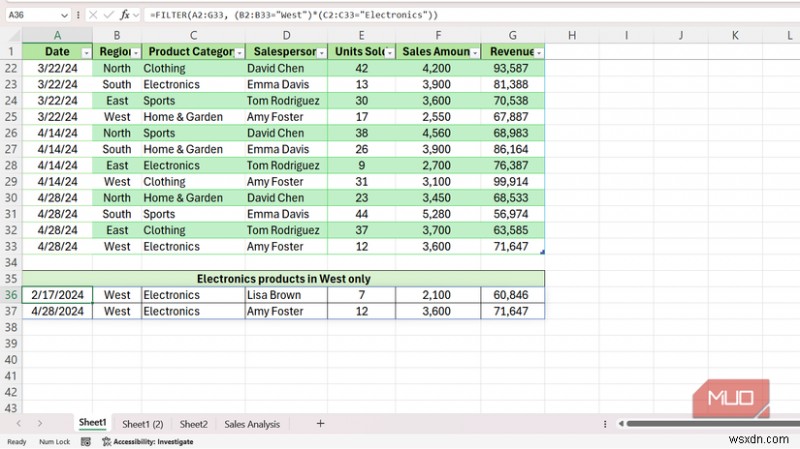
FILTER फंक्शन वही काम एक लाइन में करता है। मेरी सेल्स स्प्रेडशीट में, जिसमें क्षेत्रों, प्रोडक्ट कैटेगरी और सेल्सपर्सन के 32 पंक्तियां हैं, वेस्ट क्षेत्र से हर इलेक्ट्रॉनिक्स सेल को निकालना इस तरह दिखता है:
=FILTER(A2:G33, (B2:B33="West")*(C2:C33="Electronics"))
पहला आर्गुमेंट वह रेंज है जिसे आप रिटर्न करना चाहते हैं। दूसरा कंडीशन है, और दो चेक के बीच मल्टिप्लिकेशन AND की तरह काम करता है — दोनों का सच होना जरूरी है। एस्टेरिस्क को प्लस साइन में बदलने से यह OR बन जाता है, और रिजल्ट ऑटोमैटिकली स्पिल होता है। सोर्स में एक नई पंक्ति जोड़ने से स्पिल्ड आउटपुट उसी क्षण अपडेट हो जाता है जब आप एंटर दबाते हैं।
आप खाली रिजल्ट को हैंडल करने के लिए FILTER को IFERROR के साथ थर्ड आर्गुमेंट में रैप कर सकते हैं। =FILTER(range, condition, "No matches") आपकी शीट को #CALC! एरर दिखाने से रोकता है जब कोई पंक्ति क्वालीफाई नहीं करती।
UNIQUE ने मेरे थ्री-स्टेप डिडुप्लिकेशन रूटीन को सिंगल सेल में बदल दिया
Remove Duplicates अच्छा है, लेकिन इसने कभी खुद को अपडेट नहीं किया
डेटा टैब के तहत Remove Duplicates ऑप्शन वन-टाइम क्लीनअप के लिए ठीक है। समस्या यह है कि यह एक स्टैटिक लिस्ट बनाता है। जब आप किसी कॉलम को नई लोकेशन पर कॉपी करते हैं, डायलॉग चलाते हैं, या रिजल्ट को सॉर्ट करते हैं, तो अगली बार जब कोई पंक्ति जोड़ता है तो आपको यह सब फिर से करना पड़ता है। मैंने ऐसा जितनी बार गिना नहीं जा सकता।
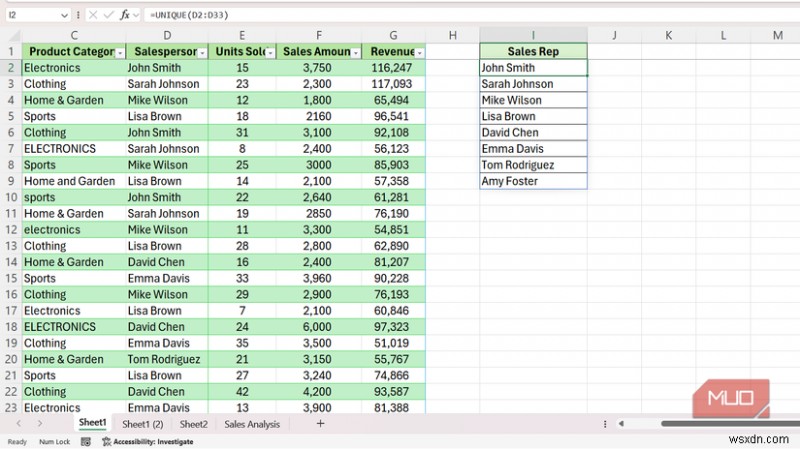
UNIQUE उस हर स्टेप को स्किप कर देता है। इसे मेरी सेल्स स्प्रेडशीट में सेल्सपर्सन कॉलम पर पॉइंट करना इस तरह दिखता है:
=UNIQUE(D2:D33)
रिजल्ट जॉन स्मिथ, सारा जॉनसन, माइक विल्सन, लीसा ब्राउन, डेविड चेन, एम्मा डेविस, टॉम रोड्रिग्ज, और एमी फोस्टर के रूप में स्पिल होता है। वो आठ नाम बिना किसी डायलॉग बॉक्स के। इसे =SORT(UNIQUE(D2:D33)) के रूप में रैप करने से वही लिस्ट अल्फाबेटिकली सॉर्ट होकर मिलती है। आउटपुट सोर्स से जुड़ा रहता है, इसलिए डेटा में नया नाम जोड़ने से स्पिल्ड लिस्ट ऑटोमैटिकली एक्सटेंड हो जाती है।
यह सेटअप डेटा वैलिडेशन ड्रॉपडाउन लिस्ट के लिए एक साफ सोर्स भी बनाता है। यदि आप हैश जैसे D35# के साथ स्पिल्ड रेंज को रेफरेंस करते हैं, तो आपका ड्रॉपडाउन अपने आप बढ़ता है जैसे ही सोर्स डेटा में नए नाम दिखाई देते हैं।
SORTBY ने मेरे कॉपी-पेस्ट-एंड-सॉर्ट शफल को हमेशा के लिए खत्म कर दिया
सोर्स डेटा को छुए बिना एक व्यू को सॉर्ट करना
एक्सेल में सॉर्टिंग हमेशा एक छोटा जोखिम लेकर आती थी। सोर्स को रीअरेंज करने से उन फॉर्मूला के टूटने का खतरा था जो फिक्स्ड पंक्तियों को रेफरेंस करते थे, इसलिए मेरा फॉलबैक था एक चंक को कहीं सुरक्षित कॉपी करना और कॉपी को सॉर्ट करना। SORT ने मदद की, लेकिन केवल तब जब मैं हर कॉलम को डिस्प्ले करने में खुश था जिस पर मैं सॉर्ट कर रहा था।
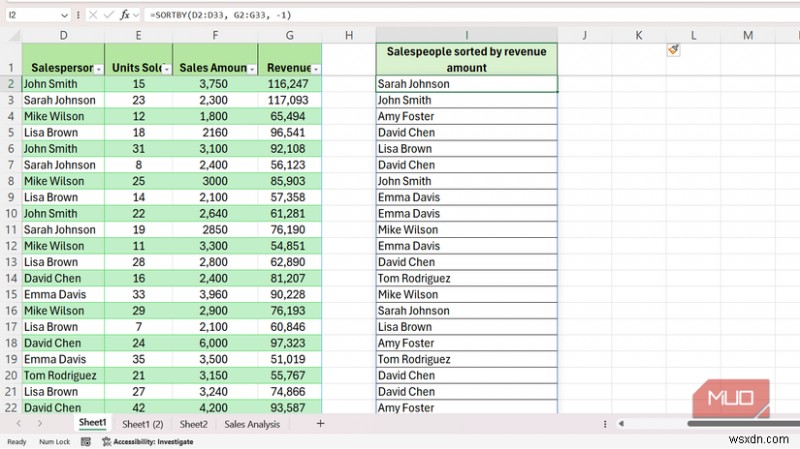
SORTBY उस बाधा को हटा देता है। यह एक रेंज को दूसरी रेंज के वैल्यू का उपयोग करके सॉर्ट करता है, और दूसरी रेंज को आउटपुट में दिखने की जरूरत नहीं होती। मैंने अपने डेटासेट में सेल्सपर्सन को रेवेन्यू के आधार पर रैंक करने के लिए निम्नलिखित फॉर्मूला उपयोग किया:
=SORTBY(D2:D33, G2:G33, -1)
पहला आर्गुमेंट वह है जो आप रिटर्न चाहते हैं (सेल्सपर्सन), दूसरा वह है जिसके द्वारा सॉर्ट करना है (सेल्स रेवेन्यू), और -1 ऑर्डर को डिसेंडिंग सेट करता है। नाम हाईएस्ट सेल्स अमाउंट से लोएस्ट तक रैंक होकर वापस आते हैं, और सेल्स अमाउंट कॉलम आउटपुट में तब तक नहीं दिखाई देता जब तक आप इसके लिए न कहें।
यह FILTER के साथ भी साफ-साफ जुड़ता है। FILTER(D2:G33, B2:B33="North") को SORTBY के अंदर रैप करने से केवल नॉर्थ क्षेत्र के रिकॉर्ड हाई टू लो सॉर्ट होकर एक शॉट में वापस आ जाते हैं। सोर्स डेटा अनटच्ड रहता है।
SORTBY मल्टीपल सॉर्ट लेवल स्वीकार करता है। आप क्षेत्र के अनुसार पहले सॉर्ट करने के लिए, फिर प्रत्येक क्षेत्र के भीतर सेल्स रेवेन्यू के अनुसार अधिक रेंज/ऑर्डर पेयर जोड़ सकते हैं।
SEQUENCE ने फिल हैंडल और ROW ट्रिक्स को रिप्लेस किया जिन पर मुझे गर्व था
एक भी सेल को ड्रैग किए बिना एक सीरीज जनरेट करना
एक नंबर वाली सीरीज जनरेट करने का मतलब था फिल हैंडल को तब तक ड्रैग करना जब तक धैर्य खत्म न हो जाए या =ROW(A1) लिखना और इसे नीचे कॉपी करना। दोनों काम करते हैं, लेकिन जब अंडरलाइंग डेटा बदलता है तो कोई भी रिसाइज नहीं होता।
SEQUENCE वही काम एक सिंगल सेल में करता है, और यह आर्गुमेंट्स के आधार पर पंक्तियां, कॉलम या फुल ग्रिड जनरेट करता है। सिंटैक्स है:
=SEQUENCE(rows, [columns], [start], [step])
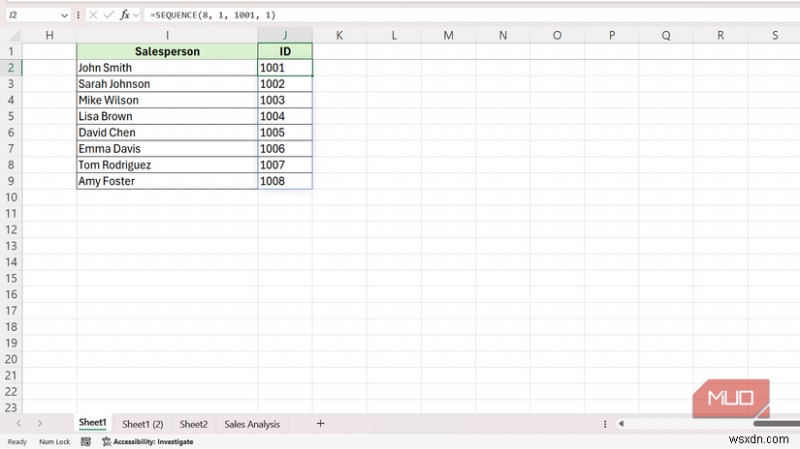
मेरे डेटा में आठ यूनिक सेल्सपर्सन को 1001 से शुरू करके नंबर देने के लिए, मैंने निम्नलिखित फॉर्मूला उपयोग किया:
=SEQUENCE(8, 1, 1001, 1)
यह 1001 से 1008 तक एक सिंगल कॉलम में रिटर्न करता है। कॉलम को 1 और स्टेप को 1 पर सेट करने से यह क्रमागत इंटीजर के साथ एक वर्टिकल लिस्ट के रूप में रहता है। जहां SEQUENCE अपनी जगह बनाता है वह अन्य फंक्शन्स के अंदर है। जनवरी 2026 के लिए 31-दिन की डेट रेंज बनाने में एक फॉर्मूला लगता है:
=DATE(2026, 1, SEQUENCE(31))
स्पिल्ड ऐरे को TEXT, INDEX, या किसी अन्य फंक्शन में फीड करना जो एक रेंज की उम्मीद करता है, उसे कॉलप्स कर देता है जिसे पहले एक हेल्पर कॉलम की जरूरत होती थी। मैंने इसे और विस्तार से कवर किया था जब मैंने SEQUENCE का उपयोग करके डेट कॉलम भरने के बारे में लिखा था, और यह अभी भी मेरे द्वारा बनाए गए हर कैलेंडर या शेड्यूल पर समय बचाता है।
वे फंक्शन्स जिन्हें मैं आगे एक्सप्लोर करना चाहता हूं
पुराने तरीकों में से कोई भी टूटा नहीं है। वे बस अधिक समय लेते हैं और ऐसी फाइलें बनाते हैं जिन्हें मेंटेन करना मेरे और किसी अन्य के लिए कठिन होता है जो बाद में वर्कबुक खोलता है। मेरे लिए, बदलाव यह है कि मैं डिफ़ॉल्ट रूप से किस चीज के लिए पहुंचता हूं। नई स्प्रेडशीट डायनामिक ऐरे थिंकिंग से शुरू होती हैं, और पुराना टूलबॉक्स केवल तब निकलता है जब मैं किसी और की फाइल एडिट कर रहा होता हूं। अगला मेरी लिस्ट में TEXTSPLIT है स्ट्रिंग्स को तोड़ने के लिए, VSTACK और HSTACK रेंज को कंबाइन करने के लिए, और PIVOTBY और GROUPBY पिवट टेबल को पूरी तरह से स्किप करने के लिए। प्रत्येक रिलीज एक और आदत को रिटायर करती हुई लगती है, जो मुझे ठीक लगती है।