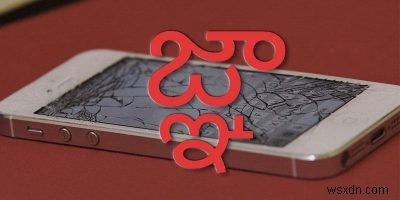
पिछले कुछ महीनों से एप्पल बग्स से जूझ रहा है। अब आईफोन के टेक्स्ट-रेंडरिंग फंक्शनैलिटी में एक नया, गंभीर बग सामने आया है। यह बग एक अकेले तेलुगू वर्ण द्वारा ट्रिगर होता है, जो केवल उस वर्ण वाली नोटिफिकेशन प्राप्त करने पर आईफोन को एक अनब्रेकेबल बूट लूप में डाल सकता है। आइए समझते हैं कि एक अकेला वर्ण iOS में इतनी बड़ी समस्याएं कैसे पैदा कर सकता है।
नोट: तेलुगू बग का फिक्स iOS के नवीनतम संस्करण (11.2.6) में उपलब्ध है। यदि तेलुगू वर्ण ने आपके ऐप या डिवाइस को लॉक कर दिया है, तो iTunes के माध्यम से अपने आईफोन को रिस्टोर करें और iOS के नवीनतम संस्करण में अपडेट करें। यदि आपका आईफोन बूट लूप में फंस गया है, तो iTunes से पहचाने जाने के लिए आपको इसे डिवाइस फर्मवेयर अपडेट (DFU) स्टेट में डालने की आवश्यकता हो सकती है। पूरा होने पर, अपने डिवाइस को अपने सबसे हाल के बैकअप से रिस्टोर करें, जो उम्मीद है आपने बनाया होगा।
तेलुगू क्या है?
तेलुगू भारत के कुछ हिस्सों में बोली और लिखी जाने वाली एक भाषा है, विशेष रूप से आंध्र प्रदेश, तेलंगाना और यानम शहर में। अरबी और अन्य ब्राह्मी लिपियों जैसी कई लिपि-आधारित भाषाओं की तरह, तेलुगू अपने वर्णों को कंप्यूटर स्क्रीन पर प्रदर्शित करने के लिए यूनिकोड वर्ण सेट की कुछ विशेष सुविधाओं का उपयोग करता है।
जहां अधिकांश लैटिन अक्षरों को ASCII कम्पैटिबिलिटी के लिए सिंगल 8-बिट यूनिकोड कोड पॉइंट द्वारा दर्शाया जाता है (उदाहरण के लिए, अक्षर A यूनिकोड कोड पॉइंट U+0041 पर मौजूद है, जिसे बाइनरी में 01000001 द्वारा दर्शाया जाता है), वहीं लिपि या गैर-लैटिन अक्षरों में लिखी जाने वाली भाषाएं आमतौर पर अपने वर्णों को दर्शाने के लिए एक से अधिक यूनिकोड कोड पॉइंट्स को जोड़ती हैं।
यह विशेष रूप से उन भाषाओं के लिए सच है, जैसे तेलुगू, जो भाषाओं के अक्षरों के संस्करणों को क्लस्टर्स में जोड़ती हैं। अंग्रेजी के स्टाइलिस्टिक लिगेचर्स के विपरीत, प्रत्येक तेलुगू अक्षर के बीच का संबंध भाषाई रूप से महत्वपूर्ण है। इसे समायोजित करने के लिए, यूनिकोड में वर्णों को जोड़ने की एक जटिल प्रणाली शामिल है, जिनमें से प्रत्येक को अपने स्वयं के कोड पॉइंट द्वारा दर्शाया जाता है।
यूनिकोड कोड पॉइंट्स की भारी संख्या को देखते हुए, यह निकट-अनंत विविधता पैदा कर सकता है। ये पॉइंट्स एक साथ मिलकर एक पठनीय वर्ण प्रस्तुत करते हैं। इस तरह यूनिकोड को वस्तुतः हर संभावित तेलुगू शब्द के लिए एक यूनिकोड कोड पॉइंट की आवश्यकता नहीं होती। इसके बजाय, यूनिकोड तेलुगू व्यंजनों, स्वरों और डायक्रिटिक्स ("विराम") को एक साथ जोड़कर ऐसे शब्द बनाता है जो एक अकेले वर्ण की तरह प्रदर्शित होते हैं। यही बात लिगेचर्स के लिए ऑर्थोग्राफिक नियमों वाली अन्य भाषाओं, जैसे अरबी, पर भी लागू होती है।
क्रैश का कारण क्या है?
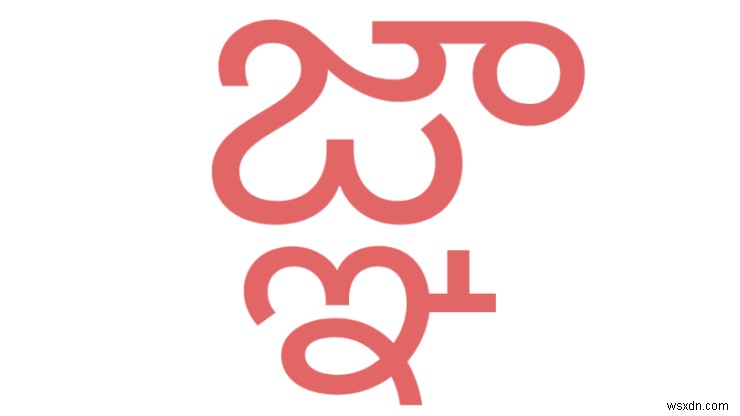
समस्या जीरो विड्थ नॉन-जॉइनर (ZWNJ) से संबंधित प्रतीत होती है, जो कोड पॉइंट U+200C पर है। ZWNJ अनुरोध करता है कि दो आसन्न वर्ण अपने विशिष्ट लिगेचर के बिना रेंडर हों। अंग्रेजी में, ZWNJ वर्णों ff को उनके मानक कनेक्शन लिगेचर के साथ प्रिंट होने से रोकता है, इसके बजाय प्रत्येक f को अलग करता है। लेकिन जब चार विशिष्ट तेलुगू कोड पॉइंट्स के एक विशिष्ट सेट (जिन्हें सभी को एक ही क्लस्टर में जोड़ना चाहिए) के साथ जोड़ा जाता है, तो किसी कारण से iOS परिणाम को ठीक से प्रदर्शित नहीं कर पाता।
कुछ ने अनुमान लगाया है कि एप्पल का सैन फ्रांसिस्को फॉन्ट वर्ण प्रदर्शित नहीं कर सकता, जबकि अन्य ने कहा है कि एप्पल द्वारा उपयोग की जाने वाली विशिष्ट रेंडरिंग प्रक्रिया दोषी है। सटीक कारण जो भी हो, वर्ण को रेंडर करने का प्रयास उसे रेंडर करने वाले किसी भी चीज़ का नाटकीय क्रैश का कारण बनता है, मैसेजेस और व्हाट्सऐप से लेकर स्प्रिंगबोर्ड तक। वर्ण को बनाने वाले यूनिकोड कोड पॉइंट्स ("ज्ञा" जिसका अर्थ "ज्ञान" है) नीचे दिए गए हैं:
U+0C1Cज ( )
U+0C4Dएक विराम, या डायक्रिटिक चिह्न ( )
U+0C1Eञ ( )
U+200Cजीरो विड्थ नॉन-जॉइनर्सU+0C3Eा ( )
लेकिन हम केवल जीरो विड्थ नॉन-जॉइनर (ZWNJ) को दोष नहीं दे सकते। इसका उपयोग निर्दोष फैमिली इमोजी (????) में भी बिना किसी समस्या के किया जाता है। यह कुछ विशिष्ट कोड पॉइंट्स और ZWNJ के विशिष्ट संयोजन की तरह लगता है। चोट पर नमक छिड़कते हुए, ऐसा लगता है कि ZWNJ का या तो इस तेलुगू क्लस्टर के रेंडरिंग पर कोई विशेष प्रभाव नहीं पड़ता या यह पहली जगह में वहां होना ही नहीं चाहिए।
अन्य ब्राह्मी लिपि समस्याएं
हालांकि, तेलुगू अकेली भाषा नहीं है जिसमें यह समस्या है। बंगाली और देवनागरी, जो अपनी ब्राह्मी लिपियों के लिए यूनिकोड का समान तरीके से उपयोग करते हैं, को भी यही समस्या है। मनीष गोरगांवकर एक आकर्षक और विस्तृत ब्लॉग पोस्ट लिखते हैं जो सटीक क्रैश केस को और भी आगे तोड़ता है:
देवनागरी, बंगाली, और तेलुगू में कोई भी अनुक्रम
<व्यंजन1, विराम, व्यंजन2, ZWNJ, स्वर>जहां:1.
व्यंजन2सफ़िक्स-जॉइनिंग है (pstf/vatu)
2.व्यंजन1रेफ-फॉर्मिंग अक्षर नहीं है
3.स्वरमें दो ग्लिफ़ घटक नहीं हैं
निष्कर्ष: एप्पल ने इसे क्यों नहीं पकड़ा?
यह समझने के लिए कि यह बग कैसे छूट गया, आपको एप्पल की जगह खुद को रखना होगा। निश्चित रूप से, यह वर्ण संयोजन तेलुगू भाषा में कोई सुपर अस्पष्ट शब्द नहीं है। लेकिन आईफोन दर्जनों भाषाओं का समर्थन करता है। यूनिकोड में वस्तुतः अरबों संभावित संयोजन हैं। उस विविधता के साथ, रिलीज से पहले यूनिकोड बग्स के लिए सार्थक परीक्षण नियमित सॉफ़्टवेयर अपडेट को मूल रूप से असंभव बना देगा।
हालांकि, त्रुटि को इतना नुकसान नहीं पहुंचाना चाहिए था। टेक्स्ट मैसेज की सामग्री के आधार पर फोन ब्रिक नहीं होने चाहिए। जबकि हिंडसाइट निश्चित रूप से 20/20 है, ऐसा लगता है कि वर्ण को प्रश्न चिह्न बॉक्स () के रूप में रेंडर करना स्प्रिंगबोर्ड को क्रैश करने से बेहतर होता।