कन्वोल्यूशनल न्यूरल नेटवर्क बनाने से लेकर iOS पर OCR तैनात करने तक
परियोजना के लिए प्रेरणा ✍️ ??
कुछ महीने पहले जब मैं MNIST डेटासेट के लिए डीप लर्निंग मॉडल बनाना सीख रहा था, तो मैंने एक iOS ऐप बना डाला जो हस्तलिखित अक्षरों को पहचानता था।
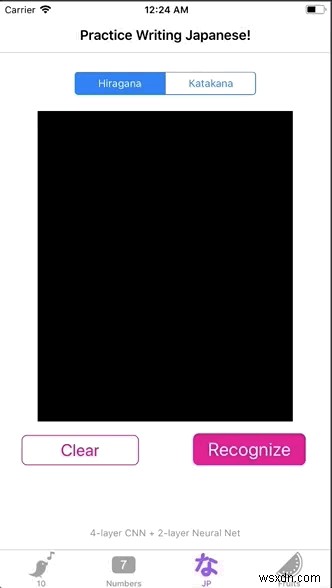
मेरे दोस्त Kaichi Momose एक जापानी भाषा सीखने वाला ऐप, Nukon विकसित कर रहे थे। उन्होंने संयोग से इसमें एक समान सुविधा चाही। फिर हमने एक अंक पहचानने वाले से अधिक परिष्कृत कुछ बनाने के लिए सहयोग किया: जापानी अक्षरों (हिरागाना और कताकाना) के लिए एक OCR (ऑप्टिकल कैरेक्टर रिकग्निशन/रीडर)।

Nukon के विकास के दौरान, जापानी में हैंडराइटिंग रिकग्निशन के लिए कोई API उपलब्ध नहीं था। हमारे पास अपना OCR बनाने के अलावा कोई विकल्प नहीं था। स्क्रैच से एक बनाने का सबसे बड़ा लाभ यह था कि हमारा ऑफ़लाइन काम करता है। उपयोगकर्ता इंटरनेट के बिना पहाड़ों में गहरे हो सकते हैं और फिर भी Nukon खोलकर जापानी सीखने की अपनी दैनिक दिनचर्या बनाए रख सकते हैं। हमने इस प्रक्रिया के दौरान बहुत कुछ सीखा, लेकिन अधिक महत्वपूर्ण बात यह है कि हम अपने उपयोगकर्ताओं के लिए एक बेहतर उत्पाद भेजकर रोमांचित थे।
यह लेख जापानी OCR को iOS ऐप्स के लिए कैसे बनाया गया, इसकी प्रक्रिया को तोड़ देगा। जो अन्य भाषाओं/प्रतीकों के लिए एक बनाना चाहते हैं, वे डेटासेट बदलकर इसे अनुकूलित करने के लिए स्वतंत्र महसूस कर सकते हैं।
बिना किसी देरी के, आइए देखें कि क्या कवर किया जाएगा:
भाग 1️⃣: डेटासेट प्राप्त करें और छवियों को प्रीप्रोसेस करें
भाग 2️⃣: CNN (कन्वोल्यूशनल न्यूरल नेटवर्क) बनाएं और प्रशिक्षित करें
भाग 3️⃣: प्रशिक्षित मॉडल को iOS में एकीकृत करें
डेटासेट प्राप्त करें और छवियों को प्रीप्रोसेस करें ?
डेटासेट ETL कैरेक्टर डेटाबेस से आता है, जिसमें हस्तलिखित अक्षरों और प्रतीकों की छवियों के नौ सेट हैं। चूंकि हम हिरागाना के लिए OCR बनाने जा रहे हैं, ETL8 वह डेटासेट है जिसका हम उपयोग करेंगे।
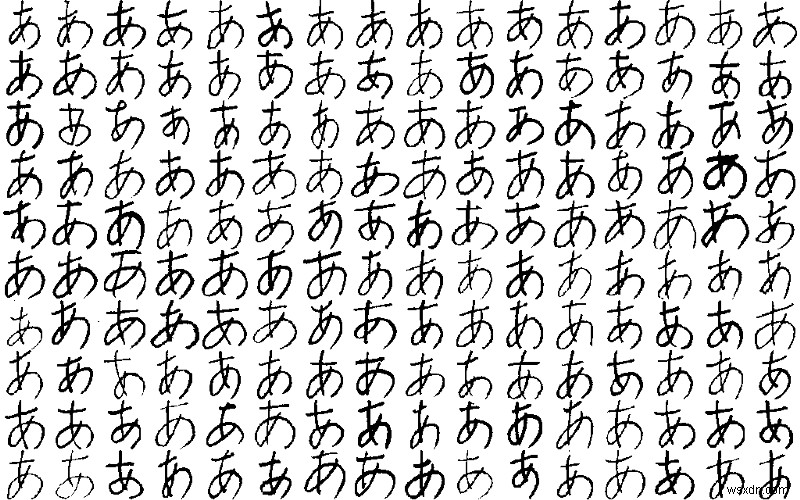
डेटाबेस से छवियां प्राप्त करने के लिए, हमें कुछ हेल्पर फ़ंक्शन्स की आवश्यकता है जो छवियों को पढ़ते हैं और उन्हें .npz फॉर्मेट में संग्रहीत करते हैं।
import struct import numpy as np from PIL import Image sz_record = 8199 def read_record_ETL8G(f): s = f.read(sz_record) r = struct.unpack('>2H8sI4B4H2B30x8128s11x', s) iF = Image.frombytes('F', (128, 127), r[14], 'bit', 4) iL = iF.convert('L') return r + (iL,) def read_hiragana(): # कैरेक्टर प्रकार = 70, व्यक्ति = 160, y = 127, x = 128 ary = np.zeros([71, 160, 127, 128], dtype=np.uint8) for j in range(1, 33): filename = '../../ETL8G/ETL8G_{:02d}'.format(j) with open(filename, 'rb') as f: for id_dataset in range(5): moji = 0 for i in range(956): r = read_record_ETL8G(f) if b'.HIRA' in r[2] or b'.WO.' in r[2]: if not b'KAI' in r[2] and not b'HEI' in r[2]: ary[moji, (j - 1) * 5 + id_dataset] = np.array(r[-1]) moji += 1 np.savez_compressed("hiragana.npz", ary)एक बार हमारे पास hiragana.npz सेव हो जाने पर, फ़ाइल लोड करके और छवि आयामों को 32x32 पिक्सल में रीशेप करके छवियों को प्रोसेस करना शुरू करें। हम अतिरिक्त छवियां उत्पन्न करने के लिए डेटा ऑग्मेंटेशन भी जोड़ेंगे जो घुमाई गई और ज़ूम की गई हैं। जब हमारा मॉडल विभिन्न कोणों से कैरेक्टर छवियों पर प्रशिक्षित होता है, तो हमारा मॉडल लोगों की लिखावट के लिए बेहतर अनुकूल हो सकता है।
import scipy.misc from keras.layers import Conv2D, MaxPooling2D from keras.layers import Dense, Dropout, Activation, Flatten from keras.models import Sequential from keras.preprocessing.image import ImageDataGenerator from keras.utils import np_utils from sklearn.model_selection import train_test_split # 71 अक्षर nb_classes = 71 # इनपुट छवि आयाम img_rows, img_cols = 32, 32 ary = np.load("hiragana.npz")['arr_0'].reshape([-1, 127, 128]).astype(np.float32) / 15 X_train = np.zeros([nb_classes * 160, img_rows, img_cols], dtype=np.float32) for i in range(nb_classes * 160): X_train[i] = scipy.misc.imresize(ary[i], (img_rows, img_cols), mode='F') y_train = np.repeat(np.arange(nb_classes), 160) X_train, X_test, y_train, y_test = train_test_split(X_train, y_train, test_size=0.2) # क्लास वेक्टर्स को श्रेणीबद्ध मैट्रिक्स में बदलें y_train = np_utils.to_categorical(y_train, nb_classes) y_test = np_utils.to_categorical(y_test, nb_classes) # डेटा ऑग्मेंटेशन datagen = ImageDataGenerator(rotation_range=15, zoom_range=0.20) datagen.fit(X_train)CNN बनाएं और प्रशिक्षित करें ?️
अब मजेदार हिस्सा आता है! हम Keras का उपयोग करके अपने मॉडल के लिए CNN (कन्वोल्यूशनल न्यूरल नेटवर्क) का निर्माण करेंगे। जब मैंने पहली बार मॉडल बनाया, तो मैंने हाइपर-पैरामीटर्स के साथ प्रयोग किया और उन्हें कई बार ट्यून किया। नीचे दिया गया संयोजन मुझे उच्चतम सटीकता - 98.77% देगा। स्वयं विभिन्न पैरामीटर्स के साथ खेलने के लिए स्वतंत्र महसूस करें।
model = Sequential() def model_6_layers(): model.add(Conv2D(32, 3, 3, input_shape=input_shape)) model.add(Activation('relu')) model.add(Conv2D(32, 3, 3)) model.add(Activation('relu')) model.add(MaxPooling2D(pool_size=(2, 2))) model.add(Dropout(0.5)) model.add(Conv2D(64, 3, 3)) model.add(Activation('relu')) model.add(Conv2D(64, 3, 3)) model.add(Activation('relu')) model.add(MaxPooling2D(pool_size=(2, 2))) model.add(Dropout(0.5)) model.add(Flatten()) model.add(Dense(256)) model.add(Activation('relu')) model.add(Dropout(0.5)) model.add(Dense(nb_classes)) model.add(Activation('softmax')) model_6_layers() model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy']) model.fit_generator(datagen.flow(X_train, y_train, batch_size=16), samples_per_epoch=X_train.shape[0], nb_epoch=30, validation_data=(X_test, y_test))यदि आपको प्रशिक्षण चरण में मॉडल का प्रदर्शन असंतोषजनक लगता है तो यहां कुछ सुझाव दिए गए हैं:
मॉडल ओवरफिटिंग कर रहा है
इसका मतलब है कि मॉडल अच्छी तरह से सामान्यीकृत नहीं है। सहज स्पष्टीकरण के लिए इस लेख को देखें।
ओवरफिटिंग का पता कैसे लगाएं: प्रशिक्षण प्रक्रिया में acc (सटीकता) बढ़ती रहती है, लेकिन val_acc (वैलिडेशन सटीकता) विपरीत करती है।
ओवरफिटिंग के कुछ समाधान: नियमितीकरण (उदा. ड्रॉपआउट्स), डेटा ऑग्मेंटेशन, डेटासेट की गुणवत्ता में सुधार
यह कैसे जानें कि मॉडल "सीख" रहा है
यदि प्रशिक्षण जारी रहने पर val_loss (वैलिडेशन लॉस) बढ़ता है या घटता नहीं है तो मॉडल नहीं सीख रहा है।
TensorBoard का उपयोग करें - यह समय के साथ मॉडल प्रदर्शन के लिए विज़ुअलाइज़ेशन प्रदान करता है। यह हर एक युग को देखने और लगातार मानों की तुलना करने के थकाऊ कार्य से छुटकारा दिलाता है।
जैसे ही हम अपनी सटीकता से संतुष्ट होते हैं, सेव करने से पहले वेट्स और मॉडल कॉन्फ़िगरेशन को फ़ाइल के रूप में ड्रॉपआउट लेयर्स को हटा देते हैं।
for k in model.layers: if type(k) is keras.layers.Dropout: model.layers.remove(k) model.save('hiraganaModel.h5')iOS भाग पर जाने से पहले एकमात्र शेष कार्य hiraganaModel.h5 को CoreML मॉडल में बदलना है।
import coremltools output_labels = [ 'あ', 'い', 'う', 'え', 'お', 'か', 'く', 'こ', 'し', 'せ', 'た', 'つ', 'と', 'に', 'ね', 'は', 'ふ', 'ほ', 'み', 'め', 'や', 'ゆ', 'よ', 'ら', 'り', 'る', 'わ', 'が', 'げ', 'じ', 'ぞ', 'だ', 'ぢ', 'づ', 'で', 'ど', 'ば', 'び', 'ぶ', 'べ', 'ぼ', 'ぱ', 'ぴ', 'ぷ', 'ぺ', 'ぽ', 'き', 'け', 'さ', 'す', 'そ', 'ち', 'て', 'な', 'ぬ', 'の', 'ひ', 'へ', 'ま', 'む', 'も', 'れ', 'を', 'ぎ', 'ご', 'ず', 'ぜ', 'ん', 'ぐ', 'ざ', 'ろ'] scale = 1/255. coreml_model = coremltools.converters.keras.convert('./hiraganaModel.h5', input_names='image', image_input_names='image', output_names='output', class_labels= output_labels, image_scale=scale) coreml_model.author = 'Your Name' coreml_model.license = 'MIT' coreml_model.short_description = 'हस्तलेखन से हिरागाना कैरेक्टर का पता लगाएं' coreml_model.input_description['image'] = 'हस्तलिखित अक्षर वाली ग्रेस्केल छवि' coreml_model.output_description['output'] = 'हिरागाना में एक अक्षर आउटपुट करें' coreml_model.save('hiraganaModel.mlmodel')output_labels वे सभी संभावित आउटपुट हैं जिन्हें हम बाद में iOS में देखेंगे।
मजेदार तथ्य: यदि आप जापानी समझते हैं, तो आप जानते होंगे कि आउटपुट अक्षरों का क्रम हिरागाना के "वर्णमाला क्रम" से मेल नहीं खाता। हमें यह महसूस करने में कुछ समय लगा कि ETL8 में छवियां "वर्णमाला क्रम" में नहीं थीं (काइची को इसका एहसास कराने के लिए धन्यवाद)। डेटासेट एक जापानी विश्वविद्यालय द्वारा संकलित किया गया था, हालांकि...?
प्रशिक्षित मॉडल को iOS में एकीकृत करें ?
हम अंत में सब कुछ एक साथ रख रहे हैं! hiraganaModel.mlmodel को Xcode प्रोजेक्ट में ड्रैग और ड्रॉप करें। फिर आप ऐसा कुछ देखेंगे:
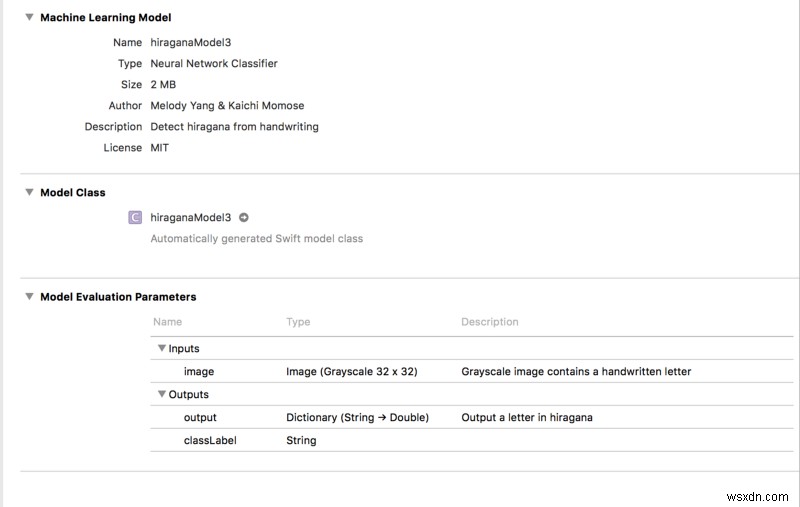
नोट: मॉडल कॉपी करने पर Xcode एक वर्कस्पेस बनाएगा। हमें अपने कोडिंग वातावरण को वर्कस्पेस पर स्विच करना होगा अन्यथा ML मॉडल काम नहीं करेगा!
अंतिम लक्ष्य एक छवि पास करके हमारे हिरागाना मॉडल से एक अक्षर की भविष्यवाणी करना है। इसे प्राप्त करने के लिए, हम एक साधारण UI बनाएंगे ताकि उपयोगकर्ता लिख सके, और हम उपयोगकर्ता के लेखन को छवि प्रारूप में संग्रहीत करेंगे। अंत में, हम छवि के पिक्सेल मान प्राप्त करेंगे और उन्हें हमारे मॉडल में फीड करेंगे।
आइए इसे चरण दर चरण करें:
UIViewपरUIBezierPathके साथ "ड्रा" अक्षर
import UIKit class viewController: UIViewController { @IBOutlet weak var canvas: UIView! var path = UIBezierPath() var startPoint = CGPoint() var touchPoint = CGPoint() override func viewDidLoad() { super.viewDidLoad() canvas.clipsToBounds = true canvas.isMultipleTouchEnabled = true } override func touchesBegan(_ touches: Set<UITouch>, with event: UIEvent?) { let touch = touches.first if let point = touch?.location(in: canvas) { startPoint = point } } override func touchesMoved(_ touches: Set<UITouch>, with event: UIEvent?) { let touch = touches.first if let point = touch?.location(in: canvas) { touchPoint = point } path.move(to: startPoint) path.addLine(to: touchPoint) startPoint = touchPoint draw() } func draw() { let strokeLayer = CAShapeLayer() strokeLayer.fillColor = nil strokeLayer.lineWidth = 8 strokeLayer.strokeColor = UIColor.orange.cgColor strokeLayer.path = path.cgPath canvas.layer.addSublayer(strokeLayer) } // व्यू में ड्राइंग साफ़ करें @IBAction func clearPressed(_ sender: UIButton) { path.removeAllPoints() canvas.layer.sublayers = nil canvas.setNeedsDisplay() } }strokeLayer.strokeColor कोई भी रंग हो सकता है। हालांकि, canvas का बैकग्राउंड रंग काला होना चाहिए। यद्यपि हमारे प्रशिक्षण छवियों में सफेद बैकग्राउंड और काले स्ट्रोक हैं, ML मॉडल इस शैली वाले इनपुट छवि पर अच्छी तरह से प्रतिक्रिया नहीं करता है।
2. UIView को UIImage में बदलें और CVPixelBuffer के साथ पिक्सेल मान प्राप्त करें
एक्सटेंशन में दो हेल्पर फ़ंक्शन्स हैं। साथ में, वे छवियों को पिक्सेल बफर में अनुवाद करते हैं, जो पिक्सेल मानों के बराबर है। इनपुट width और height दोनों 32 होने चाहिए क्योंकि हमारे मॉडल के इनपुट आयाम 32 बाय 32 पिक्सेल हैं।
जैसे ही हमारे पास pixelBuffer होता है, हम model.prediction() को कॉल कर सकते हैं और pixelBuffer पास कर सकते हैं। और वहां हम जाते हैं! हमें classLabel का आउटपुट मिल सकता है!
@IBAction func recognizePressed(_ sender: UIButton) { // व्यू को इमेज में बदलें let resultImage = UIImage.init(view: canvas) let pixelBuffer = resultImage.pixelBufferGray(width: 32, height: 32) let model = hiraganaModel3() // एक हिरागाना अक्षर आउटपुट करें let output = try? model.prediction(image: pixelBuffer!) print(output?.classLabel) } extension UIImage { // छवि को चौड़ाई x ऊंचाई में रीसाइज़ करता है और इसे ग्रेस्केल CVPixelBuffer में बदलता है func pixelBufferGray(width: Int, height: Int) -> CVPixelBuffer? { return _pixelBuffer(width: width, height: height, pixelFormatType: kCVPixelFormatType_OneComponent8, colorSpace: CGColorSpaceCreateDeviceGray(), alphaInfo: .none) } func _pixelBuffer(width: Int, height: Int, pixelFormatType: OSType, colorSpace: CGColorSpace, alphaInfo: CGImageAlphaInfo) -> CVPixelBuffer? { var maybePixelBuffer: CVPixelBuffer? let attrs = [kCVPixelBufferCGImageCompatibilityKey: kCFBooleanTrue, kCVPixelBufferCGBitmapContextCompatibilityKey: kCFBooleanTrue] let status = CVPixelBufferCreate(kCFAllocatorDefault, width, height, pixelFormatType, attrs as CFDictionary, &maybePixelBuffer) guard status == kCVReturnSuccess, let pixelBuffer = maybePixelBuffer else { return nil } CVPixelBufferLockBaseAddress(pixelBuffer, CVPixelBufferLockFlags(rawValue: 0)) let pixelData = CVPixelBufferGetBaseAddress(pixelBuffer) guard let context = CGContext(data: pixelData, width: width, height: height, bitsPerComponent: 8, bytesPerRow: CVPixelBufferGetBytesPerRow(pixelBuffer), space: colorSpace, bitmapInfo: alphaInfo.rawValue) else { return nil } UIGraphicsPushContext(context) context.translateBy(x: 0, y: CGFloat(height)) context.scaleBy(x: 1, y: -1) self.draw(in: CGRect(x: 0, y: 0, width: width, height: height)) UIGraphicsPopContext() CVPixelBufferUnlockBaseAddress(pixelBuffer, CVPixelBufferLockFlags(rawValue: 0)) return pixelBuffer } }3. UIAlertController के साथ आउटपुट दिखाएं
यह चरण पूरी तरह से वैकल्पिक है। शुरुआत में GIF में दिखाया गया है, मैंने परिणाम सूचित करने के लिए एक अलर्ट कंट्रोलर जोड़ा।
func informResultPopUp(message: String) { let alertController = UIAlertController(title: message, message: nil, preferredStyle: .alert) let ok = UIAlertAction(title: "Ok", style: .default, handler: { action in self.dismiss(animated: true, completion: nil) }) alertController.addAction(ok) self.present(alertController, animated: true) { () in } }वोइला! हमने बस एक OCR बनाया जो डेमो-रेडी (और ऐप-स्टोर-रेडी) है! ??
निष्कर्ष ?
OCR बनाना इतना कठिन नहीं है। जैसा कि आपने देखा, इस लेख में चरण और समस्याएं शामिल हैं जिनका मैंने इस प्रोजेक्ट को बनाते समय सामना किया। मैंने Python कोड के एक समूह को iOS से जोड़कर प्रदर्शन योग्य बनाने की प्रक्रिया का आनंद लिया, और मैं ऐसा करना जारी रखने का इरादा रखता हूं।
मुझे आशा है कि यह लेख उन लोगों के लिए कुछ उपयोगी जानकारी प्रदान करता है जो OCR बनाना चाहते हैं लेकिन उन्हें कोई सुराग नहीं है कि कहां से शुरू करें।
आप सोर्स कोड यहां . पा सकते हैं।
बोनस: यदि आप उथले एल्गोरिदम के साथ प्रयोग करने में रुचि रखते हैं, तो पढ़ते रहें!
[वैकल्पिक] उथले एल्गोरिदम के साथ प्रशिक्षण ?
CNN लागू करने से पहले, काइची और मैंने अन्य मशीन लर्निंग एल्गोरिदम का परीक्षण किया यह पता लगाने के लिए कि क्या वे काम कर सकते हैं (और हमें कुछ कंप्यूटिंग लागत बचा सकते हैं!)। हमने KNN और रैंडम फॉरेस्ट को चुना।
उनके प्रदर्शन का मूल्यांकन करने के लिए, हमने अपनी बेसलाइन सटीकता को 1/71 = 0.014 परिभाषित किया।
हमने मान लिया कि जापानी भाषा के किसी भी ज्ञान के बिना एक व्यक्ति के पास एक अक्षर को सही ढंग से अनुमान लगाने का 1.4% मौका होगा।
इस प्रकार, मॉडल अच्छा कर रहा होगा यदि उसकी सटीकता 1.4% से अधिक हो सके। आइए देखें कि क्या ऐसा था। ?
KNN
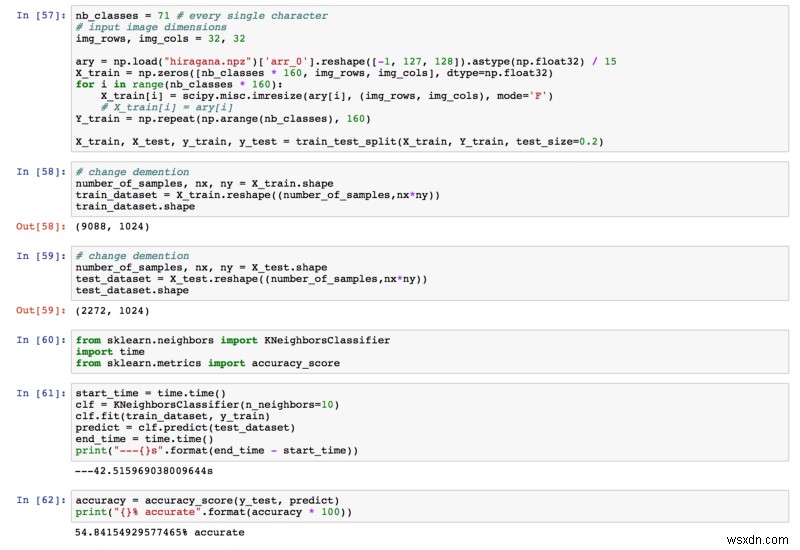
अंतिम सटीकता हमें 54.84% मिली। 1.4% से कहीं अधिक पहले से ही!
रैंडम फॉरेस्ट
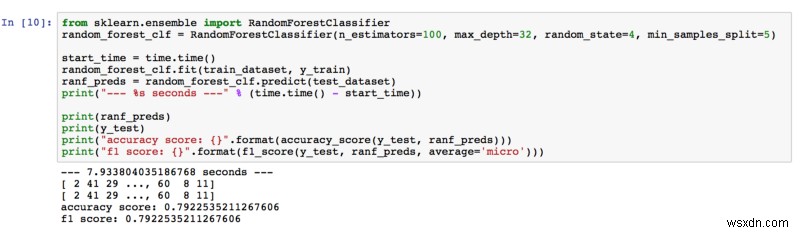
79.23% की सटीकता, इसलिए रैंडम फॉरेस्ट ने हमारी अपेक्षाओं को पार कर लिया। हाइपर-पैरामीटर्स को ट्यून करते समय, हमने अनुमानकों की संख्या और पेड़ों की गहराई बढ़ाकर बेहतर परिणाम प्राप्त किए। हमने सोचा कि वन में अधिक पेड़ (अनुमानक) होने का मतलब छवि में अधिक विशेषताएं सीखी गईं। साथ ही, पेड़ जितना गहरा होगा, उतना ही अधिक विवरण यह सुविधाओं से सीखेगा।
यदि आप अधिक सीखने में रुचि रखते हैं, तो मुझे यह पेपर मिला जो रैंडम फॉरेस्ट के साथ छवि वर्गीकरण पर चर्चा करता है।
पढ़ने के लिए धन्यवाद। कोई भी विचार और प्रतिक्रिया का स्वागत है!