हम में से बहुत से लोग उन पॉप-अप्स के कारण नाराज और असहज महसूस करते हैं जो तब दिखाई देते हैं जब आप Google Chrome के माध्यम से किसी साइट तक पहुंचने का प्रयास करते हैं, जो आपसे पुष्टि करने के लिए कहता है कि आप मानव हैं या नहीं। एक बार के लिए यह पूछने के लिए सबसे मूर्खतापूर्ण बात लगती है, खासकर अगर यह बार-बार आपके चेहरे पर आ रहा है। वह CAPTCHA है, एक चुनौती-प्रतिक्रिया परीक्षण जो ब्राउज़र को यह निर्धारित करने की अनुमति देता है कि यह कोई मशीन नहीं है जो आपकी व्यक्तिगत खोजों में घुसने की कोशिश कर रही है। CAPTCHA स्पैम बॉट्स को इंटरनेट से दूर रखने और दुरुपयोग को रोकने का एक सामान्य सुरक्षात्मक उपाय बन गया है। लेकिन हाल के वर्षों में, CAPTCHA का विस्तार हुआ है और यह एक जटिल कार्य भी बन गया है जिसमें हमें तथाकथित प्रतिक्रिया चुनौती पर ध्यान केंद्रित करने की आवश्यकता होती है। आपका ब्राउज़र आपसे "मैं रोबोट नहीं हूँ" की पुष्टि करने के लिए क्यों कह रहा है? और यह एक कष्टप्रद और समय लेने वाली चुनौती में कैसे बदल गया? पढ़ें कि कैसे एक उपकरण जो स्पैम बॉट्स को हटाने के लिए शुरू हुआ था, अब मनुष्यों और मशीनों के बीच एक कठिन दौड़ बन गया है।
CAPTCHA क्या है?
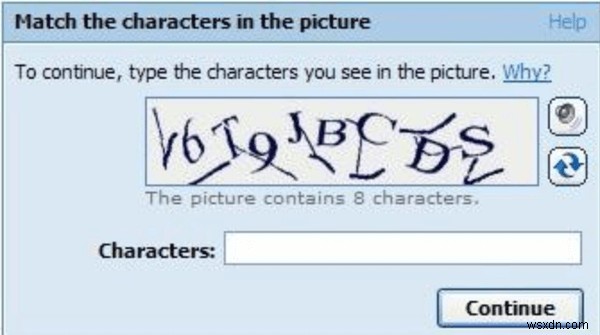
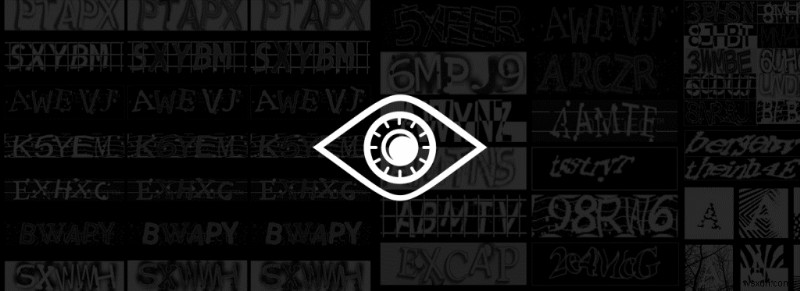
CAPTCHA का अर्थ है कम्प्लीटली ऑटोमेटेड पब्लिक ट्यूरिंग टेस्ट। इसे 2000 के दशक की शुरुआत में मनुष्यों के लिए एक परीक्षण के रूप में विकसित किया गया था ताकि यह साबित हो सके कि वे मशीन या स्पैम बॉट नहीं हैं जो ब्राउज़र सुरक्षा को भंग करने की कोशिश कर रहे हैं। हालांकि CAPTCHA का आविष्कार एक अन्य बहस का विषय है, इसका सबसे पहला संस्करण 1997 का है। जब इसका पहली बार उपयोग किया गया था, तो CAPTCHA उपयोगकर्ताओं से उनकी "मानवता" को सरल पाठ में विकृत अक्षरों के अनुक्रम को टाइप करके साबित करने के लिए कहता था। कुछ अनुक्रमों में, विकृत अक्षरों को समान विकृत प्रारूप में लिखी गई संख्याओं के साथ जोड़ा गया था। इन वर्णों को इस तरह लिखा गया था कि उनके बीच कोई जगह नहीं लगती थी और कोड हर लॉगिन प्रयास पर बदल जाता था। ऐसा इसलिए किया गया था क्योंकि, विकृत अनुक्रमों की लगभग अनंत संख्या को डीकोड करने के लिए, हमेशा कुछ मानव बुद्धि की आवश्यकता होगी; जबकि, एक कंप्यूटर मशीन एल्गोरिदम विकृत अनुक्रमों का पता नहीं लगा सकता। इस प्रकार, CAPTCHA को कई वेब और मेल सेवा प्रदाताओं द्वारा तुरंत अपनाया गया।
लेकिन फिर अगले कुछ वर्षों में, CAPTCHA जटिल हो गया।
Google का reCAPTCHA: मूल परीक्षण का एक जटिल उन्नयन
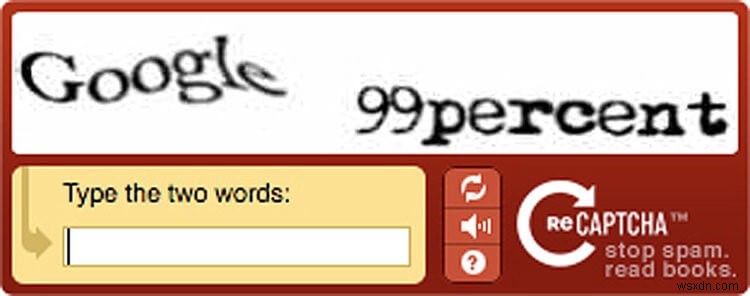
2007 में, Google ने मूल शोधकर्ताओं के एक समूह से reCAPTCHA नामक प्रोग्राम खरीदा और Google Scholar और Google Books में इसका बड़े पैमाने पर उपयोग करना शुरू कर दिया। लेकिन, जहां से यह शुरू हुआ था, CAPTCHA इस नवीनतम रूप में Google उपयोगकर्ताओं के लिए सिरदर्द बन गया। जैसे-जैसे मशीन लर्निंग पर शोध बढ़ा, वैसे-वैसे कंप्यूटिंग सिस्टम और उनके एल्गोरिदम की जटिल समस्याओं को हल करने की क्षमता भी बढ़ी। इस प्रकार, मूल वर्ण अनुक्रम बॉट्स और मशीनों के लिए हल करना बहुत आसान हो गए। इसलिए, Google आगे बढ़ा और उन वर्णों को अधिक घुमावदार और तकनीकी रूप से मानव आंख के लिए अधिक भ्रमित करने वाला बना दिया। इसने वास्तव में मानव और मशीन बुद्धि के बीच वास्तविक दौड़ शुरू कर दी, जो वास्तविक झुंझलाहट में बदल गई जो reCAPTCHA Google उपयोगकर्ताओं के लिए बन गई। यह सुनिश्चित करने के लिए कि Google प्लेटफॉर्म और खोजों तक पहुंचने वाला उपयोगकर्ता कोई बॉट नहीं है, Google ने अनुक्रमों को हल करना अधिक कठिन बना दिया।
परीक्षण में छवियों को जोड़ना: Google का नो CAPTCHA reCAPTCHA
2014 में, Google द्वारा reCaptcha का अधिग्रहण करने के बहुत देर बाद, इसने अपने अनुक्रमों के कारण उपयोगकर्ताओं को हो रही झुंझलाहट पर कार्रवाई करने का फैसला किया। साथ ही, इन सभी वर्षों में, एक बार फिर शोधकर्ताओं ने प्रतिक्रिया चुनौतियों को समझने की reCAPTCHA की क्षमताओं को पीछे छोड़ते हुए होशियार मशीनें बनाने के लिए। एक प्रयोगात्मक परीक्षण में, Google शोधकर्ताओं ने निर्धारित किया कि अत्यधिक जटिलताओं और कष्टप्रद पॉपअप के बावजूद, मशीन लर्निंग एल्गोरिदम 99 प्रतिशत से अधिक प्रतिक्रियाओं को सही ढंग से प्राप्त करने में सक्षम थे जबकि हम मनुष्य बमुश्किल 33 प्रतिशत प्रबंधित कर पाए। इसलिए, बदलाव का समय आ गया था।

Google ने उपयोगकर्ताओं की झुंझलाहट को दूर करने का फैसला किया। नए "नो CAPTCHA reCAPTCHA" ने उपयोगकर्ताओं को केवल टिक बॉक्स पर क्लिक करके परीक्षण पास करने की अनुमति दी। इस बार Google API तकनीक के साथ आगे बढ़ा और यह निर्धारित करने के लिए उपयोगकर्ता प्राथमिकताओं का उपयोग किया कि यह मानव है या रोबोट। Google का नया reCAPTCHA उपयोगकर्ता खोजों के साथ-साथ माउस कर्सर की गति का विश्लेषण करता है। एक बॉट माउस क्लिक का अनुकरण नहीं कर सकता क्योंकि एक बॉट के लिए, उस विशेष CAPTCHA परीक्षण के कोड का विश्लेषण करने पर वह वर्चुअल टिक बॉक्स को एक ग्राफिक छवि के रूप में देखेगा, और उस पर प्रतिक्रिया नहीं देगा। लेकिन फिर, अगर एक बॉट जावास्क्रिप्ट पढ़ सकता है, तो वह आसानी से उसका अनुकरण कर सकता है और माउस मूवमेंट ट्रैकिंग विकल्प विफल हो जाएगा।
तो आप उस मुद्दे को कैसे सही करेंगे? और, क्या होगा यदि आपने अपनी प्राथमिकताओं से अलग खोज की?

खैर, उस स्थिति में, एक और परीक्षण में आपका स्वागत है। Google का नया reCAPTCHA आपको "आई-टेस्ट" की एक श्रृंखला में ले जाता है यह देखने के लिए कि आप मानव हैं या रोबोट। इसलिए, यदि आप एक असंदर्भित या संदिग्ध खोज करते हैं, तो Google आपसे उनमें से कुछ विशिष्ट छवियों को चुनने के लिए कहेगा। हम सभी ने देखा है कि Google हमसे ट्रैफिक लाइट, कार, पार्क, या सड़क के संकेतों वाली तस्वीरों की पहचान करने के लिए कहता है, है ना? यही नो CAPTCHA reCAPTCHA है।
यह CAPTCHA का सबसे अद्यतन और सबसे व्यापक रूप से उपयोग किया जाने वाला संस्करण है, जिसे न केवल Google द्वारा बल्कि ट्विटर, फेसबुक, और क्रेगलिस्ट जैसे प्लेटफार्मों द्वारा उपयोगकर्ताओं के सोशल मीडिया प्रोफाइल के स्पैम और दुरुपयोग को रोकने के लिए मानव-AI भेद के माध्यम के रूप में उपयोग किया जाता है। लेकिन एक बार फिर, इस संस्करण में तस्वीरें मानव आंखों के लिए धुंधली हो गई हैं, पहेली की जटिलता बढ़ गई है, और फिर से वही रास्ता पार कर लिया है जो reCAPTCHA पहले गया था।
लेकिन क्यों?
CAPTCHA पहेलियाँ इतनी जटिल क्यों हैं?
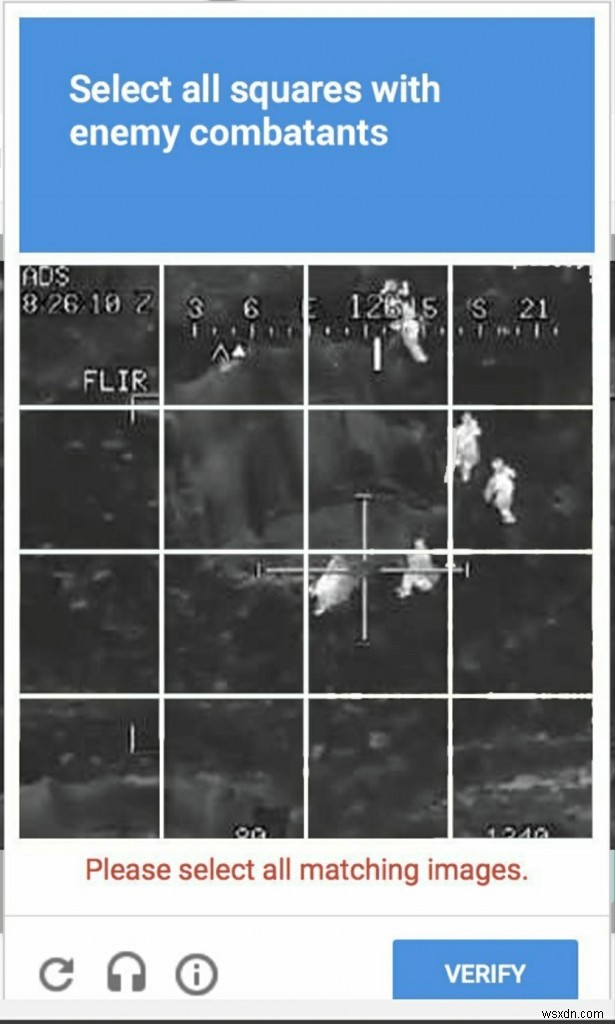
CAPTCHA की शुरुआत बॉट्स और मशीनों को मानव उपयोगकर्ता के रूप में अनुकरण करने और किसी भी प्रकार के डेटा को गलत तरीके से एक्सेस करने से रोकने के लिए एक माध्यम के रूप में हुई थी। लेकिन जैसे-जैसे मशीन लर्निंग और आर्टिफिशियल इंटेलिजेंस पर शोध और प्रयोग बहुत आगे बढ़ गए और यहां तक कि सफल भी हुए, हमने जटिल गणनाओं और CAPTCHA को हल करने में सक्षम मशीनें बनाईं, जो एक केक का टुकड़ा बन गईं। विज्ञान ने मशीन को इतनी व्यापक क्षमताएं दीं कि अब अगर हम सॉफ्टवेयर या बॉट के लिए कुछ कठिन बनाने की कोशिश करते हैं, तो यह मानव के लिए डीकोड करना कठिन हो जाएगा।
क्या यह बहुत आश्चर्य की बात है कि CAPTCHA किसी तरह विफल हो रहा है?
बिल्कुल नहीं। हमने कार्यात्मक क्वांटम कंप्यूटर बनाए हैं। हमने वित्तीय विश्लेषण, व्यावसायिक निर्णय, और चिकित्सा विज्ञान के संबंध में सैकड़ों पहेलियों और गणना समस्याओं को हल किया है। हमने अपने जीवन को आसान बनाने और अधिक जटिल शोध क्षेत्रों में हमारी मदद करने के लिए टन मशीन-आधारित एप्लिकेशन और टूल्स का उपयोग किया है। और इस बीच, हमने मशीनों को कार्य गति और दक्षता बढ़ाने के लिए अपनी बुद्धि दी है। चूंकि हमारा जीवन AI और मशीन लर्निंग पर इतना निर्भर है, यह केवल समय की बात थी कि यह हमें पार कर जाए।
CAPTCHA कितनी दूर तक जा सकता है?
शोधकर्ता इस प्रतिक्रिया-चुनौती तंत्र के साथ जो कर रहे हैं, उसके अनुसार, यह सिर्फ शुरुआत है। वर्तमान CAPTCHA टूल्स को अपग्रेड करने और इन प्रतिक्रिया चुनौती-परीक्षणों के संचालन के तरीके को बदलने के लिए विभिन्न परीक्षण किए गए हैं। 2017 में, पेपैल ने एक नए प्रकार की CAPTCHA तकनीक पर पेटेंट प्राप्त किया। यहां, एक उपयोगकर्ता से उसकी मानवता साबित करने के लिए पूछे जाने वाले पहेलियों और प्रश्न उनकी जातीयता, स्थान और लिंग के अनुसार भिन्न होंगे। इसी तरह, अमेज़ॅन टेक्नोलॉजीज ने एक CAPTCHA पहेली शैली का पेटेंट कराया, जहां लोगों को ऑप्टिकल इल्यूजन और विशिष्ट तर्क पहेलियों को हल करने के लिए कहा जाएगा, जो उनके लिए अपरिचित होंगी। अब, यहां अमेज़ॅन ने पहेली को उलटने की कोशिश की। अमेज़ॅन टेक्नोलॉजीज ने दावा किया कि अधिकांश मनुष्य ऐसी प्रतिक्रियाओं को गलत पाएंगे, जबकि आधुनिक AI, अपनी क्षमताओं को देखते हुए, इसे सही करेगा, और इसलिए गलत प्रतिक्रिया वाला उपयोगकर्ता मानव उपयोगकर्ता होगा। अन्य पेटेंट में CAPTCHA के लिए गेम-जैसी पहेली शामिल है, जहां उपयोगकर्ताओं को अपनी मानवता साबित करने के लिए बोर्ड पहेली प्रकार की छवियों को हल करने की आवश्यकता होगी। ये कुछ प्रारंभिक विचार हैं जो CAPTCHA को अपडेट करने का रास्ता बना रहे हैं।
लेकिन, क्या वे वास्तव में प्रभावी हैं?
कई मायनों में, वे नहीं हैं। सबसे पहले, इस "स्पेस-एज" पीढ़ी में जहां मशीन लर्निंग सचमुच मानव विकास में अगला कदम है, कोई CAPTCHA अटूट नहीं रहेगा। -दूसरे, ये विचार मनुष्यों के लिए बहुत जटिल हैं। यदि आप एक व्यक्ति से सांस्कृतिक रूप से विविध प्रश्न का सही उत्तर हर समय देने की उम्मीद करते हैं, तो आप गलत हैं। लोग जातीयता, भाषा, और व्यक्तित्व में बहुत बड़े पैमाने पर एक-दूसरे से भिन्न होते हैं और सांस्कृतिक पृष्ठभूमि पर आधारित प्रतिक्रिया-चुनौतियों का इतना व्यापक सेट विकसित करना लगभग असंभव है। इसके अलावा, इंटरनेट कुछ ऐसा है, जो किसी भी व्यक्ति के IQ, उम्र, और बुद्धि स्तर की परवाह किए बिना किसी के द्वारा कहीं से भी पहुंच योग्य है। इसलिए, यह विश्वास करना कठिन है कि हर उम्र के हर व्यक्ति में बोर्ड गेम पहेली को हल करके एक वेब पेज पास करने की क्षमता होगी। शायद, शोधकर्ता, मशीन हस्तक्षेप के खिलाफ प्रतिरोध को बनाए रखने के लिए भूल गए हैं कि इंसान होना कैसा लगता है और हाल के विकास से उस कारक को हटा दिया है।
CAPTCHA को अधिक विश्वसनीय बनाने के लिए क्या किया जा सकता है?
खैर, यह एक महान चर्चा और शोध का विषय है इससे पहले कि हम कुछ ऐसा लेकर आ सकें जो इसे मनुष्यों के लिए आसान बना दे। हालांकि, मानव व्यवहार के कुछ पहलू को देखने की आवश्यकता है जो AI बॉट के लिए अनुकरण करना असंभव हो। वेबपेज "कार्यों" को देखने वाले CAPTCHA टूल विकसित करने पर अधिक ध्यान केंद्रित किया जा सकता है। Google ने हाल ही में अपने reCAPTCHA के संस्करण 3 को सक्रिय किया जिसे reCAPTCHA v3 कहा जाता है। Google द्वारा प्रतिक्रिया-चुनौती परीक्षण का नया संस्करण "अनुकूली जोखिम विश्लेषण" नामक का उपयोग करता है, जो उपयोगकर्ताओं को किसी भी प्रकार के परीक्षण में नहीं धकेलता और उनसे वर्चुअल बॉक्स पर टिक करने के लिए नहीं कहता। यह उपयोगकर्ताओं के लिए पूरी तरह से घर्षण-मुक्त है और उन्हें सीधे वेबपेज तक पहुंचने की अनुमति देता है। बॉट पहचान करने के लिए स्पैम दुरुपयोग को रोकने के लिए, Google का नया reCAPTCHA वेबसाइट मालिकों को यह निर्धारित करने की अनुमति देगा कि उनकी साइट के उपयोगकर्ता बॉट हैं या नहीं, उन स्कोर के माध्यम से जो Google उन्हें अपने जोखिम विश्लेषण एल्गोरिदम के आधार पर देगा। स्कोर पता लगाएगा कि साइट पर ट्रैफिक संदिग्ध है या नहीं। मालिक तब संदिग्ध उपयोगकर्ताओं को प्रतिक्रिया परीक्षण के साथ प्रस्तुत कर सकते हैं ताकि reCAPTCHA के पता लगाने की पुष्टि की जा सके। जबकि Google यह नहीं बताएगा कि उनका नया एल्गोरिदम उपयोगकर्ताओं को ये स्कोर कैसे असाइन करेगा, इसे ट्रैफ़िक फ़िल्टर करने के एक स्वागत योग्य माध्यम के रूप में माना जा सकता है, जहां उपयोगकर्ताओं की झुंझलाहट और पहले के परीक्षणों को हल करने में कठिनाई पर विचार किया गया है।
अंतिम राय
यह कहना बहुत जल्दी होगा कि Google का नया reCAPTCHA v3 वेबपेज पर बॉट ट्रैफ़िक से बचने का सबसे अच्छा और सबसे उपयोगकर्ता-अनुकूल तरीका है। इसके अलावा, जिस गति से AI और मशीन लर्निंग अनुसंधान आगे बढ़ रहे हैं, हम किसी भी नई CAPTCHA तकनीक पर होने वाले निहितार्थों को नहीं जान सकते।
चूंकि लोग मशीन गतिविधियों पर निगरानी के बजाय मशीन लर्निंग पर अधिक दांव लगा रहे हैं, इन सभी नए CAPTCHA तकनीकों के पेटेंट निकट भविष्य में गैर-व्यवहार्य हो सकते हैं। फिलहाल, CAPTCHA वेब पर बॉट पहचान के लिए सबसे व्यापक रूप से उपयोग किया जाने वाला प्रतिक्रिया-चुनौती परीक्षण बना हुआ है। लेकिन इसे और अधिक वर्षों तक इस तरह रखने के लिए, यह महत्वपूर्ण है कि AI और मनुष्यों के बीच भेद के तरीके खोजे जाएं इससे पहले कि हम जो कुछ भी है और जो भी हमारी विरासत को परिभाषित करता है, उसे उन स्मार्ट मशीनों को सौंप दें जिन पर हम निर्भर हो रहे हैं।