संचार की एक कहानी
क्या आपने कभी सोचा है कि इंटरनेट वास्तव में कैसे बोलता है? एक कंप्यूटर इंटरनेट के माध्यम से दूसरे कंप्यूटर से कैसे "बात" करता है?
जब लोग एक दूसरे के साथ संवाद करते हैं, तो हम शब्दों का उपयोग करते हैं जो प्रतीत होता है सार्थक वाक्यों में बंधे होते हैं। वाक्य केवल इसलिए समझ में आते हैं क्योंकि हम इन वाक्यों के अर्थ पर सहमत हुए हैं। हमने, बोलने के लिए, संचार का एक प्रोटोकॉल परिभाषित किया है।
पता चला, कंप्यूटर इंटरनेट पर एक दूसरे से इसी तरह बात करते हैं। लेकिन, हम खुद से आगे निकल रहे हैं। लोग संवाद करने के लिए अपने मुंह का उपयोग करते हैं, आइए पहले पता लगाते हैं कि कंप्यूटर का मुंह क्या है।
सॉकेट में प्रवेश करें
सॉकेट कंप्यूटर साइंस में सबसे मौलिक अवधारणाओं में से एक है। आप सॉकेट्स का उपयोग करके इंटरकनेक्टेड डिवाइसेज़ के पूरे नेटवर्क बना सकते हैं।
कंप्यूटर साइंस में अन्य सभी चीजों की तरह, एक सॉकेट एक बहुत ही अमूर्त अवधारणा है। इसलिए, यह परिभाषित करने के बजाय कि सॉकेट क्या है, यह परिभाषित करना कहीं अधिक आसान है कि सॉकेट क्या करता है।
तो, सॉकेट क्या करता है? यह दो कंप्यूटर्स को एक दूसरे के साथ संवाद करने में मदद करता। यह यह कैसे करता है? इसके दो मेथड्स परिभाषित हैं, send() और recv() भेजने और प्राप्त करने के लिए क्रमशः।
ठीक है, यह सब बढ़िया है, लेकिन send() और recv() वास्तव में क्या भेजते और प्राप्त करते हैं? जब लोग अपने मुंह को हिलाते हैं, तो वे शब्दों का आदान-प्रदान करते हैं। जब सॉकेट अपने मेथड्स का उपयोग करते हैं, तो वे बिट्स और बाइट्स का आदान-प्रदान करते हैं।
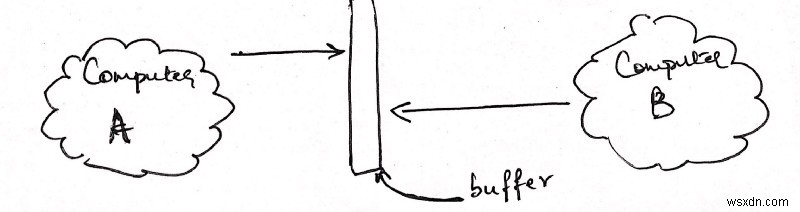
आइए एक उदाहरण के साथ मेथड्स को स्पष्ट करें। मान लें हमारे पास दो कंप्यूटर हैं, A और B। कंप्यूटर A कंप्यूटर B से कुछ कहने की कोशिश कर रहा है। इसलिए, कंप्यूटर B यह सुनने की कोशिश कर रहा है कि कंप्यूटर A क्या कह रहा है। यहां बताया गया है कि यह कैसा दिखेगा।
बफर पढ़ना
थोड़ा अजीब लगता है, है ना? एक के लिए, दोनों कंप्यूटर बीच में एक बार की ओर इशारा कर रहे हैं, जिसका शीर्षक 'बफर' है।
बफर क्या है? बफर एक मेमोरी स्टैक है। यह वह जगह है जहां प्रत्येक कंप्यूटर का डेटा संग्रहीत होता है, और कर्नेल द्वारा आवंटित किया जाता है।
अगला, वे दोनों एक ही बफर की ओर क्यों इशारा कर रहे हैं? खैर, यह पूरी तरह से सटीक नहीं है। प्रत्येक कंप्यूटर का अपना बफर होता है जो उसके अपने कर्नेल द्वारा आवंटित किया जाता है और नेटवर्क दोनों अलग-अलग बफर्स के बीच डेटा ट्रांसपोर्ट करता है। लेकिन, मैं यहां नेटवर्क विवरण में नहीं जाना चाहता, इसलिए हम मान लेंगे कि दोनों कंप्यूटर्स की "कहीं शून्य में" रखे गए एक ही बफर तक पहुंच है।
ठीक है, अब जब हम जानते हैं कि यह दृश्य रूप से कैसा दिखता है, आइए इसे कोड में अमूर्त करें।
#Computer A डेटा भेजता है computerA.send(data) #Computer B डेटा प्राप्त करता है computerB.recv(1024)यह कोड स्निपेट वही काम करता है जो ऊपर की छवि दर्शाती है। एक जिज्ञासा के अलावा, हम computerB.recv(data) नहीं कहते। इसके बजाय, हम डेटा के स्थान पर एक प्रतीत होता है यादृच्छिक संख्या निर्दिष्ट करते हैं।
कारण सरल है। नेटवर्क पर डेटा बिट्स में प्रसारित होता है। इसलिए, जब हम computerB में recv करते हैं, तो हम उन बिट्स की संख्या निर्दिष्ट करते हैं जिन्हें हम किसी एक समय में प्राप्त करने के इच्छुक हैं।
मैंने एक बार में प्राप्त करने के लिए 1024 बाइट्स क्यों चुना? कोई विशेष कारण नहीं। आमतौर पर 2 की घात में प्राप्त होने वाले बाइट्स की संख्या निर्दिष्ट करना सबसे अच्छा होता है। मैंने 1024 चुना जो 2¹⁰ है।
तो, बफर इसका पता कैसे लगाता है? खैर, कंप्यूटर A उसके साथ संग्रहीत जो भी डेटा है उसे बफर में लिखता या भेजता है। कंप्यूटर B उस बफर में संग्रहीत पहले 1024 बाइट्स को पढ़ने या प्राप्त करने का फैसला करता है।
बहुत बढ़िया! लेकिन, ये दो कंप्यूटर एक दूसरे से बात करना कैसे जानते हैं? उदाहरण के लिए, जब कंप्यूटर A इस बफर में लिखता है, तो यह कैसे जानता है कि कंप्यूटर B इसे उठाने जा रहा है? इसे दोबारा कहें, यह कैसे सुनिश्चित कर सकता है कि दो कंप्यूटर्स के बीच एक कनेक्शन का एक यूनिक बफर है?
IPs में पोर्टिंग
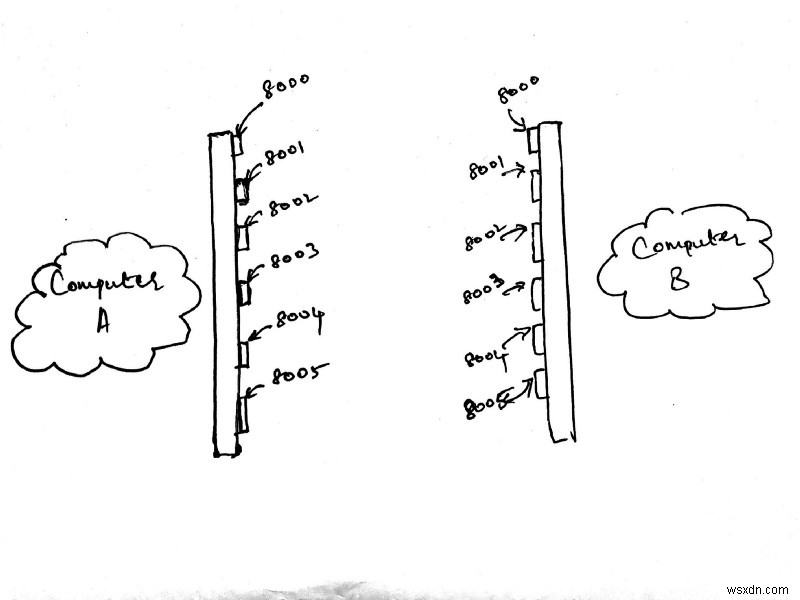
ऊपर की छवि वही दो कंप्यूटर दिखाती है जिन पर हम पूरे समय काम कर रहे हैं, एक और विवरण के साथ। प्रत्येक कंप्यूटर के सामने एक बार की लंबाई के साथ कई नंबर सूचीबद्ध हैं।
प्रत्येक कंप्यूटर के सामने लंबे बार को उस राउटर पर विचार करें जो एक विशिष्ट कंप्यूटर को इंटरनेट से जोड़ता है। उन बार्स पर सूचीबद्ध नंबर पोर्ट्स कहलाते हैं। आपके कंप्यूटर पर अभी हजारों पोर्ट्स उपलब्ध हैं। प्रत्येक पोर्ट एक सॉकेट कनेक्शन की अनुमति देता है। मैंने ऊपर की छवि में केवल 6 पोर्ट्स दिखाए हैं, लेकिन आपको आइडिया मिल गया होगा।
255 से नीचे के पोर्ट्स आमतौर पर सिस्टम कॉल्स और निम्न-स्तरीय कनेक्शन के लिए आरक्षित होते हैं। आमतौर पर 4-अंकों की उच्च संख्या जैसे 8000 पर एक कनेक्शन खोलना उचित होता है। मैंने ऊपर की छवि में बफर नहीं खींचा है, लेकिन आप मान सकते हैं कि प्रत्येक पोर्ट का अपना बफर होता है।
बार का अपना एक नंबर भी होता है। इस नंबर को IP एड्रेस कहा जाता है। IP एड्रेस के साथ कई पोर्ट्स जुड़े होते हैं। इसे निम्न तरीके से सोचें:
127.0.0.1 / | \ / | \ / | \ 8000 8001 8002बहुत बढ़िया, आइए कंप्यूटर A और कंप्यूटर B के बीच एक विशिष्ट पोर्ट पर एक कनेक्शन सेट करें।
# computerA.py import socket computerA = socket.socket() # localhost:8000 से कनेक्ट हो रहा है computerA.connect(('127.0.0.1', 8000)) string = 'abcd' encoded_string = string.encode('utf-8') computerA.send(encoded_string)यहां computerB.py के लिए कोड है
# computerB.py import socket computerB = socket.socket() # localhost:8000 पर सुन रहा है computerB.bind(('127.0.0.1', 8000)) computerB.listen(1) client_socket, address = computerB.accept() data = client_socket.recv(2048) print(data.decode('utf-8'))ऐसा लगता है कि हम कोड के मामले में थोड़ा आगे कूद गए हैं, लेकिन मैं इसके माध्यम से कदम रखूंगा। हम जानते हैं कि हमारे पास दो कंप्यूटर हैं, A और B। इसलिए, हमें एक को डेटा भेजने और एक को डेटा प्राप्त करने की आवश्यकता है।
मैंने मनमाने ढंग से A को डेटा भेजने और B को डेटा प्राप्त करने के लिए चुना है। इस लाइन में computerA.connect((‘127.0.0.1’, 8000), मैं कंप्यूटर A को IP एड्रेस 127.0.0.1 पर पोर्ट 8000 से कनेक्ट कर रहा हूं।
नोट: 127.0.0.1 आमतौर पर लोकलहोस्ट का मतलब है, जो आपकी मशीन को संदर्भित करता है
फिर, कंप्यूटर B के लिए, मैं इसे IP एड्रेस 127.0.0.1 पर पोर्ट 8000 पर बाइंड कर रहा हूं। अब, आप शायद सोच रहे हैं कि दो अलग-अलग कंप्यूटर्स के लिए मेरे पास वही IP एड्रेस क्यों है।
ऐसा इसलिए है क्योंकि मैं धोखा दे रहा हूं। मैं यह दिखाने के लिए एक कंप्यूटर का उपयोग कर रहा हूं कि आप सॉकेट्स का उपयोग कैसे कर सकते हैं (मैं मूल रूप से सादगी के लिए एक ही कंप्यूटर से और उसी से कनेक्ट कर रहा हूं)। आमतौर पर दो अलग-अलग कंप्यूटर्स के दो अलग-अलग IP एड्रेस होंगे।
हम पहले से ही जानते हैं कि केवल बिट्स को डेटा पैकेट के हिस्से के रूप में भेजा जा सकता है, इसलिए हम इसे भेजने से पहले स्ट्रिंग को एन्कोड करते हैं। इसी तरह, हम कंप्यूटर B पर स्ट्रिंग को डिकोड करते हैं। यदि आप स्थानीय रूप से उपरोक्त दो फ़ाइलों को चलाने का निर्णय लेते हैं, तो पहले computerB.py फ़ाइल चलाना सुनिश्चित करें। यदि आप पहले computerA.py फ़ाइल चलाते हैं, तो आपको कनेक्शन रिफ्यूज्ड त्रुटि मिलेगी।
क्लाइंट्स की सेवा
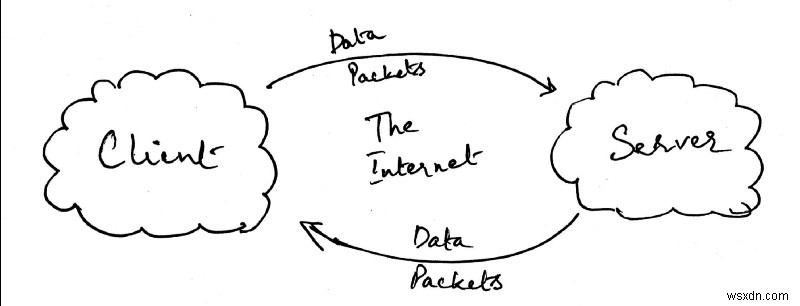
मुझे यकीन है कि आप में से कई के लिए यह बहुत स्पष्ट रहा है कि मैं अब तक जो वर्णन कर रहा हूं वह एक बहुत ही सरल क्लाइंट-सर्वर मॉडल है। वास्तव में आप देख सकते हैं कि ऊपर की छवि से, मैंने कंप्यूटर A को क्लाइंट और कंप्यूटर B को सर्वर से बदल दिया है।
क्लाइंट्स और सर्वर्स के बीच संचार की एक निरंतर धारा चलती रहती है। हमारे पूर्व कोड उदाहरण में, हमने डेटा ट्रांसफर का एक शॉट वर्णित किया। इसके बजाय, हम चाहते हैं कि क्लाइंट से सर्वर को डेटा की एक निरंतर धारा भेजी जाए। हालांकि, हम यह भी जानना चाहते हैं कि वह डेटा ट्रांसफर कब पूरा होता है, ताकि हम जान सकें कि हम सुनना कब बंद कर सकते हैं।
आइए इसे आगे जांचने के लिए एक सादृश्य का उपयोग करें। दो लोगों के बीच निम्नलिखित बातचीत की कल्पना करें।
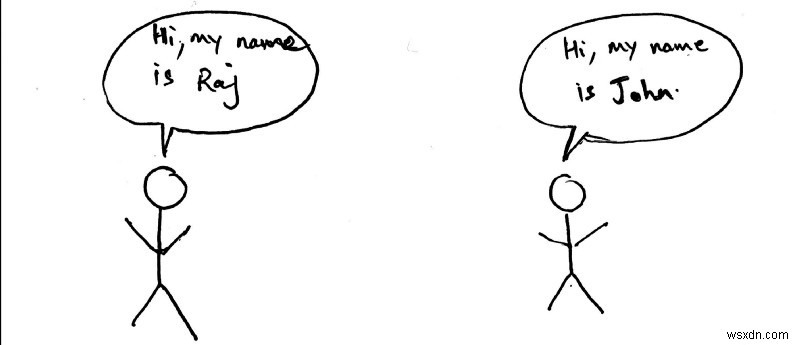
दो लोग अपना परिचय देने की कोशिश कर रहे हैं। हालांकि, वे एक ही समय में बात करने की कोशिश नहीं करेंगे। मान लें कि राज पहले जाता है। जॉन तब तक इंतजार करेगा जब तक राज अपना परिचय समाप्त नहीं कर लेता इससे पहले कि वह अपना परिचय देना शुरू करे। यह कुछ सीखी हुई ह्यूरिस्टिक्स पर आधारित है लेकिन हम आम तौर पर उपरोक्त को प्रोटोकॉल के रूप में वर्णित कर सकते हैं।
हमारे क्लाइंट्स और सर्वर्स को एक समान प्रोटोकॉल की आवश्यकता है। अन्यथा, उन्हें कैसे पता चलेगा कि डेटा के पैकेट भेजने की उनकी बारी कब है?
हम इसे स्पष्ट करने के लिए कुछ सरल करेंगे। मान लें हम कुछ डेटा भेजना चाहते हैं जो स्ट्रिंग्स की एक सरणी होती है। मान लें सरणी इस प्रकार है:
arr = ['random', 'strings', 'that', 'need', 'to', 'be', 'transferred', 'across', 'the', 'network', 'using', 'sockets']
उपरोक्त वह डेटा है जो क्लाइंट से सर्वर को लिखा जाने वाला है। आइए एक और बाधा बनाएं। सर्वर को उस डेटा को स्वीकार करने की आवश्यकता है जो उस स्ट्रिंग द्वारा कब्जा किए गए डेटा के बराबर है जो उस समय भेजा जाने वाला है।
तो, उदाहरण के लिए, यदि क्लाइंट स्ट्रिंग 'random' भेजने जा रहा है, और मान लें कि प्रत्येक कैरेक्टर 1 बाइट पर कब्जा करता है, तो स्ट्रिंग स्वयं 6 बाइट्स पर कब्जा करती है। 6 बाइट्स तब 6*8 = 48 बिट्स के बराबर है। इसलिए, सॉकेट्स पर क्लाइंट से सर्वर पर स्ट्रिंग 'random' को ट्रांसफर करने के लिए, सर्वर को यह जानने की आवश्यकता है कि उसे उस विशिष्ट डेटा पैकेट के लिए 48 बिट्स एक्सेस करना है।
यह समस्या को तोड़ने का एक अच्छा अवसर है। कुछ चीजें हैं जिन्हें हमें पहले समझने की आवश्यकता है।
पायथन में एक स्ट्रिंग द्वारा घिरे बाइट्स की संख्या कैसे पता करें?
खैर, हम स्ट्रिंग की लंबाई का पता लगाकर शुरू कर सकते हैं। यह आसान है, यह सिर्फ len() का कॉल है। लेकिन, हमें अभी भी एक स्ट्रिंग द्वारा घिरे बाइट्स की संख्या जानने की आवश्यकता है, न कि केवल लंबाई।
हम पहले स्ट्रिंग को बाइनरी में बदलेंगे, और फिर परिणामी बाइनरी प्रतिनिधित्व की लंबाई ढूंढेंगे। इससे हमें उपयोग किए गए बाइट्स की संख्या मिलनी चाहिए।
len(‘random’.encode(‘utf-8’)) हमें वह देगा जो हम चाहते हैं
प्रत्येक स्ट्रिंग द्वारा घिरे बाइट्स की संख्या को सर्वर को कैसे भेजें?
आसान, हम बाइट्स की संख्या (जो एक पूर्णांक है) को उस संख्या के बाइनरी प्रतिनिधित्व में बदल देंगे, और इसे सर्वर को भेज देंगे। अब, सर्वर स्ट्रिंग प्राप्त करने से पहले स्ट्रिंग की लंबाई प्राप्त करने की उम्मीद कर सकता है।
सर्वर को कैसे पता चलता है कि क्लाइंट ने सभी स्ट्रिंग्स भेजना समाप्त कर दिया है?
बातचीत की सादृश्यता से याद रखें, यह जानने का एक तरीका होना चाहिए कि डेटा ट्रांसफर पूरा हो गया है। कंप्यूटर्स अपने स्वयं के ह्यूरिस्टिक्स पर भरोसा नहीं कर सकते। इसलिए, हम एक यादृच्छिक नियम प्रदान करेंगे। हम कहेंगे कि जब हम स्ट्रिंग 'end' भेजते हैं, तो इसका मतलब है कि सर्वर ने सभी स्ट्रिंग्स प्राप्त कर ली हैं और अब कनेक्शन बंद कर सकता है। बेशक, इसका मतलब है कि हम अपनी सरणी के बहुत अंत को छोड़कर किसी अन्य हिस्से में स्ट्रिंग 'end' का उपयोग नहीं कर सकते।
यहां वह प्रोटोकॉल है जिसे हमने अब तक डिज़ाइन किया है:
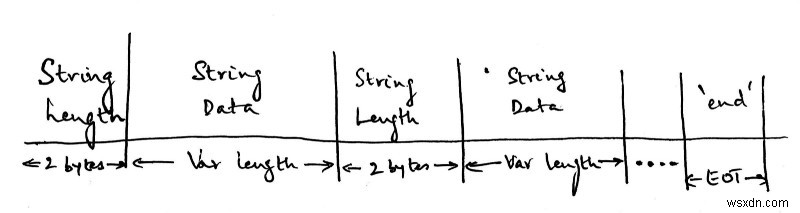
स्ट्रिंग की लंबाई 2 बाइट्स होगी, उसके बाद वास्तविक स्ट्रिंग होगी जिसकी लंबाई वेरिएबल होगी। यह पिछले पैकेट में भेजी गई स्ट्रिंग लंबाई पर निर्भर करेगा, और हम स्ट्रिंग लंबाई और स्ट्रिंग को स्वयं भेजने के बीच बारी-बारी से करेंगे। EOT का मतलब ट्रांसमिशन का अंत है, और स्ट्रिंग 'end' भेजने का मतलब है कि भेजने के लिए कोई और डेटा नहीं है।
नोट: जारी रखने से पहले, मैं एक बात बताना चाहता हूं। यह एक बहुत ही सरल और बेवकूफी भरा प्रोटोकॉल है। यदि आप देखना चाहते हैं कि एक अच्छी तरह से डिज़ाइन किया गया प्रोटोकॉल कैसा दिखता है, तो HTTP प्रोटोकॉल से आगे नहीं देखें।
आइए इसे कोड करें। मैंने नीचे दिए गए गिस्ट में टिप्पणियां शामिल की हैं ताकि यह स्व-व्याख्यात्मक हो।
बहुत बढ़िया, हमारे पास एक क्लाइंट चल रहा है। अगला, हमें सर्वर की आवश्यकता है।
मैं ऊपर दिए गए गिस्ट में कोड की कुछ विशिष्ट लाइनों की व्याख्या करना चाहता हूं। पहली, clientSocket.py फ़ाइल से।
len_in_bytes = (len_of_string).to_bytes(2, byteorder='little')
उपरोक्त एक संख्या को बाइट्स में बदलता है। to_bytes फ़ंक्शन को पास किया गया पहला पैरामीटर len_of_string को उसके बाइनरी प्रतिनिधित्व में बदलने के परिणाम के लिए आवंटित बाइट्स की संख्या है।
दूसरा पैरामीटर यह तय करने के लिए उपयोग किया जाता है कि लिटिल एंडियन फॉर्मेट का पालन करना है या बिग एंडियन फॉर्मेट का। आप इसके बारे में यहां और पढ़ सकते हैं। अभी के लिए, बस जान लें कि हम उस पैरामीटर के लिए हमेशा little के साथ रहेंगे।
अगली कोड लाइन जिसे मैं देखना चाहता हूं वह है:
client_socket.send(string.encode(‘utf-8’))
हम ‘utf-8’ एन्कोडिंग का उपयोग करके स्ट्रिंग को बाइनरी फॉर्मेट में बदल रहे हैं।
अगला, serverSocket.py फ़ाइल में:
data = client_socket.recv(2) str_length = int.from_bytes(data, byteorder='little')उपरोक्त कोड की पहली लाइन क्लाइंट से 2 बाइट्स डेटा प्राप्त करती है। याद रखें कि जब हमने clientSocket.py में स्ट्रिंग की लंबाई को बाइनरी फॉर्मेट में बदला, तो हमने परिणाम को 2 बाइट्स में संग्रहीत करने का फैसला किया। यही कारण है कि हम उसी डेटा के लिए यहां 2 बाइट्स पढ़ रहे हैं।
अगली लाइन में बाइनरी फॉर्मेट को पूर्णांक में बदलना शामिल है। यहां byteorder "little" है, ताकि क्लाइंट पर उपयोग किए गए byteorder से मेल खा सके।
यदि आप आगे बढ़ते हैं और दोनों सॉकेट्स चलाते हैं, तो आपको देखना चाहिए कि सर्वर उन स्ट्रिंग्स को प्रिंट करेगा जो क्लाइंट भेजता है। हमने संचार स्थापित किया!
निष्कर्ष
ठीक है, हमने अब तक काफी कुछ कवर किया है। अर्थात्, सॉकेट्स क्या हैं, हम उनका उपयोग कैसे करते हैं और एक बहुत ही सरल और बेवकूफी भरा प्रोटोकॉल कैसे डिज़ाइन करें। यदि आप सॉकेट्स कैसे काम करते हैं इसके बारे में अधिक जानना चाहते हैं, तो मैं Beej's Guide To Network Programming पढ़ने की अत्यधिक अनुशंसा करता हूं। उस ई-बुक में बहुत सारी बढ़िया चीजें हैं।
आप निश्चित रूप से इस लेख में अब तक पढ़ी गई बातों को ले सकते हैं, और इसे रास्पबेरी पाई कैमरे से अपने कंप्यूटर पर छवियों को स्ट्रीमिंग जैसी अधिक जटिल समस्याओं पर लागू कर सकते हैं। इसके साथ मज़े करें!
यदि आप चाहें, तो आप मुझे ट्विटर या GitHub पर फॉलो कर सकते हैं। आप मेरा ब्लॉग यहां भी देख सकते हैं। यदि आप मुझसे संपर्क करना चाहते हैं तो मैं हमेशा उपलब्ध हूं!
मूल रूप से https://redixhumayun.github.io/networking/2019/02/14/how-the-internet-speaks.html पर 14 फरवरी, 2019 को प्रकाशित।