GNU/लिनक्स वितरण में टेक्स्ट को संभालने के लिए प्रोग्राम का खजाना शामिल है, जिनमें से अधिकांश GNU कोर यूटिलिटीज द्वारा प्रदान किए जाते हैं। सीखने की अवस्था कुछ हद तक है, लेकिन सही ढंग से उपयोग किए जाने पर ये यूटिलिटीज बहुत उपयोगी और कुशल साबित हो सकती हैं।
यहां तेरह शक्तिशाली टेक्स्ट हेरफेर टूल हैं जिन्हें हर कमांड-लाइन उपयोगकर्ता को जानना चाहिए।
1. cat
Cat को फ़ाइलों को concatenate करने के लिए डिज़ाइन किया गया था लेकिन इसका उपयोग अक्सर एक फ़ाइल को प्रदर्शित करने के लिए किया जाता है। बिना किसी आर्गुमेंट के, cat Ctrl + D दबाए जाने तक मानक इनपुट पढ़ता है (टर्मिनल से या किसी अन्य प्रोग्राम आउटपुट से यदि पाइप का उपयोग कर रहे हैं)। मानक इनपुट को - के साथ स्पष्ट रूप से भी निर्दिष्ट किया जा सकता है।
Cat के कई उपयोगी विकल्प हैं, विशेष रूप से:
-Aप्रत्येक पंक्ति के अंत में "$" प्रिंट करता है और कैरट नोटेशन का उपयोग करके गैर-प्रिंटिंग वर्णों को प्रदर्शित करता है।-nसभी पंक्तियों को नंबर देता है।-bगैर-रिक्त पंक्तियों को नंबर देता है।-sखाली पंक्तियों की एक श्रृंखला को एक खाली पंक्ति तक कम करता है।
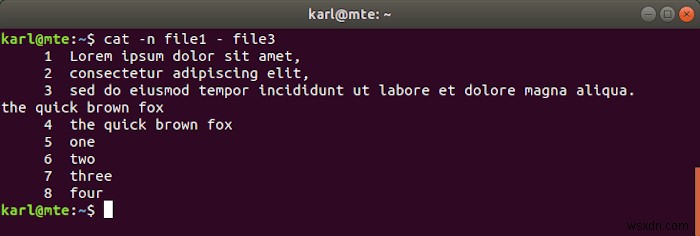
निम्न उदाहरण में, हम file1, मानक इनपुट, और file3 की सामग्री को जोड़ और नंबर दे रहे हैं।
cat -n file1 - file3
2. sort
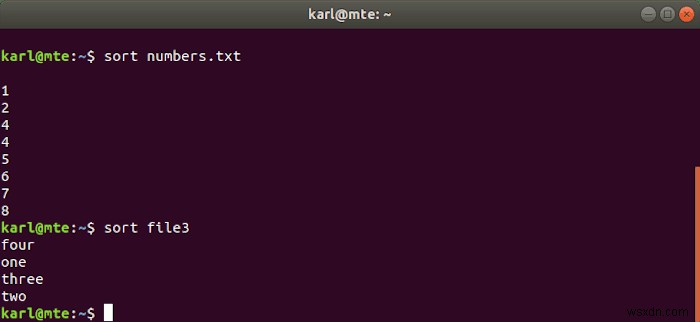
जैसा कि इसके नाम से पता चलता है, sort फ़ाइल सामग्री को वर्णानुक्रम और संख्यात्मक रूप से सॉर्ट करता है।
3. uniq
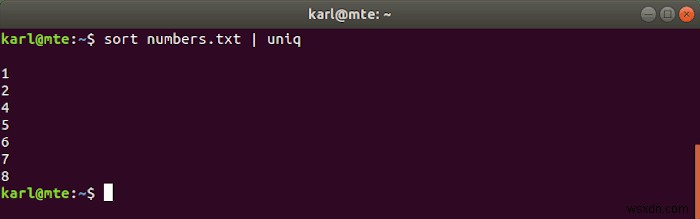
Uniq एक सॉर्ट की गई फ़ाइल लेता है और डुप्लिकेट पंक्तियों को हटा देता है। इसे अक्सर एक ही कमांड में sort के साथ जोड़ा जाता है।
4. comm
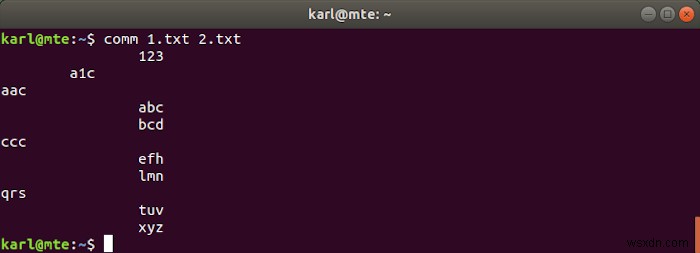
Comm दो सॉर्ट की गई फ़ाइलों की तुलना करने के लिए उपयोग किया जाता है, लाइन दर लाइन। यह तीन कॉलम आउटपुट करता है: पहले दो कॉलम में क्रमशः पहली और दूसरी फ़ाइल के लिए अद्वितीय पंक्तियाँ होती हैं, और तीसरा दोनों फ़ाइलों में पाए जाने वाले को प्रदर्शित करता है।
5. cut
Cut का उपयोग वर्णों, फ़ील्ड्स, या बाइट्स के आधार पर पंक्तियों के विशिष्ट खंडों को पुनः प्राप्त करने के लिए किया जाता है। यदि कोई फ़ाइल निर्दिष्ट नहीं है तो यह फ़ाइल से या मानक इनपुट से पढ़ सकता है।
वर्ण स्थिति के अनुसार काटना
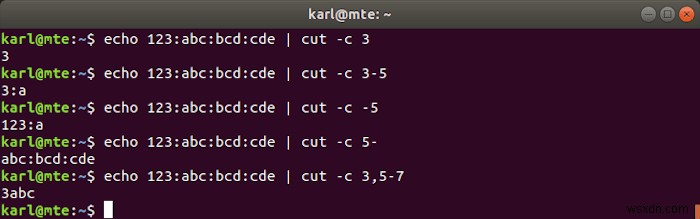
-c विकल्प एकल वर्ण स्थिति या वर्णों की एक या अधिक श्रेणियों को निर्दिष्ट करता है।
उदाहरण के लिए:
-c 3: तीसरा वर्ण।-c 3-5: तीसरे से पांचवें वर्ण तक।-c -5या-c 1-5: पहले से पांचवें वर्ण तक।-c 5-: पांचवें वर्ण से पंक्ति के अंत तक।-c 3,5-7: तीसरा और पांचवें से सातवें वर्ण तक।
फ़ील्ड के अनुसार काटना
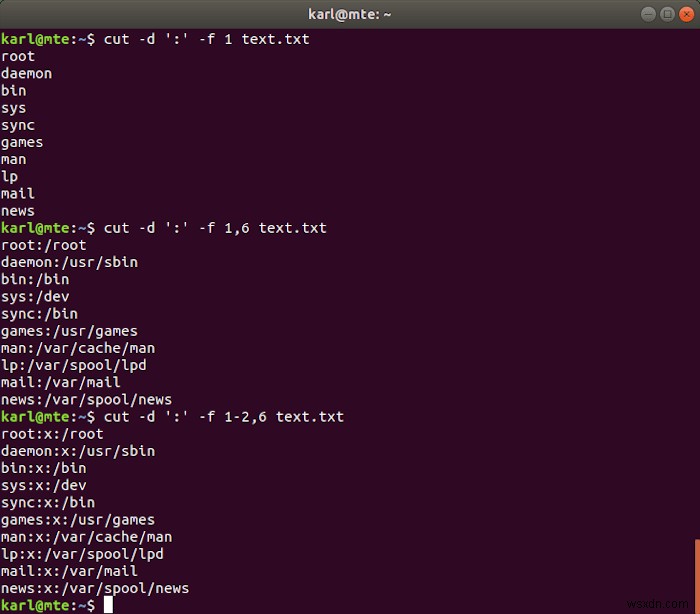
फ़ील्ड एक डिलीमीटर द्वारा अलग किए जाते हैं जिसमें एक वर्ण होता है, जिसे -d विकल्प के साथ निर्दिष्ट किया जाता है। -f विकल्प ऊपर दिए गए समान प्रारूप का उपयोग करके फ़ील्ड स्थिति या फ़ील्ड की एक या अधिक श्रेणियों का चयन करता है।
6. dos2unix
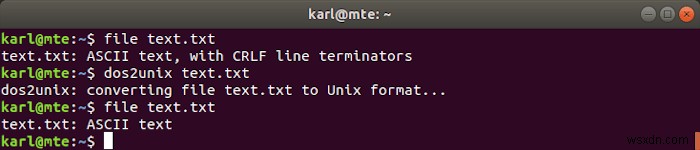
GNU/लिनक्स और यूनिक्स आमतौर पर टेक्स्ट लाइनों को लाइन फीड (LF) के साथ समाप्त करते हैं, जबकि विंडोज कैरिज रिटर्न और लाइन फीड (CRLF) का उपयोग करता है। लिनक्स पर CRLF टेक्स्ट को संभालते समय संगतता समस्याएं उत्पन्न हो सकती हैं, जहां dos2unix आता है। यह CRLF टर्मिनेटर को LF में परिवर्तित करता है।
निम्न उदाहरण में, dos2unix का उपयोग करने से पहले और बाद में टेक्स्ट फॉर्मेट की जांच के लिए file कमांड का उपयोग किया जाता है।
7. fold
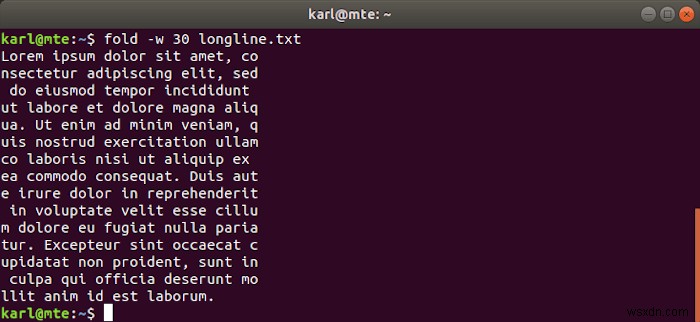
लंबी टेक्स्ट लाइनों को पढ़ने और संभालने में आसान बनाने के लिए, आप fold का उपयोग कर सकते हैं, जो लाइनों को निर्दिष्ट चौड़ाई में लपेटता है।
Fold डिफ़ॉल्ट रूप से निर्दिष्ट चौड़ाई से सख्ती से मेल खाता है, आवश्यकता पड़ने पर शब्दों को तोड़ता है।
fold -w 30 longline.txt
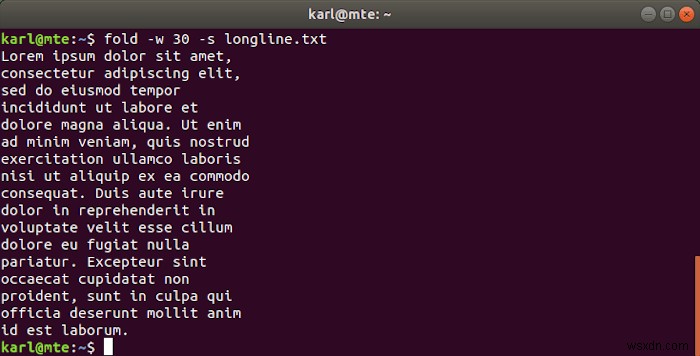
यदि शब्दों को तोड़ना अवांछनीय है, तो आप स्पेस पर ब्रेक करने के लिए -s विकल्प का उपयोग कर सकते हैं।
fold -w 30 -s longline.txt
8. iconv
यह टूल टेक्स्ट को एक एन्कोडिंग से दूसरे में परिवर्तित करता है, जो असामान्य एन्कोडिंग से निपटने पर बहुत उपयोगी होता है।
iconv -f input_encoding -t output_encoding -o output_file input_file
- "input_encoding" वह एन्कोडिंग है जिससे आप परिवर्तित कर रहे हैं।
- "output_encoding" वह एन्कोडिंग है जिसमें आप परिवर्तित कर रहे हैं।
- "output_file" वह फ़ाइल नाम है जिसे iconv सेव करेगा।
- "input_file" वह फ़ाइल नाम है जिसे iconv पढ़ेगा।
नोट: आप iconv -l के साथ उपलब्ध एन्कोडिंग सूचीबद्ध कर सकते हैं
9. sed
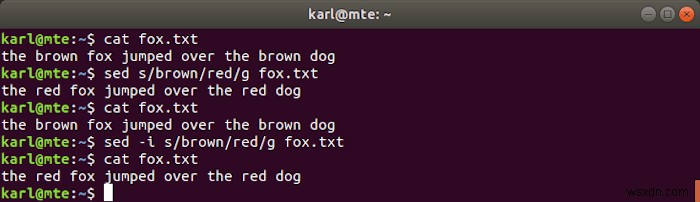
sed एक शक्तिशाली और लचीला stream editor है, जिसका उपयोग सबसे अधिक स्ट्रिंग खोजने और बदलने के लिए निम्नलिखित सिंटैक्स के साथ किया जाता है।
निम्न कमांड निर्दिष्ट फ़ाइल (या मानक इनपुट) से पढ़ेगा, नियमित अभिव्यक्ति पैटर्न से मेल खाने वाले टेक्स्ट के भागों को प्रतिस्थापन स्ट्रिंग से बदल देगा, और परिणाम को टर्मिनल पर आउटपुट करेगा।
sed s/pattern/replacement/g filename
मूल फ़ाइल को संशोधित करने के लिए, आप -i फ्लैग का उपयोग कर सकते हैं।
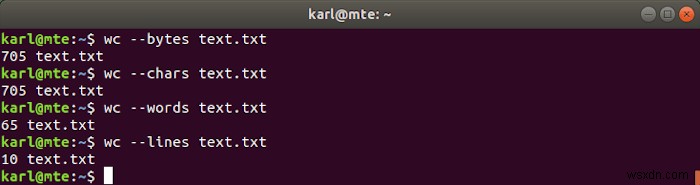
10. wc
wc यूटिलिटी एक फ़ाइल में बाइट्स, वर्णों, शब्दों, या पंक्तियों की संख्या प्रिंट करती है।
11. split
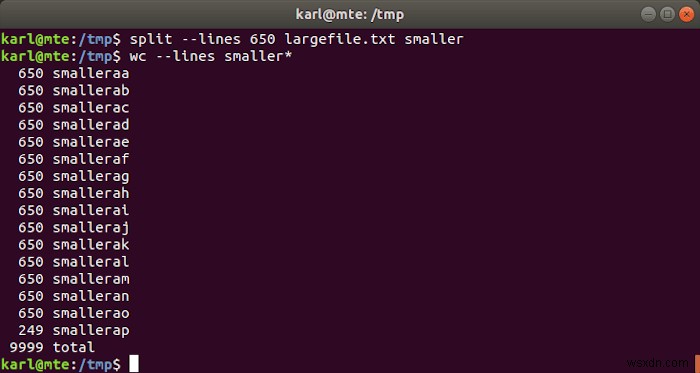
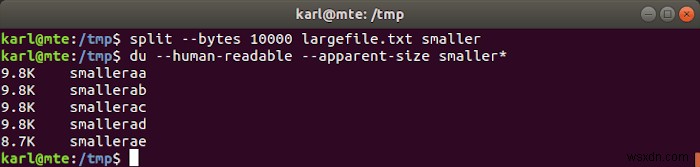
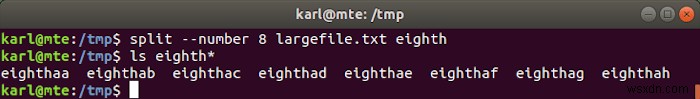
आप split का उपयोग करके किसी फ़ाइल को छोटी फ़ाइलों में विभाजित कर सकते हैं, पंक्तियों की संख्या के अनुसार, आकार के अनुसार, या फ़ाइलों की एक विशिष्ट संख्या में।
पंक्तियों की संख्या के अनुसार विभाजन
split -l num_lines input_file output_prefix
बाइट्स के अनुसार विभाजन
split -b bytes input_file output_prefix
फ़ाइलों की विशिष्ट संख्या में विभाजन
split -n num_files input_file output_prefix
12. tac
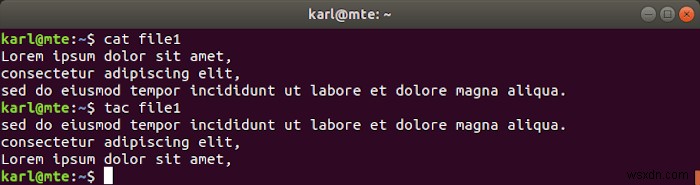
Tac, जो cat का उल्टा है, ठीक वही करता है: यह फ़ाइलों को पंक्तियों के उल्टे क्रम में प्रदर्शित करता है।
13. tr
tr टूल का उपयोग वर्णों के सेट का अनुवाद या हटाने के लिए किया जाता है।
वर्णों का एक सेट आमतौर पर या तो एक स्ट्रिंग या वर्णों की श्रेणियाँ होती हैं। उदाहरण के लिए:
- "A-Z": सभी अपरकेस अक्षर
- "a-z0-9": लोअरकेस अक्षर और अंक
- "\n[:punct:]": न्यूलाइन और विराम चिह्न वर्ण
अधिक विवरण के लिए tr मैनुअल पेज देखें।
एक सेट को दूसरे में अनुवाद करने के लिए, निम्नलिखित सिंटैक्स का उपयोग करें:
tr SET1 SET2
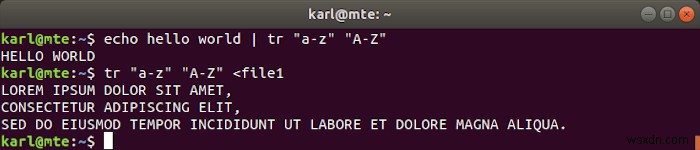
उदाहरण के लिए, लोअरकेस वर्णों को उनके अपरकेस समकक्ष से बदलने के लिए, आप निम्न का उपयोग कर सकते हैं:
tr "a-z" "A-Z"
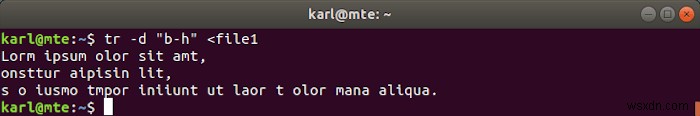
वर्णों के एक सेट को हटाने के लिए, -d फ्लैग का उपयोग करें।
tr -d SET
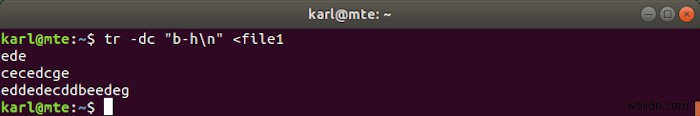
वर्णों के एक सेट के पूरक को हटाने के लिए (यानी सेट को छोड़कर सब कुछ), -dc का उपयोग करें।
tr -dc SET
निष्कर्ष
जब लिनक्स कमांड लाइन की बात आती है तो सीखने के लिए बहुत कुछ है। उम्मीद है, उपरोक्त कमांड आपको कमांड लाइन में टेक्स्ट से बेहतर ढंग से निपटने में मदद कर सकते हैं।